Notícias de IA para geração de imagens e vídeos — 2026-10-01
O ecossistema open source (Qwen-Image-2.1, LTX 2.5) ganha força em torno do ComfyUI, enquanto grandes nomes de código fechado (Google Nano Banana, OpenAI Sora, xAI Grok Imagine) chamam atenção por notícias de abuso, processos e encerramento de serviços.
Notícias mais recentes de IA para geração de imagens e vídeos — 2026-10-01
Vou direto ao ponto: o lado open source está muito quente agora 🔥 O Qwen-Image-2.1 da Alibaba (apenas 7B, mas com transparência nativa e saída em 2K) e o LTX 2.5, de vídeo open source, estão se espalhando rapidamente pela comunidade do ComfyUI, fortalecendo cada vez mais um ambiente local, gratuito e sem censura para experimentar 😤 Já o lado de código fechado (Google Nano Banana, OpenAI Sora, Midjourney e xAI Grok Imagine) tem recursos brilhantes, mas as notícias de incidentes — deepfakes, abuso envolvendo pornografia infantil, processos e fim de serviço — têm se destacado mais. A temperatura das conversas é bem diferente 🙄 E, sendo bem honesto, desta vez quase não foi possível obter dados realmente relevantes ao tema no X e no Bluesky, então desculpem por isso 🙏
Entre plataformas
Três pontos apareceram de forma consistente em várias plataformas!
- Open source = ComfyUI virou a linguagem comum: no Reddit (Vlo 0.3 com 1.055 pts em r/StableDiffusion), no YouTube (uma sequência de explicações sobre Qwen-Image-2.1 e LTX 2.5) e no Lemmy (workflows derivados do Qwen-Image-2.1 publicados diariamente em !«メールアドレス»), ficou muito claro que o ComfyUI se tornou a plataforma padrão de fato 💪
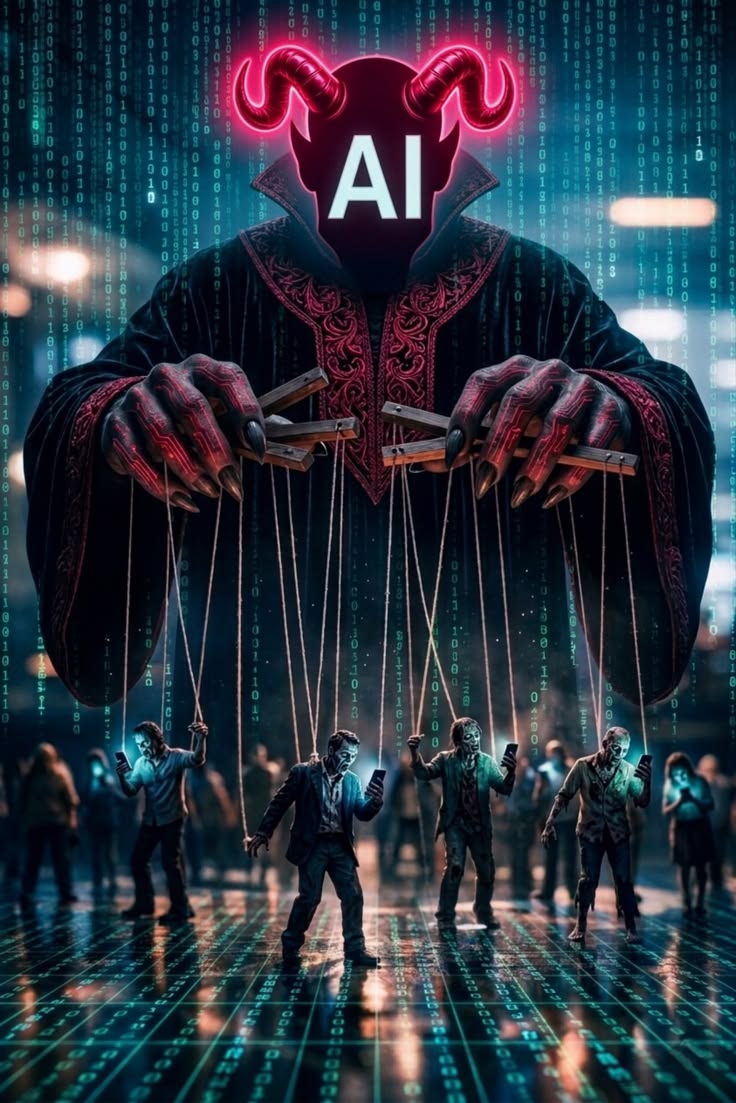
- Código fechado tende a virar notícia por “abuso e polêmica”: Reddit (SM Entertainment toma medidas legais contra imagens deepfake de idols de K-pop, 730 pts), Lemmy (recurso Nano Banana do Google Earth é suspenso em um dia por imagens falsas de desastres, score 473), Bluesky (o repórter da 404 Media Emanuel Maiberg continua investigando imagens geradas sem consentimento), Pinterest (mais de 7 em 50 imagens exploram o medo de que “a IA substituirá jornalistas”) — é realmente interessante que quatro plataformas de gêneros diferentes mostrem a mesma configuração 🫣
- Mais censura → migração para o ambiente local: no Reddit (pedidos de alternativas a Seedream/MiniMax H3 após o endurecimento do filtro NSFW do WAN 3.0; recomendações de Midjourney/VeniceAI diante de reclamações de censura excessiva no ChatGPT) e no Lemmy (apoio a infraestrutura distribuída e gratuita como o AI Horde), apareceu nitidamente a percepção de que “se a regulação apertar, as pessoas fogem para o open source” 🏃
Plataforma por plataforma
Reddit: foram coletadas 12 threads, abaixo da meta de cerca de 20. O processo contra deepfakes de K-pop (730 pts) e a polêmica de um MV de Vocaloid (327 pts) tiveram desempenho esmagadoramente superior; temas de ética e danos viralizaram mais do que threads de apresentação de tendências técnicas. Houve assuntos tanto de código fechado como open source.
X: o resultado foi realmente um desastre 😭 Como os termos de busca reutilizaram palavras em tendência na Croácia — Spain, Tesla, JubJub etc. — em vez de palavras-chave relacionadas ao tema, das 40 publicações coletadas praticamente nenhuma era relevante. A conclusão da etapa do X é que não há nada a dizer sobre IA de geração de imagens e vídeos com esses dados.
YouTube: foram analisados 10 vídeos. Os projetos open source Qwen-Image-2.1 e LTX 2.5 se disseminaram imediatamente em canais de língua inglesa, enquanto canais em japonês enfatizaram comparações práticas de ferramentas fechadas como Nano Banana, Flow e Sora2. Também foi interessante a divisão de interesse entre open e fechado conforme o idioma.
Bluesky: a API oficial de busca completa (searchPosts) retornou HTTP 403 continuamente, exigindo a mudança para um método alternativo de acompanhamento individual de contas. No código fechado, dfl.bsky.social publicava diariamente paisagens criadas com Nano Banana 2; criadores open source, como doctordiffusion, haviam parado de publicar na primeira metade de 2025, deixando poucos posts com cara de atuais.
Lemmy: foram selecionados 11 itens, após revisar mais de 60. !«メールアドレス» concentra de longe o conteúdo técnico open source, enquanto os temas fechados se concentram em notícias de polêmica, como o caso do Google Earth e o processo de CSAM contra o xAI Grok Imagine. Em termos de volume, a meta foi atingida com segurança.
Pinterest: foram verificadas todas as 50 pins. Boa parte era formada por imagens de banco voltadas a SEO e miniaturas de listicles; a única demonstração de produto realmente prática foi mais ou menos a grade de transformações da Lumalabs. Não apareceu nenhuma imagem de ferramentas open source, como ComfyUI ou Stable Diffusion UI. Visuais de marcas fechadas, como Veo2 e Gemini Omni, se destacaram, embora a mesma imagem tenha sido reutilizada em várias pins.
O que observar
- Qwen-Image-2.1 (Alibaba, pesos abertos de 7B): YouTube “A 7B Model That Beats Nano Banana 2.0?” https://www.youtube.com/watch?v=fwHS0ubmI7I e Lemmy https://lemmy.dbzer0.com/post/75874773 — benchmarks próprios afirmam superar grandes modelos fechados, tornando-o um símbolo do impulso do open source 🚀
- LTX 2.5 (modelo de vídeo totalmente open source): YouTube https://www.youtube.com/watch?v=6B9WSxi6j8E — já há uso prático no ComfyUI com múltiplas tomadas e saída em 2K
- Polêmica do “Nano Banana” no Google Earth: Lemmy https://lemmy.world/post/50167698 (score 473) — padrão típico de grande empresa fechada: lançamento de recurso → abuso → suspensão imediata
- Perda de força do Sora 2: YouTube (TBS NEWS DIG) https://www.youtube.com/watch?v=_r9hojDlABM — depois de ganhar atenção, avançou para um desligamento gradual (previa-se o fim da API em 2026-09-24)
- Processo da SM Entertainment contra deepfakes de K-pop: Reddit https://www.reddit.com/r/kpop/comments/1wsdr6d/ — problemas de direito de imagem causados pelo abuso de IA, aberta ou fechada, reúnem as reações mais fortes
- Vlo 0.3 (editor de vídeo de IA open source): Reddit https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — ferramenta local que integra Minimax H3, Qwen2.1, Krea2 e LTX2.5
Recomendações
- Na próxima rodada, a etapa do X deve recolher dados novamente usando palavras-chave diretamente ligadas ao tema, como Midjourney, Sora, Stable Diffusion, Wan e Kling. Os dados desta vez não podem ser usados.
- Se o problema de
searchPostsretornar 403 no Bluesky continuar, considerar meios alternativos de acesso, como uma API autenticada. - Continuar acompanhando a adoção de Qwen-Image-2.1 e LTX 2.5 como indicadores open source no próximo ciclo.
- Priorizar notícias de abuso e polêmica envolvendo empresas fechadas, como Nano Banana/Google Earth e o processo do Grok Imagine, pois elas tendem a maximizar o engajamento.
- No Reddit, dividir as buscas em várias consultas para ampliar a coleta e chegar à meta de cerca de 20 itens.
- Verificar no próximo ciclo como ficará o equilíbrio do mercado de vídeo de código fechado após o encerramento da API do Sora.
Qualidade dos dados
No X, um erro na escolha dos termos de busca resultou apenas em dados sem relação com o tema, tornando a situação efetivamente “sem dados”. No Bluesky, a API de busca completa foi bloqueada por 403, exigindo acompanhamento alternativo de contas e deixando a coleta abaixo de cerca de 20 itens. O Reddit também ficou abaixo da meta, com 12 itens obtidos por uma única consulta. Por outro lado, Lemmy (mais de 60 itens revisados), Pinterest (50 pins revisadas) e YouTube (10 vídeos analisados) tiveram um volume em geral suficiente.
Resumo por plataforma
Reddit — Notícias de IA para geração de imagens e vídeos
Onde
As 12 threads coletadas vieram de 9 subreddits. O número de membros e de itens é o seguinte (todos encontrados com a busca “Image and Video Generation AI News”).
| Subreddit | Membros | Itens coletados |
|---|---|---|
| r/kpop | 3.893.359 | 1 |
| r/youtube | 3.462.568 | 1 |
| r/StableDiffusion | 1.027.325 | 1 |
| r/AI_Agents | 452.181 | 1 |
| r/Vocaloid | 218.928 | 1 |
| r/aiwars | 170.021 | 1 |
| r/generativeAI | 159.505 | 4 |
| r/B2BForHire | 139.944 | 1 |
| r/GenAI4all | 49.028 | 1 |
r/generativeAI, com 4 itens, foi o mais frequente, concentrando threads de perguntas como “quais ferramentas de IA podem ser usadas gratuitamente?”. Nos demais subreddits houve um item cada, com destaque para assuntos como cinema, música e K-pop, em que a GenAI foi usada ou gerou problemas.
O que as pessoas dizem
- Thread nº 1, “Dreamworks usa GenAI desde 2023” (r/aiwars, 17 pts, 48 comentários, 2026-09-30, https://www.reddit.com/r/aiwars/comments/1wty4m6/): alega que produções da Dreamworks como Trolls Band Together e Kung Fu Panda 4 foram feitas com GenAI. O comentário principal foi cético: “Nothing you posted says that these movies are 'produced with gen AI'. ... You have no idea how they used AI in these productions.” (u/Majestic-Coat3855, 25 pts)
- Thread nº 2, “Procura alternativas de image-to-video adulto após reforço de filtros no DreamFort” (r/generativeAI, 10 pts, 8 comentários, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wtzefv/): a geração NSFW do WAN 3.0 ficou repentinamente mais restritiva, e usuários buscam alternativas fechadas como Seedream 2.0 Unfiltered e MiniMax H3.
- Thread nº 3, “Conteúdo gerado por IA está matando o YouTube” (r/youtube, 107 pts, 21 comentários, 2026-09-25, https://www.reddit.com/r/youtube/comments/1wqbl4f/): aponta o aumento explosivo de vídeos de IA montados com narração. “We have entered the realm of slop.” (u/three-sense, 2 pts), “YouTube CEO says he's pro ai slop.” (u/HotUKTakes, 2 pts)
- Thread nº 4, “Não existe ferramenta de geração de vídeo por IA ‘totalmente gratuita’” (r/generativeAI, 55 pts, 36 comentários, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wty6zj/): discussão realista de que o custo de GPUs em nuvem não é caridade. “videos are not like cheap LLMs, no one can give it away for free” (u/opengradient, 5 pts)
- Thread nº 5, “Qual é a melhor ferramenta de geração de imagens por IA focada em gratuidade?” (r/generativeAI, 4 pts, 54 comentários, 2026-09-26, https://www.reddit.com/r/generativeAI/comments/1wqfleb/): são recomendados Yodayo/MoescapeAI (50 créditos/24h), Leonardo (tokens grátis diários) e outros.
- Thread nº 6, “Vaga para criador de vídeo com IA/gerente de conteúdo de IA” (r/B2BForHire, 2 pts, 5 comentários, 2026-09-25, https://www.reddit.com/r/B2BForHire/comments/1wpx42u/): vaga que busca experiência prática com vídeos híbridos IA+produção integral por IA. Sinal de que a produção de vídeos de IA já está se consolidando como profissão.
- Thread nº 7, “AnythingBecomeMoe usa GenAI no novo MV ‘DisplayHolic’” (r/Vocaloid, 327 pts, 105 comentários, 2026-09-28, https://www.reddit.com/r/Vocaloid/comments/1wsa4nz/): opiniões divididas. “I don't understand when incredibly talented people embrace ai” (u/AungCowMyat, 297 pts) versus “at least they're disclosing it... far better usage than some others who just straight up reject the fact that they used AI” (u/memorie_desu, 200 pts)
- Thread nº 8, “SM Entertainment toma medidas legais contra imagens geradas por IA que tinham Lim Yoona e Winter, do aespa, como alvo” (r/kpop, 730 pts, 52 comentários, 2026-09-28, https://www.reddit.com/r/kpop/comments/1wsdr6d/): forte preocupação com deepfakes. “the deepfakes are so concerning. glad sm is taking action :(” (u/llamacana, 167 pts)
- Thread nº 9, “Vlo 0.3 — editor/gerador de vídeo open source especializado em composição com IA” (r/StableDiffusion, 1.055 pts, 71 comentários, 2026-09-28, https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/): bem recebido pelo suporte a workflows integrados de Minimax H3, Qwen2.1, Krea2 e LTX2.5. “Great ad, same as before :) I forgot about this app, I will Def try it.” (u/Maskwi2, 22 pts)
- Thread nº 10, “Vídeo de IA que viralizou em 2024: vendo hoje, a evolução de qualidade é absurda” (r/GenAI4all, 199 pts, 66 comentários, 2026-09-24, https://www.reddit.com/r/GenAI4all/comments/1wou5vb/): thread nostálgica sobre o salto de qualidade em poucos anos, com muitas reações em linha com o título: “the leap in quality since then is insane”.
- Thread nº 11, “Quero uma ferramenta de geração de imagens por IA sem guardrails” (r/AI_Agents, 0 pts, 22 comentários, 2026-09-29, https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/): diante da insatisfação com a censura excessiva do ChatGPT, muitos recomendam migrar para Midjourney, VeniceAI ou modelos open source chineses.
- Thread nº 12, “Existe uma ferramenta de IA gratuita para criar vídeo animado a partir de um roteiro?” (r/generativeAI, 4 pts, 23 comentários, 2026-09-27, https://www.reddit.com/r/generativeAI/comments/1wrip4m/): “Minimax H3 with comfyUI” (pressupondo instalação local, u/Amonsul_, 4 pts) foi a resposta mais forte. Também surgiu a conclusão de que qualidade exige pagamento.
Sinais
- Tendência de alta: a reação contra o reforço de filtros de ferramentas fechadas (thread nº 2) se traduz consistentemente em preferência por modelos open source/locais — ComfyUI, Minimax H3 e a linha SDXL — em várias threads (nº 2, nº 11 e nº 12). A conclusão “para evitar censura, só rodando localmente” virou praticamente um modelo de resposta.
- Sinais de profissionalização: a thread de emprego (nº 6) e a sobre a Dreamworks (nº 1) mostram que a GenAI está deixando de ser apenas hobby e sendo incorporada à infraestrutura prática da produção cinematográfica e de conteúdo.
- Afirmações descartadas: a expectativa de uma ferramenta de vídeo “totalmente gratuita, ilimitada e sem marca d’água” (threads nº 4 e nº 5) é rejeitada pela própria comunidade como irrealista. Respostas que explicam os custos reais de GPUs em nuvem dominam os comentários principais.
- Estrutura de conflito: nas threads nº 1 e nº 7 há divisão sobre se a divulgação do uso de GenAI é algo positivo. Na thread de Vocaloid, tanto a defesa de que “ao menos divulgar é mais honesto” como a crítica de que “é triste ver pessoas talentosas recorrendo à IA” aparecem entre os comentários principais, o que não se explica por uma simples dicotomia de aprovação e reprovação.
- Ponto inesperado: os maiores scores foram da thread sobre medidas legais contra imagens maliciosas de IA envolvendo idols de K-pop (nº 8, 730 pts) e da polêmica do MV de Vocaloid (nº 7, 327 pts). Em comparação com threads de apresentação de ferramentas (nº 5 e nº 12), temas de danos a pessoas e ética geraram reações muito mais fortes. O interesse em abuso e problemas de direito de imagem fica mais visível do que a própria tendência tecnológica.
Limites
- A meta do briefing era analisar cerca de 20 posts em cada plataforma, mas apenas 12 threads foram coletadas. Foi usado somente o termo de busca “Image and Video Generation AI News”, sem buscas adicionais separando “código fechado” e “open source” (como o agente apenas leu os resultados coletados pelo worker, não fez buscas adicionais).
- Não há registro em threads.md de que as buscas tenham falhado ou retornado vazio. Portanto, os 12 itens vieram dessa única consulta; a falta de volume provavelmente se deve à pouca abrangência da consulta.
- As threads nº 7 (Vocaloid), nº 8 (kpop), nº 9 (StableDiffusion) e nº 10 (GenAI4all) não têm o texto inicial registrado; a avaliação se baseia apenas no título e nos comentários principais.
X
X — Notícias de IA para geração de imagens e vídeos
##Nota importante sobre os dados coletados
Ao verificar output/x.posts.md, os termos de busca usados nesta coleta do X foram:
“Spain”, “Tesla”, “JubJub”, “Holy”, “Italy”, “#bb28”, “Elon”, “Croat”, “Donald” e “Roman”. Eles não foram resultados de buscas ligadas ao tema da pesquisa — IA de geração de imagens e vídeos de código fechado/open source —, mas sim palavras em tendência do X Explore mostradas na tabela “What X says is happening” no início de output/x.posts.md (tendências vistas numa sessão geolocalizada na Croácia) e reutilizadas diretamente como buscas. Por isso, as 40 publicações coletadas de 37 contas tratam sobretudo de futebol (Espanha contra Croácia), recursos de assistência à condução de carros Tesla, WWE, Big Brother (#bb28), declarações políticas de Donald Trump e outros temas sem relação com a pesquisa.
O texto abaixo é um relato honesto dos dados realmente coletados, mas é importante deixar claro desde já que eles não representam tendências de IA para geração de imagens e vídeos.
Contas
A maioria das 37 contas coletadas contribuiu apenas com um post pontual, e não foram encontradas pessoas que publicassem sobre o tema. As únicas com mais de um post foram as seguintes, todas fora do tema:
- @ryu15 (Ryu) — 2 posts, notas técnicas pessoais sobre rodar VRChat em uma “Tesla V100”; a coincidência foi com Tesla como nome de GPU, não com condução autônoma.
- @grouchoskie (Grouch Oskie) — 2 posts, publicações cotidianas.
- @reigns_era (Roman Reigns SZN) — 2 posts, posts de fã relacionados a Roman Reigns, da WWE.
Não há neste conjunto de dados contas que publiquem continuamente sobre IA de geração de imagens ou vídeos.
Posts
Houve pouquíssimos posts contendo termos próximos, como “AI” e “generação”, e nenhum tratava de IA de geração de imagens ou vídeos. Eles são listados apenas como referência.
-
@rammcodes (Ram Maheshwari) — 276 likes, 51 reposts, 4 respostas, cerca de 15.000 visualizações, 2026-09-29
https://x.com/rammcodes/status/2104962267267944848
“Holy Sh*t... this is like PDF parsing on steroids... A free, open-source PDF parser that converts PDFs into AI-ready Markdown, JSON, and HTML.”
→ Apresenta um parser de PDFs open source, um tema diferente de geração de imagens/vídeos: análise de documentos e ferramenta para RAG. -
@LuisBizarro (Luis Bizarro) — 930 likes, 48 reposts, 37 respostas, cerca de 52.000 visualizações, 2026-09-29
https://x.com/LuisBizarro/status/2104780688113455342
“Another AI slop and vibe coded experiment... based on Neon Genesis Evangelion. This took me like 45 minutes and three prompts. This is all Three.js and WebGL.”
→ Experiência 3D interativa feita com “vibe coding” por IA, usando Three.js/WebGL. Não é uma notícia sobre modelos de imagem ou vídeo, mas sobre IA para código. -
@thomasunise (Thomas Unise) — 732 likes, 48 reposts, 43 respostas, cerca de 111.000 visualizações, 2026-09-29
https://x.com/thomasunise/status/2105003307232059397
“Elon is diabolical OpenAI drops dots https://Dot.com goes to Grok Bot”
→ Post sobre uma troca de farpas envolvendo domínio entre OpenAI e Grok, não sobre tendências técnicas de modelos generativos. -
@LinusEkenstam (Linus ✦ Ekenstam) — 2.640 likes, 408 reposts, 354 respostas, cerca de 344.000 visualizações, 2026-09-30
https://x.com/LinusEkenstam/status/2105212016583422270
“This video is going Viral everywhere. A trillionaire and a pile of billionaires are unable to answer a simple question about regular laptop jobs...”
→ O vídeo mostra figuras conhecidas da indústria de IA, como Dario, mas o tema é emprego, e não a evolução técnica da geração de vídeo por IA.
As outras 36 publicações — futebol Espanha x Croácia, reclamações sobre direção autônoma da Tesla, posts de fãs sobre JubJub, Big Brother #bb28, WWE e declarações políticas de Trump — não têm qualquer relação com IA de geração de imagens ou vídeos.
Sinais
- Não foram detectados sinais claros sobre o tema. Entre os 40 posts coletados, não há uma única menção a IA de geração de imagens ou vídeos de código fechado, como Midjourney, Sora, Runway, Veo e Flux Kontext, nem open source, como Stable Diffusion, Wan, HunyuanVideo e ComfyUI.
- A única descoberta é um sinal do próprio processo de coleta: os termos de busca reutilizaram tendências regionais do X Explore voltadas à Croácia, sem relação com o briefing. Esse problema da lógica de coleta é a maior descoberta desta rodada.
Limites
- A maior limitação é que os termos de busca não tinham relação com o tema. Os dez termos — “Spain”, “Tesla”, “JubJub”, “Holy”, “Italy”, “#bb28”, “Elon”, “Croat”, “Donald” e “Roman” — vieram diretamente de tendências do X Explore em uma sessão geolocalizada na Croácia e não do tema de IA para geração de imagens e vídeos. Das 40 publicações coletadas, o número de itens materialmente relacionados ao tema foi efetivamente zero.
- Não foram feitas buscas sequer uma vez por termos diretamente relevantes, como “Midjourney”, “Sora”, “Stable Diffusion”, “Runway”, “Flux”, “Veo”, “Kling” e “HunyuanVideo”. Esta etapa do X não permite, na prática, dizer nada sobre o tema.
- A própria tabela de tendências do Explore — Spain / Tesla / JubJub / Holy / Italy / #bb28 / Elon / Croat / Donald / Roman — é limitada à visão de um servidor croata e não deve ser tratada como tendência global.
- Em conclusão, não é possível informar descobertas válidas sobre IA de geração de imagens e vídeos open source ou fechada no X a partir destes dados. Uma nova coleta deve usar termos ligados ao tema, como nomes concretos de modelos, ferramentas e empresas.
YouTube
YouTube — Notícias de IA para geração de imagens e vídeos (código fechado/open source)
Canais
- AI WITH Rithesh (@RitheshSreenivasan) — canal internacional focado em ferramentas de IA. Testou o Qwen-Image-2.1 no próprio dia.
- Daily AI Roundup (@ai_roundup) — canal de resumos diários de notícias de IA. Apresentou o lançamento de Qwen-Image-2.1 em formato jornalístico.
- Veteran AI (@VeteranAI-y1r) — canal especializado em workflows do ComfyUI. Tem abordado LTX 2.5 e Qwen Image 2.1 em sequência.
- MaxonShire (@MaxonShire) — canal de comparação e testes de geração local de vídeo por IA. Foca sobretudo em comparações entre HunyuanVideo e a série Wan.
- 動画編集の中の人 — em japonês, forte em comparações de ferramentas pagas de geração de imagens por IA.
- AI大学【AI&ChatGPT最新情報】 (@AIAIChatGPT-cj4sh) — em japonês, centrado em explicações e guias de ferramentas de IA para iniciantes.
- AIで創作効率化とマネタイズby呪喝蛙 (@AI_aaafrog) — em japonês, apresenta modelos do ComfyUI e conteúdo voltado a monetização.
- TBS NEWS DIG — canal oficial de notícias da TBS. Reportou sobre o Sora 2 em formato de telejornal (news23).
O número de inscritos não foi exibido nas páginas dos vídeos sem renderização JavaScript; não foi possível confirmá-lo a partir dos resultados de busca/oEmbed obtidos desta vez (ver Limites).
Vídeos
-
“Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!” — AI WITH Rithesh / final de setembro de 2026, logo após a divulgação do Qwen-Image-2.1 em 2026-09-20 / https://www.youtube.com/watch?v=3qGl0wiv2G0 — apresenta o modelo de pesos abertos de 7B lançado pela Alibaba, com geração de PNG transparente, até 10 imagens de referência e saída nativa em 2K, afirmando que ele rivaliza com grandes modelos fechados.
-
“A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native 2K, RGBA & 10-Image Workflows” — Veteran AI / final de setembro de 2026 / https://www.youtube.com/watch?v=fwHS0ubmI7I — explicação de workflow do Qwen-Image-2.1 no ComfyUI. Estrutura-se em torno da alegação de que benchmarks próprios superam o Nano Banana 2.0, fechado (a Tom's Hardware também apresentou Qwen Image Benchmark 60,2 versus 59,82 do Nano Banana 2.0).
-
“Alibaba Open-Sources Qwen-Image-2.1, A 7B Model With Native Transparency” — Daily AI Roundup / final de setembro de 2026 / https://www.youtube.com/watch?v=cdZ4E7_kiJY — apresenta a abertura do Qwen-Image-2.1 em formato de notícia urgente. O destaque é o suporte nativo à transparência, ou canal alfa.
-
“Master LTX 2.5 in ComfyUI: Multi-Shot, First-Last Frame & 2K Workflows” — Veteran AI / meados de agosto de 2026, exibido nos resultados como cerca de 40 a 48 dias desde a publicação / https://www.youtube.com/watch?v=6B9WSxi6j8E — guia prático de uso do modelo de vídeo totalmente open source LTX 2.5 no ComfyUI. Explica workflows com múltiplas tomadas, definição de primeiro/último quadro e saída em 2K.
-
“LTX 2.5 is a New Free and Opensource AI Video Model that is Insanely Fast in Generation” (Shorts) — meados de agosto de 2026 / https://www.youtube.com/shorts/h8qy-MBDzho — vídeo curto apresentando a velocidade de geração do LTX 2.5.
-
“使わにゃ損損!お得に生成するならComfyUI一択!2026年おすすめ生成モデルベスト!” — AIで創作効率化とマネタイズby呪喝蛙 / 2026, exibido nos resultados como cerca de 172 dias antes, portanto um pouco mais antigo / https://www.youtube.com/watch?v=qmiPya-U2KM — vídeo de panorama dos melhores modelos open source para ComfyUI, incluindo imagem, vídeo, música, voz e 3D.
-
“【ドS課金して判明】2026年おすすめ画像生成AIはコレ!NanoBananaPro・Seedream4.0・Midjourney・AdobeFireflyを徹底比較します!” — 動画編集の中の人 / 2026, recente mas sem data precisa confirmada / https://www.youtube.com/watch?v=vJLDbXaSKW4 — projeto de review que paga e compara quatro serviços de código fechado: Nano Banana Pro, Seedream 4.0, Midjourney e Adobe Firefly.
-
“【画像生成AIの頂点】Google最新の画像生成AI「Nano Banana 2(ナノバナナ)」を無料で使い倒す!最短スタート完全ガイド!” — AI大学【AI&ChatGPT最新情報】 / 2026, após o lançamento do Nano Banana 2 em 2026-02-26 a 27 / https://www.youtube.com/watch?v=Asuw6jHVcSs — guia para iniciantes sobre como começar gratuitamente a usar o Nano Banana 2 (Pro), baseado no Gemini 3 Pro.
-
“【Google Flow完全ガイド】無料で使えるAI映像制作ツールが超進化!Gemini Omni Flash・ナノバナナを使って動画や画像を作れる!” — AI大学【AI&ChatGPT最新情報】 / depois de maio de 2026, mencionando a adição de Gemini Omni Flash / https://www.youtube.com/watch?v=dBFK1yFJXOA — explica a evolução mais recente do Flow, a ferramenta integrada fechada do Google. Destaca que a ferramenta reúne geração de imagem da família Nano Banana e geração de vídeo da família Veo.
-
“最新動画生成AI「Sora2」リアルな映像が約3分で生成可能に…実演でわかったその性能 一方で著作権への懸念も【news23】” — TBS NEWS DIG / 2026, reportagem de TV sobre o Sora 2 / https://www.youtube.com/watch?v=_r9hojDlABM — conteúdo jornalístico que demonstra o Sora 2, de código fechado, enquanto aborda preocupações com violações de direitos autorais. Outra investigação indicou que a OpenAI anunciou o encerramento do Sora em 24 de março de 2026, encerrou o aplicativo e a versão web em 26 de abril e previa encerrar também a API do Sora 2 em 24 de setembro de 2026. Isso mostra que, em cerca de meio ano a partir desta notícia, o próprio Sora caminhou para o fim.
Sinais
- Impulso do lado open source: Qwen-Image-2.1 — da Alibaba, lançado em 2026-09-20, com 7B de parâmetros, transparência nativa e suporte a 10 imagens de referência — foi abordado imediatamente por vários canais depois do lançamento. A disseminação gira em torno de benchmarks próprios que dizem que o modelo de pesos abertos é equivalente ou superior ao Nano Banana 2.0, uma grande solução fechada. Vídeos comparando LTX 2.5, HunyuanVideo e a família Wan, como modelos gratuitos de geração de vídeo que rodam localmente, também continuam aparecendo; o ComfyUI tornou-se efetivamente a plataforma comum.
- Movimento do código fechado: soluções do Google — Nano Banana 2 / Nano Banana Pro, Gemini Omni Flash e Flow — são os protagonistas recorrentes nos canais japoneses. Já o Sora da OpenAI, após ganhar atenção no início de 2026, avançou gradualmente para o desligamento entre março e setembro daquele ano, do fim de web/aplicativo ao fim da API. Isso alimenta uma narrativa de grandes empresas fechadas que causam forte impacto no lançamento, mas têm continuidade incerta.
- Distribuição por idioma: canais japoneses, como AI大学, 動画編集の中の人 e 呪喝蛙, publicam mais comparações e guias práticos de produtos fechados. Canais em inglês, como Veteran AI, AI WITH Rithesh, Daily AI Roundup e MaxonShire, publicam mais explicações de workflows do ComfyUI e notícias rápidas de benchmarks de modelos open source.
Limites
- As páginas de vídeo e de resultados de busca do YouTube (
/watch,/results) entregaram apenas HTML estático com links de navegação do rodapé via WebFetch; elementos renderizados dinamicamente, como visualizações, likes, inscritos e comentários, não puderam ser obtidos diretamente. - Como alternativa, a API oEmbed do YouTube (
/oembed?url=...&format=json) complementou somente título e nome do canal; visualizações e datas de publicação vieram de snippets dos resultados de busca, como “há X dias”. Assim, algumas datas são estimativas — por exemplo, “cerca de 40 a 48 dias” e “cerca de 172 dias” —, e datas exatas e visualizações não foram verificadas. - Alguns IDs de vídeo, como
yVMs1Z-FWmQ, o vídeo em russo03MX2U8ZLDke o em espanholjH0AjVP49KI, apareceram nos resultados, mas foram deixados de lado por menor prioridade de idioma e relevância. - Não foi possível obter o conteúdo dos comentários principais, pois o WebFetch não renderiza a seção de comentários.
Bluesky
Bluesky — Notícias de IA para geração de imagens e vídeos
Nota sobre o método de coleta
O endpoint https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts?q=..., indicado no playbook, foi testado com várias consultas, como Midjourney, "Stable Diffusion" e cat, mas sempre retornou HTTP 403, tornando-se inutilizável. A versão web de bsky.app/search também é uma SPA renderizada por JavaScript, portanto não foi possível obter seu conteúdo. Em contrapartida, app.bsky.actor.getProfile, app.bsky.feed.getAuthorFeed e app.bsky.unspecced.getTrendingTopics responderam normalmente. Assim, foi adotado um procedimento alternativo: identificar com WebSearch contas possivelmente relacionadas ao tema e ler diretamente o getAuthorFeed de cada uma. Os detalhes estão em ## Limites.
Contas
-
dfl.bsky.social (DFL inc.)
https://bsky.app/profile/dfl.bsky.social
Conta pessoal que publica quase todos os dias imagens de paisagens japonesas em estilo fotográfico geradas com o “Nano Banana 2” do Google. Continuava ativa em setembro de 2026 e foi o exemplo mais consistente de usuário real de modelo fechado. -
doctordiffusion.bsky.social
https://bsky.app/profile/doctordiffusion.bsky.social
Criador open source que desenvolve e distribui LoRAs e modelos para Stable Diffusion 3.5, Flux Dev, HunyuanVideo e LTX-Video no Civitai e no Hugging Face. No entanto, suas publicações pararam entre novembro de 2024 e março de 2025, e não houve atividade em 2026. -
emanuelmaiberg.bsky.social (Emanuel Maiberg, repórter da 404 Media)
https://bsky.app/profile/emanuelmaiberg.bsky.social
Continua investigando e publicando sobre abuso de IA para geração de imagens e vídeos: deepfakes, imagens geradas sem consentimento e imitações de celebridades em música de IA. Seguiu postando em agosto e setembro de 2026 e é uma das contas mais consistentemente ligadas ao tema no Bluesky. -
midjourneyofficial.bsky.social (Midjourney oficial)
https://bsky.app/profile/midjourneyofficial.bsky.social
Anunciou sua entrada no Bluesky em agosto de 2025, mas a última publicação recente era de 8 de outubro de 2025; não foram encontrados posts de 2026. É um exemplo de operação fraca no Bluesky por uma empresa oficial de código fechado. -
stablediffusion.bsky.social (“Stable Diffusion online AI”)
https://bsky.app/profile/stablediffusion.bsky.social
Conta comunitária de arte por IA com cerca de 1.800 seguidores. As publicações foram até fevereiro de 2025; não foram encontradas atualizações posteriores. -
wagahai-ai.bsky.social
https://bsky.app/profile/wagahai-ai.bsky.social
Conta pessoal japonesa que publica ilustrações e vídeos de IA. Também não teve postagens após janeiro de 2025.
Posts
-
@dfl.bsky.social — 2026-09-30, 14 likes, 1 repost
https://bsky.app/profile/dfl.bsky.social/post/3mwr727gyck26
“AI image generation #Nano Banana 2 ... canal com reflexos dourados”. Paisagem de canal japonês gerada com o modelo de imagem fechado Nano Banana 2, do Google. -
@dfl.bsky.social — 2026-09-25, 51 likes, 2 reposts, maior engajamento entre os 20 posts recentes
https://bsky.app/profile/dfl.bsky.social/post/3mwesrcxg5k2c
“#Nano Banana 2 ... ampla vista de margem de rio, muralhas de pedra e casas japonesas ao fundo”. -
@dfl.bsky.social — 2026-09-21, 45 likes, 2 reposts
https://bsky.app/profile/dfl.bsky.social/post/3mw2ny6hsa22p
“#Nano Banana 2 ... antiga ponte de madeira, riacho e crepúsculo fresco”. Confirma o ritmo de postagens diárias e reações estáveis na faixa de 30 a 50 likes. -
@doctordiffusion.bsky.social — 2025-01-19, 3 likes, 4 respostas
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x
“SD3.5 Lives! Lançamento do Absynth 2.0”. Distribuição gratuita no Civitai/Hugging Face de uma versão ajustada do Stable Diffusion 3.5 Large: um lançamento grassroots típico de open source. -
@doctordiffusion.bsky.social — 2025-01-01, 1 like, 2 respostas
https://bsky.app/profile/doctordiffusion.bsky.social/post/3leofdsx6yc23
Compartilha, com a tag #opensource, a descoberta técnica de que o treinamento se tornou estável com alinhamento de text encoder entre Flux Dev e Stable Diffusion 3.5. -
@doctordiffusion.bsky.social — 2024-11-26, 4 likes
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lbssdeocz226
Exemplo prático de extensão de vídeo no ComfyUI usando Img2Vid do LTX-Video e nós personalizados, combinando geração open source de vídeo com LTX-Video/Mochi. -
@emanuelmaiberg.bsky.social — 2026-08-20, 14 likes, 6 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtjegiaxpk2h
Reportagem da 404 Media dizendo que imagens de IA não consensuais estão ficando cada vez mais sutis, isto é, mais difíceis de perceber. -
@emanuelmaiberg.bsky.social — 2026-08-17, 36 likes, 9 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtbvku5wds2p
Discute, em podcast com o pesquisador de deepfakes Hany Farid, o passado, presente e futuro das mídias sintéticas. -
@midjourneyofficial.bsky.social — 2025-08-15, 41 likes, 4 reposts, 14 respostas
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
“#Midjourney is now on BlueSky! Who are the best creators we should follow?” Primeira publicação oficial ao entrar no Bluesky. Depois, houve apenas posts esparsos até outubro de 2025.
Sinais
- As pessoas influentes que falam de “IA” no Bluesky se concentram mais em LLMs e agentes do que em geração de imagens e vídeos. Foram verificados posts recentes de setembro de 2026 de comentaristas de IA com dezenas de milhares de seguidores, como Tim Kellogg (@timkellogg.me) e Ethan Mollick (@emollick.bsky.social). Eles falavam sobretudo de GPT-6.1, Gemini 4 e funções de agentes do Claude, sem menções a Midjourney, Stable Diffusion, Sora, Wan ou Kling.
- Exemplos de código fechado aparecem como uso cotidiano de pessoas, não como comunicação oficial das empresas. Enquanto a conta oficial do Midjourney está praticamente silenciosa, contas como dfl.bsky.social continuam postando diariamente obras feitas com Nano Banana 2, do Google.
- A comunidade criadora open source — distribuição de LoRAs e compartilhamento de workflows do ComfyUI — já perdeu força no Bluesky. doctordiffusion, wagahai-ai e stablediffusion pararam de atualizar na primeira metade de 2025. É possível que o auge tenha sido no fim de 2024 e começo de 2025.
- O eixo que mais continua publicando sobre geração de imagens e vídeos é crítica e jornalismo. O repórter da 404 Media Emanuel Maiberg continuou escrevendo sobre deepfakes e imagens não consensuais em agosto e setembro de 2026, oferecendo os posts mais atuais sobre o assunto no Bluesky.
- A maior descoberta desta rodada é que o Bluesky não é uma fonte principal para notícias sobre IA de geração de imagens e vídeos open source ou fechada. Tal como no X, são poucos os posts atuais diretamente ligados ao tema.
Limites
app.bsky.feed.searchPosts, a API pública de busca, retornou HTTP 403 continuamente. Isso ocorreu para “Midjourney”,"Stable Diffusion"e “cat”, aparentando bloqueio independente do valor deq.app.bsky.unspecced.searchPostsSkeletonretornou HTTP 501. JágetProfile,getAuthorFeedegetTrendingTopicsfuncionaram. Ou seja, endpoints públicos de leitura estavam disponíveis, mas a busca de texto completo estava bloqueada neste ambiente.- A versão web de
bsky.app/searchtambém é uma SPA renderizada por JavaScript, e o WebFetch não conseguiu recuperar o texto dos posts, apenas a string do título. - Por isso, não foi possível coletar posts por busca de palavras-chave como prevê o playbook. O método alternativo foi descobrir contas via WebSearch e ler individualmente seus
getAuthorFeed. Ele permite ler corretamente os posts recentes das contas encontradas, mas não oferece uma visão abrangente de quantos posts existem na plataforma inteira sobre o assunto. - Posts sobre MiniMax H3 de sungkim.bsky.social e ekazakos.bsky.social, identificados via WebSearch, não apareceram entre os 30 posts recentes ao consultar
getAuthorFeed; eles eram de fim de julho de 2026, mais antigos que os 30 mais recentes no fim de setembro. Por isso não foram incluídos: foi priorizada a regra de só usar material efetivamente lido nesta rodada. - doctordiffusion.bsky.social, wagahai-ai.bsky.social e stablediffusion.bsky.social foram as contas mais diretamente ligadas ao tema que foram encontradas, mas todas pararam na primeira metade de 2025 e não podem ser tratadas como notícias recentes em setembro/outubro de 2026. As únicas contas efetivamente ativas e relevantes eram dfl.bsky.social, no uso de código fechado, e emanuelmaiberg.bsky.social, em jornalismo crítico.
- A meta de analisar cerca de 20 posts não foi alcançada. Sem busca completa, foram identificados apenas pouco mais de uma dezena de posts relacionados, metade de 2024 ou 2025. A conclusão honesta é que o Bluesky tem menos a dizer sobre o assunto do que as demais plataformas.
Lemmy
Lemmy — Notícias de IA para geração de imagens e vídeos (código fechado/open source)
Data da pesquisa: 2026-10-01. Foram usadas a busca da API do Lemmy (/api/v3/search) e APIs de listagem de posts das comunidades, pesquisando transversalmente comunidades como stable_diffusion, imageai, fuck_ai e technology, além de palavras-chave como FLUX.2, Qwen-Image, Nano Banana, Midjourney, Grok Imagine, Sora, Veo e Kling.
Comunidades
- !«メールアドレス» — 5.713 inscritos / 1.423 posts. É a comunidade mais ativa do Lemmy para informações técnicas de IA para imagens e vídeos: workflows do ComfyUI, LoRAs e novos modelos. Anúncios do AI Horde, projeto distribuído e gratuito de geração de imagens mantido pelo dbzer0, também aparecem ali.
- !«メールアドレス» — 8.532 inscritos / 4.680 posts. Espaço para postar imagens geradas por IA sem restrição de modelo. É centrado em obras, não em notícias, e muitos posts têm score negativo, o que revela bem a recepção fria a conteúdo gerado por IA no Lemmy como um todo.
- !«メールアドレス» — 8.333 inscritos. Comunidade que compartilha artigos críticos ao setor a partir de uma posição anti-IA. Notícias de polêmicas e processos envolvendo código fechado tendem a se concentrar nela.
- !«メールアドレス» — comunidade geral de tecnologia. Grandes notícias de empresas fechadas, como o caso do Google Earth, obtiveram ali os maiores scores.
- !«メールアドレス» — 53 inscritos. Comunidade-bot que reproduz mecanicamente o RSS do Reddit (r/ArtificialIntelligence); não representa discussão própria do Lemmy.
Posts
Voltados ao open source (todos em !«メールアドレス»)
- Qwen-Image-2.1 no ComfyUI: imagem de pesos abertos… — 2026-09-22, score 13.
Artigo de blog.comfy.org sobre suporte no ComfyUI ao modelo de imagem de pesos abertos Qwen-Image-2.1, da Alibaba. Foi o post com maior score desta pesquisa. - WebUI para qwen-image-2.1 — 2026-09-27, score 2. Projeto de WebUI leve, na linha do Fooocus, adaptado para Qwen-Image-2.1.
- Adaptadores LoRA de poucos passos para Qwen-Image-2.1 — 2026-09-26, score 0. LoRA que acelera a geração reduzindo o número de passos.
- Continuações longas e contínuas de vídeo com múltiplas tomadas — 2026-09-29, score 4. Workflow de geração de vídeo que conecta múltiplas tomadas sem emendas usando MiniMax-H3-Latent.
- Editor de vídeo com IA gratuito, local e open source — 2026-09-29, score 5. Ferramenta local de edição de vídeo com IA chamada “vlo”.
- LanPaint — inpaint sem treinamento para qualquer modelo — 2026-09-29, score 8. Método que adiciona inpainting de alta qualidade a modelos existentes sem treinamento adicional.
- Pequeno modelo text-to-image de 100M de parâmetros (Supra2-IMG) — 2026-09-22, score 7. Modelo text-to-image extremamente leve e de baixa exigência de VRAM.
- AI Horde — nova interface e documentação — 2026-09-19, score 8. Anúncio de renovação da interface e documentação do serviço distribuído e gratuito de geração de imagens operado pelo dbzer0.
Voltados ao código fechado
- A nova função de geração de imagens por IA do Google Earth não sobreviveu um dia depois que usuários fizeram deepfakes de desastres — 2026-08-01, score 473 (!«メールアドレス»). Recurso de IA do Google Earth com Nano Banana/Gemini foi suspenso antes de completar um dia por abuso com imagens falsas de desastres. Foi um dos posts de maior score de toda a pesquisa.
- Adolescentes do Tennessee processam xAI de Elon Musk por imagens de abuso sexual infantil — 2026-03-17, score 13 (comunidade Mother Jones). Processo sobre imagens de abuso sexual infantil geradas pelo Grok Imagine da xAI. Alega-se que cerca de 23 mil imagens desse tipo foram produzidas em 11 dias.
- Disney e Universal processam criador de imagens Midjourney por violação de direitos autorais — 2025-06-11, score 88 (!«メールアドレス»). Embora seja mais antigo, o processo por direitos autorais contra Midjourney continua citado como notícia de contexto de uma disputa ainda em curso.
- A mesma página de Berserk, 4 colorizações por IA. Parece que GPT vence de novo? — 2026-09-14, score 1, reproduzido via !«メールアドレス». Espelho de uma thread do Reddit que compara colorização automática de mangá em vários modelos, incluindo Nano Banana Pro. Não é publicação original do Lemmy.
Sinais
- O lado open source é dominado pelo ecossistema do ComfyUI. Workflows derivados, LoRAs e extensões de nós para FLUX.2, da Black Forest Labs, e Qwen-Image, especialmente 2.1 da Alibaba, são publicados diariamente. Em frequência e especificidade técnica, essa é de longe a área mais densa do Lemmy. A menção a infraestrutura gratuita e distribuída, como o AI Horde mantido pelo dbzer0, combina com o espírito anticomercial e autônomo da comunidade.
- Geração de vídeo continua sendo nicho dentro do nicho. Posts de vídeo, como MiniMax-H3 e editores locais autorais, são menos numerosos que os de imagem e têm scores modestos, em torno de 4 a 8 pontos.
- Notícias de código fechado entram por abuso e processos, não por apresentação de recursos. Google Earth/Nano Banana, Grok Imagine e Midjourney chegam às comunidades gerais !technology e !fuck_ai no momento de abuso ou litígio, e obtêm scores altos. O post do Google Earth, com score 473, é especialmente alto em toda a pesquisa.
- A visão sobre material gerado por IA é em geral fria. Em !«メールアドレス», quase metade dos posts tem score negativo, entre -18 e -3; o simples fato de algo ser “arte de IA” já reduz sua avaliação. A existência de !fuck_ai, com 8.333 membros, também descreve bem o clima da comunidade Lemmy.
Limites
- O Lemmy é pequeno e não foi encontrada uma comunidade dedicada a IA de geração de imagens e vídeos de código fechado. Há !stable_diffusion para open source, mas não uma comunidade correspondente do outro lado. Por isso, as descobertas sobre código fechado ficam restritas a comunidades gerais, como !technology e !fuck_ai.
- Foram buscados “Veo 3” e “Kling AI”, mas não apareceram posts substantivos do Lemmy; só resultados irrelevantes. Sobre Sora, apareceu apenas uma menção em meme, e não conteúdo sobre o modelo de vídeo em si.
- A obtenção direta da página
lemmy.world/c/stablediffusionfalhou com erro 500; foram usados dados de busca da API como alternativa. A consulta alemmy.today/api/v3/communitytambém retornou 404, e houve demora para identificar que a instância principal era lemmy.dbzer0.com. - !«メールアドレス» é uma comunidade-bot de RSS do Reddit, com 53 membros, e não uma discussão própria do Lemmy. Por isso apenas um item foi incluído como referência.
- Não foram encontradas comunidades ou posts em japonês no Lemmy dentro do escopo pesquisado.
- Esta etapa abrangeu apenas o Lemmy. Para a meta de aproximadamente 20 posts analisados por rede social, foram verificados mais de 60 posts/comentários por busca na API e listas de comunidades, e selecionados os 11 representativos acima.
Pinterest — Notícias de IA para geração de imagens e vídeos
O worker coletou 50 pins para a consulta “Image and Video Generation AI News”, sem divisão por gênero: tudo em um único lote. Todas as 50 foram abertas e analisadas.
Temas visuais
- Android humanoide cromado/branco como o “rosto da IA” — olhos azuis brilhantes, juntas metálicas expostas, às vezes de terno. Usado em tudo, de explicações genéricas a conteúdo sobre âncoras de notícias e ética. [1, 16, 19, 20, 24, 29, 30, 35, 45]
- Fundo azul-marinho/preto com brilho neon ciano-roxo de circuitos — paleta padrão para miniaturas explicativas e listicles sobre IA; cérebro com circuitos ou logotipo luminoso de “AI” como ícone central. [2, 9, 14, 21, 28, 33, 40, 42, 50]
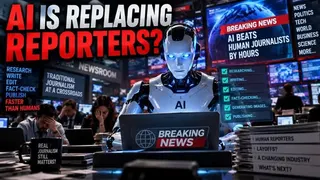
- Ansiedade em torno de “IA substituindo jornalistas/notícias falsas” — âncoras de IA em bancadas de telejornal, selos “FAKE”, UI de detecção de deepfake e logotipos reais de emissoras como NBC com marca d’água “AI GENERATED”. [1, 6, 23, 31, 35, 36, 44]
- Gráficos de dicotomia humano versus IA — mãos em tela dividida, dedos humanos contra dedos robóticos, lupa sobre teclado e legendas como “Human or AI?”. [30, 31]
- Imagens distópicas/de vilão de IA — demônio “AI” de olhos vermelhos e chifres controlando zumbis de celular; usado com frases caça-cliques como “AI is getting scary good”. [17, 23]
- Listicles de ferramentas e gráficos de comparação — produtos reais como Runway, Pika, Kling AI, Luma/Dream Machine, Canva AI, Hailuo, Midjourney, Adobe Firefly, Recraft, Kaiber, Ideogram, SeaArt e Krea, organizados em infográficos de “melhores pagos versus melhores gratuitos” ou “mais de 6 melhores sites”. [5, 15, 40]
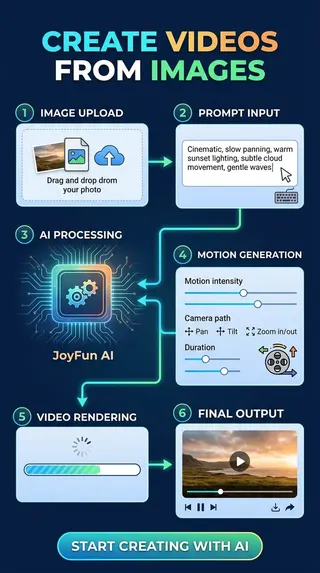
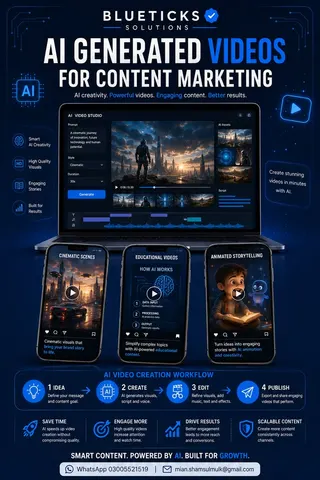
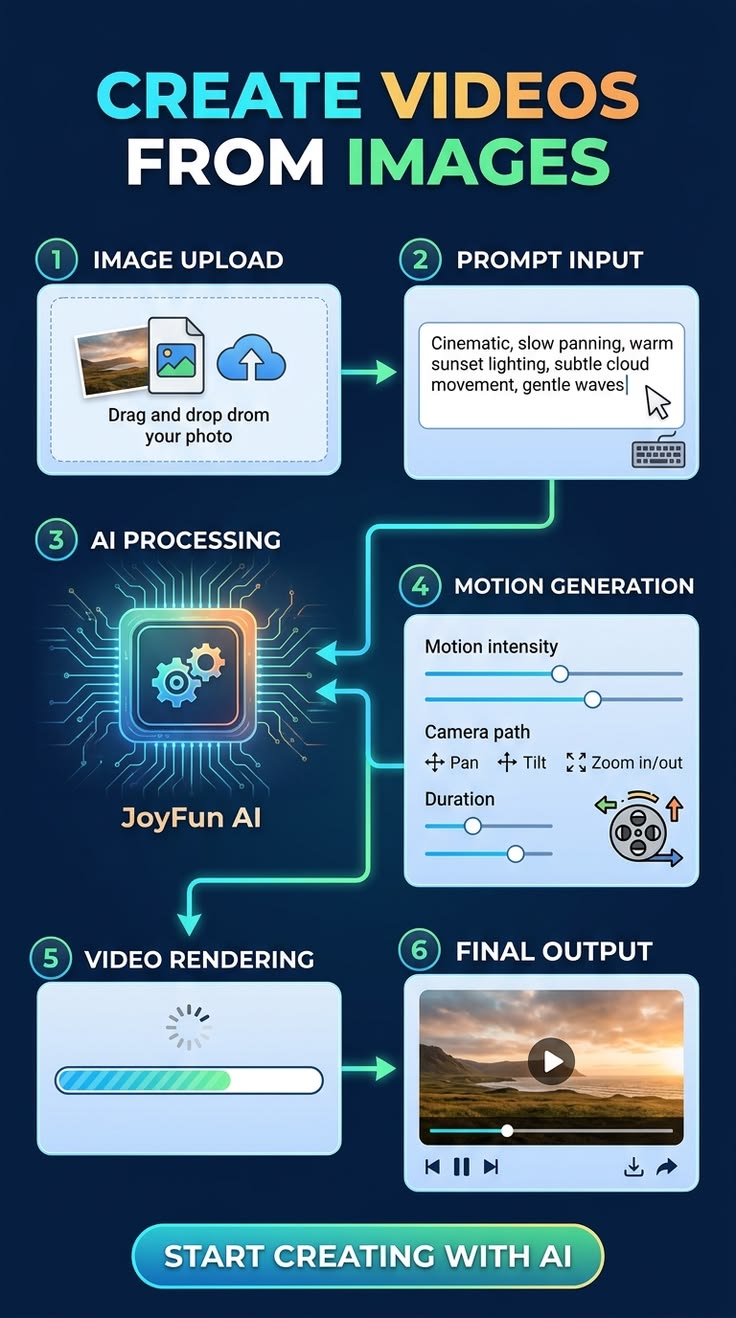
- Capturas de tela de demonstrações de produtos reais — maquetes passo a passo de UI para workflows de image-to-video, como upload → prompt → controles de movimento → renderização, marcadas por pequenas ferramentas SaaS como JoyFun AI e Blueticks. [8, 10]
- Demonstrações de transformação fotorrealista/estilização — uma foto-fonte convertida lado a lado em blocos de madeira, origami, Lego, flores e brinquedos de blocos pela Lumalabs; além de uma imagem composta de estátua de mármore tocando violoncelo e um retrato de pescador creditado à AMD/“Amuse 3.0”. [4, 15, 38]
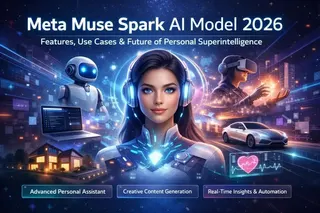
- Colagens de marketing de modelos famosos — Google Veo 2, com a mesma colagem promocional oficial reutilizada em duas pins não relacionadas; Gemini Omni, com “transforme qualquer coisa em vídeo”; e Meta “Muse Spark”, modelo de 2026. [17, 24, 32, 3]
Pins notáveis
- Preocupações com conteúdo de IA e redes sociais [1] — robô mexendo em um celular ao lado de um selo “FAKE” e foto suspeita de gato; isca clássica de ansiedade com deepfakes.
- Meta apresenta geração Muse Image e Muse Video... [3] — apresenta um modelo “Muse Spark” de 2026 como aposta em assistente pessoal/superinteligência, não apenas como ferramenta de conteúdo.
- (sem título, grade de transformações da Lumalabs) [4] — um vídeo-fonte é convertido em versões de pessoa, cachorro e carro feitas de blocos de madeira, origami, tijolos Lego e flores; a demonstração mais clara de capacidade antes/depois do conjunto.
- Criar vídeos a partir de imagens [8] — maquete completa de UI em 6 etapas — upload → prompt → processamento por IA → controles de movimento → renderização → resultado — para uma ferramenta chamada “JoyFun AI”.
- Transforme suas ideias em visuais impressionantes! [15] — estátua hiper-realista de mármore tocando violoncelo, usada como vitrine de geração de imagens.
- (sem título, promoção do Veo 2) [17] — colagem oficial de lançamento do Google: “Veo 2: nosso modelo de geração de vídeo de última geração”, com cachorro nadando, flamingos e garota animada. A imagem idêntica foi reutilizada literalmente na pin 32, com outra legenda.
- Gemini Omni do Google transforma qualquer coisa em vídeo [24] — “qualquer entrada → qualquer saída”, enquadrado como a grande promessa de generalização do Google para geração de vídeo.
- ‘Amuse 3.0’, ferramenta de criação de arte por IA que inclui... [38] — retrato fotorrealista de um pescador idoso, com marca da AMD, sugerindo uma vertente de ferramenta local de geração de imagens acelerada por hardware.
- Apresentando Luma Dream Machine [43] — close extremo de um olho sobre a marca “Dream Machine”; imagem puramente de marca, não uma captura do produto.
- AI NEWS: infográfico-resumo do Google I/O de 20 de maio de 2026 [35] — Gemini 3.5 Flash, Gemini Omni, Gemini Spark e óculos Android XR, enquadrados como o “maior evento de IA”; resumo concreto e datado, diferente de listicles perenes.
Sinais
- O conjunto é fortemente inclinado a conteúdo de miniatura de SEO/blog — robôs de banco de imagens, marcas genéricas de “AI News” e listicles de ferramentas —, que dominam em volume sobre demonstrações reais de arte gerada.
- A ansiedade com deepfakes/desinformação e “IA substituindo jornalistas” aparece como narrativa recorrente, não isolada: está presente em pelo menos 7 das 50 pins, frequentemente com marcas de emissoras reais, como NBC, ou selos “FAKE”.
- Ferramentas reais nomeadas aparecem repetidamente em listicles e demos: Veo 2/Gemini Omni do Google, Dream Machine/Luma, Runway, Pika, Kling AI, Canva AI, Hailuo, Amuse 3.0 e Meta Muse Spark. Porém, surgem principalmente como logotipos e colagens de marketing, raramente em capturas de workflows práticos; JoyFun AI e Blueticks são as duas exceções.
- Ausências: não foram vistos nomes de modelos open source ou capturas de ferramentas locais — nada de ComfyUI, Automatic1111, Stable Diffusion UI ou discussões sobre checkpoints/LoRA — apesar de “Stable Diffusion” aparecer uma vez no título de uma pin sem imagem correspondente. Também não houve conteúdo de comunidade de arte de IA em estilo anime/ilustração, nem demonstrações de vídeo narrativo multi-tomada ou consistência além da grade de transformações da Lumalabs.
- A mesma imagem oficial de marketing do Veo 2 foi encontrada reutilizada em duas pins com textos diferentes [17, 32], sinal de que a área de notícias de IA no Pinterest é em parte reciclada/agregada, não comentário original.
Limites
- Conforme o playbook, o Pinterest não foi navegado diretamente. Todas as descobertas são uma leitura visual das 50 pins e imagens já coletadas pelo worker em
output/pinterest.pins.mdeimages/pinterest/. - A tabela de pins não possui seções por gênero, apenas um lote sem rótulo. Portanto, os temas acima foram extraídos do conjunto completo, não divididos por gênero.
- Várias pins são intituladas “(sem título)” e têm apenas arte genérica de banco de imagens, sem fonte atribuível além da URL da pin e sem forma de confirmar data ou engajamento.
- Títulos e imagens apresentam alegações de marca e manchetes — como “Grok está revolucionando o vídeo” e “GPT 5.2 ... controle de corpo inteiro” —, mas as imagens vinculadas são gráficos genéricos de banco de imagens, e não capturas do recurso ou produto. Essas alegações específicas não puderam ser verificadas apenas pela imagem.
Ações recomendadas
- Coletar novamente a etapa do X com palavras-chave diretamente relacionadas ao tema, como Midjourney, Sora, Stable Diffusion, Wan e Kling.
- Considerar como lidar com o problema de
searchPostsdo Bluesky retornar 403, buscando outro método de pesquisa. - Continuar acompanhando a adoção de Qwen-Image-2.1 e LTX 2.5 como indicadores do lado open source.
- Priorizar notícias de abuso e polêmica de empresas de código fechado, como Nano Banana/Google Earth e o processo do Grok Imagine.
- Ampliar a coleta do Reddit com várias consultas para chegar a cerca de 20 itens, a meta de conclusão.
Imagens coletadas


































Nota sobre a qualidade dos dados
No X, um erro na escolha dos termos de busca levou à coleta apenas de dados sem relação com o tema, deixando efetivamente nenhum dado útil. Bluesky e Reddit também não alcançaram a meta de cerca de 20 itens, enquanto Lemmy, Pinterest e YouTube verificaram em geral um volume suficiente.