Criei do zero uma LLM para RAG em croata com 300 milhões de parâmetros. Roda na CPU
Depois do GPT-2 da vez anterior, desta vez criei do zero uma LLM em croata usando uma única RTX 4090. O objetivo era RAG: um modelo que encontra a resposta no texto fornecido e responde citando uma frase que sirva de evidência. E partindo do princípio de que, em produção, ele rodará na CPU.
Primeiro, a conclusão.
- Cerca de 68 horas na GPU, do zero até a conclusão (incluindo tentativa e erro). Destas, o pré-treinamento levou 51 horas
- 320 milhões de parâmetros. Acerta 71% das perguntas sobre parágrafos e 44% das perguntas sobre textos longos, da ordem de 3.000 tokens
- Responde cada pergunta em 3 a 16 segundos usando apenas a CPU. Os caracteres aparecem em uma velocidade que dá para acompanhar a olho nu
Tempo gasto no treinamento
| Etapa | Tempo | Conteúdo |
|---|---|---|
| Geração dos dados de treinamento | Cerca de 4,5 horas | 45 mil pares de QA da Wikipedia e 50 mil traduções de conversas com EuroLLM-9B (vLLM) |
| Tokenizador e tokenização | Cerca de 2,5 horas (CPU) | Criei uma vocabulário próprio de 32 mil termos para o croata |
| Pré-treinamento | 50 horas e 46 minutos | 7 bilhões de tokens. No último 10%, ampliei o contexto para 4.096 |
| SFT | Cerca de 35 minutos | Ensinei a responder com citações e a recusar quando não houver resposta |
| Aprendizado por reforço (GRPO) | Cerca de 11 horas | 400 etapas, mais ajustes para outras 300 etapas |
O tokenizador próprio consegue representar o croata com aproximadamente metade dos tokens do tokenizador do GPT-2. Com 4.096 tokens, ele consegue ler cerca de 17 mil caracteres.
O modelo criado
| Item | Conteúdo |
|---|---|
| Parâmetros | 320 milhões (24 camadas, 1024 dimensões) |
| Arquitetura | Família Llama / Qwen3 (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Comprimento de contexto | 4.096 tokens |
| Formato de saída | Resposta + Izvor: „uma frase extraída diretamente do contexto“. Se não houver resposta: “U tekstu nema odgovora na ovo pitanje. (Não há resposta para esta pergunta no texto.)” |
| Execução | Pensado para CPU (cerca de 1,3 GB em fp32) |
Além disso, adicionei externamente um mecanismo que verifica por código se a citação gerada realmente está no contexto e, se não estiver, a substitui por “sem resposta”. O ponto é não confiar totalmente no modelo e tornar possível verificar a evidência.
Problemas que descobri ao criar
1. Mesmo sem resposta, ele inventa uma toda vez. No início, ensinei apenas perguntas e respostas comuns. A taxa de acerto aumentou, mas, ao receber um texto que não continha a resposta, ele inventava uma resposta plausível em 100% dos casos. O pior cenário para RAG. Ao ensinar citações e como “recusar”, as invenções caíram para alguns %.
2. Ele recusa demais. Quando a avaliação do aprendizado por reforço era “−0,5 se errar; 0 se recusar”, ele aprendeu que, em textos longos e difíceis, era vantajoso escapar recusando, e passou a recusar em 70% dos casos. Ele explora perfeitamente a brecha na regra de avaliação. Ao mudar a penalidade de recusa para −0,3, ele oscilou para o lado oposto, quase nunca recusava e inventava respostas em 40% dos casos. Ficou indo e voltando como uma gangorra.
3. Erros ao copiar a citação. Em textos longos, a resposta estava certa, mas ele trocava a ordem das palavras da citação ou citava a primeira frase do artigo. Em contexto longo, a citação também estava correta em apenas cerca da metade dos casos.
4. Erros que passam pela verificação. Ele citou com precisão uma frase como “nasceu em ○○”, pertencente a outro artigo misturado ao contexto, e respondeu o local de nascimento de outra pessoa. Como a citação era real, a verificação não conseguiu barrar isso.
5. Falhas nos próprios dados de avaliação. Em alguns casos, contextos que supostamente não tinham resposta ainda continham parte dela; o modelo estava correto, mas era considerado como tendo “inventado” a resposta.
Desempenho final
300 perguntas para cada avaliação. Foi usado o modelo da etapa 100 do aprendizado por reforço ajustado, que tinha o melhor equilíbrio entre recusar e responder.
| Contexto | Correta | Incorreta | Recusou |
|---|---|---|---|
| Parágrafo (cerca de 100 a 400 tokens) | 71,3% | 16,7% | 12,0% |
| Contexto longo (1.500 a 3.500 tokens) | 44,0% | 20,3% | 35,7% |
| Contexto sem resposta | Recusou corretamente | Inventou |
|---|---|---|
| Parágrafo | 97,7% | 2,3% |
| Contexto longo | 92,3% | 7,7% |
Após passar pela verificação, a “proporção de respostas corretas entre as que foram respondidas” foi de 73,8%. Ainda está longe da meta de 90%.
Aliás, se cada pergunta fosse resolvida 8 vezes e bastasse acertar uma delas, o desempenho chegava a 91% em parágrafos e 74% em textos longos (medido no último checkpoint). Esse número quase não mudou antes e depois do aprendizado por reforço; o que mudou foi a capacidade de “resolver sempre”. Os números deixaram claro que o aprendizado por reforço, mais do que acrescentar uma nova habilidade, serve para fazer o modelo resolver sempre problemas que ele só consegue resolver ocasionalmente.
Testando na CPU
Criei uma interface Web de teste e rodei tudo apenas na CPU (i7-13700K). A velocidade com que os caracteres aparecem é a própria velocidade de geração.
Parágrafo (263 tokens): 0,3 segundo até o primeiro caractere, cerca de 11 tokens/s, 7 segundos no total
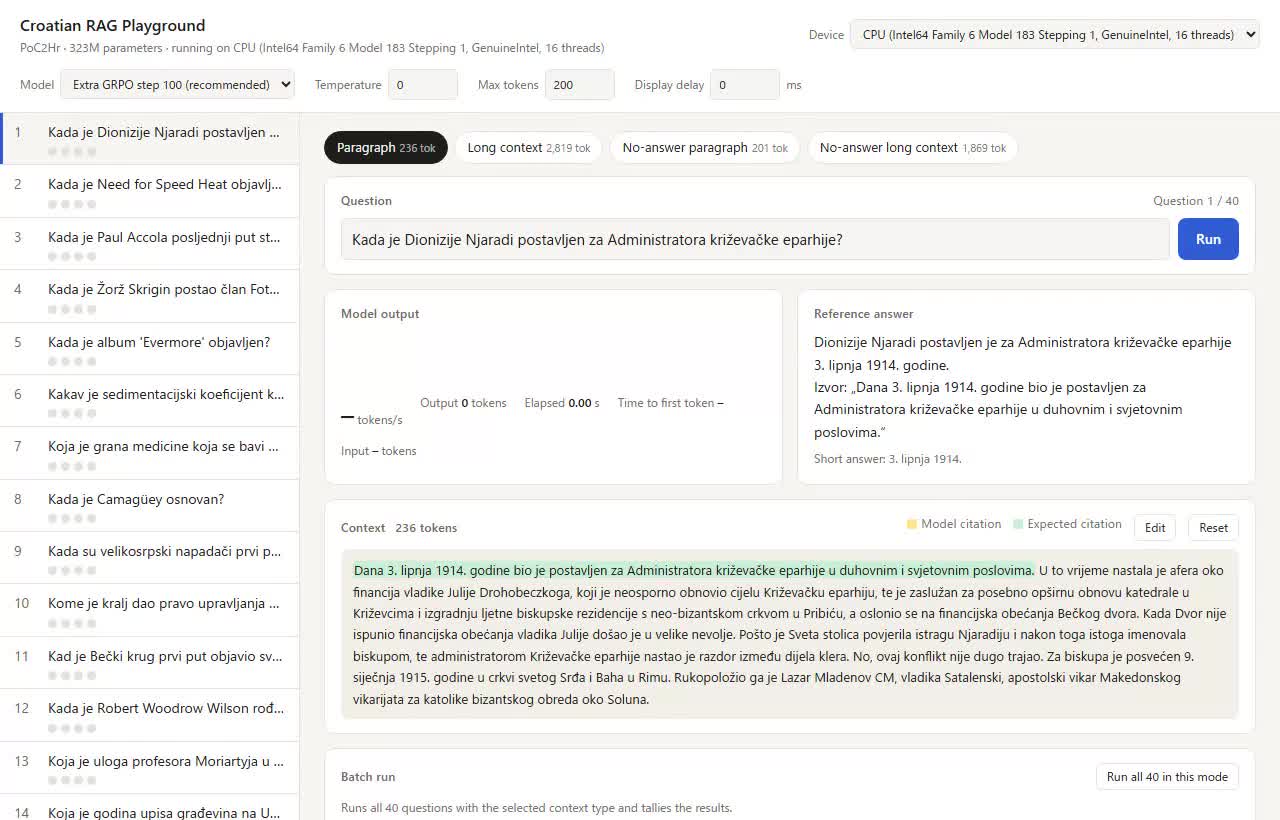
Contexto longo (3.215 tokens): cerca de 5 segundos para ler o texto, cerca de 5 tokens/s, 19 segundos no total. O amarelo marca a frase citada, e o modelo encontra corretamente uma frase certa entre 3.000 tokens
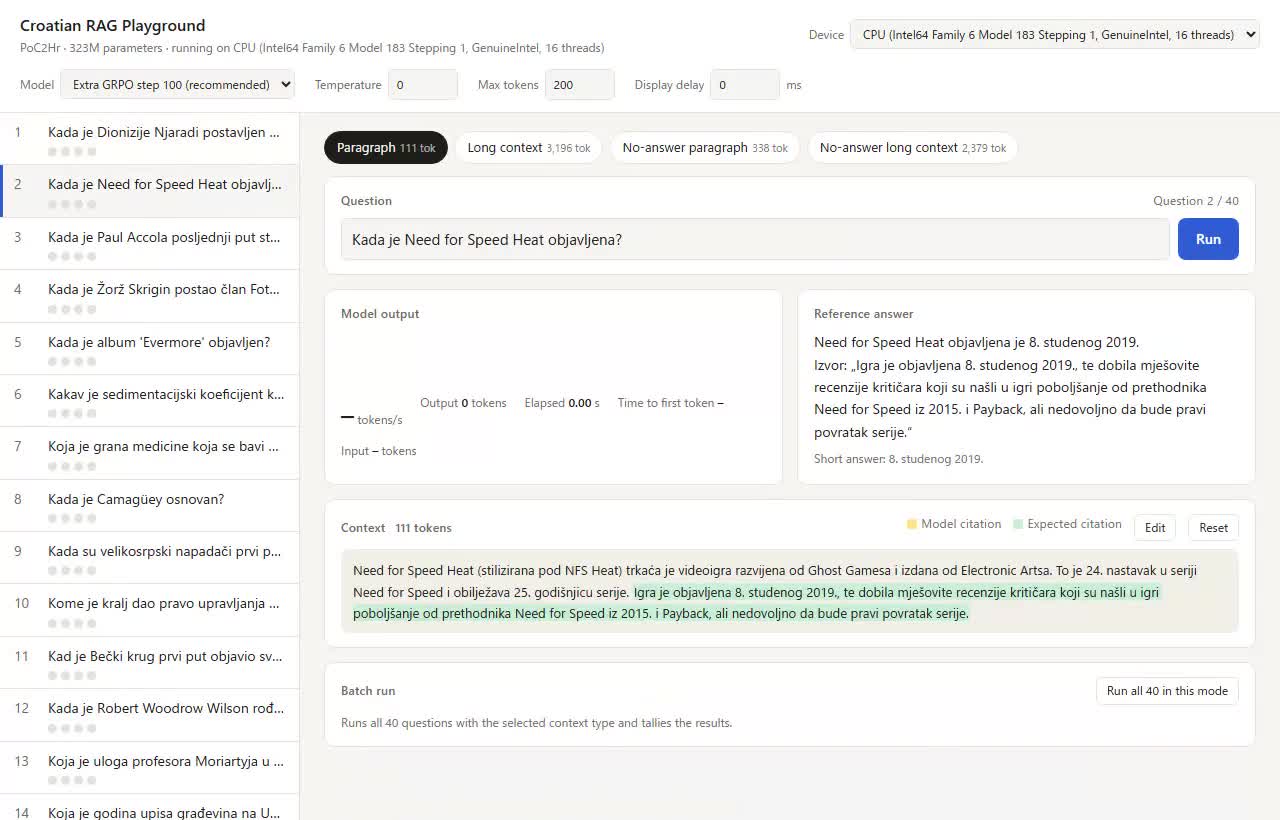
O vídeo ficou um pouco mais lento porque foi gravado durante a execução. Medindo 20 perguntas por vez sem gravar, obtive 15 tokens/s e 3,4 segundos por pergunta para parágrafos, e 7 tokens/s e 16 segundos por pergunta para contextos longos. Como as respostas são curtas, em torno de 50 tokens, parece uma velocidade prática até na CPU.
Considerações
- Para modelos pequenos, o mais importante é fazê-los dizer “não sei o que não sei”. Em RAG, reduzir invenções é mais eficaz do que aumentar a taxa de acerto. A combinação de citações + recusa + verificação externa funcionou muito bem
- 300 milhões é o limite para textos longos. Mesmo com 8 tentativas, o desempenho em textos longos chega apenas a 74%. Para buscar 90% em textos longos, provavelmente seriam necessários cerca de 1 bilhão de parâmetros
- Não basta verificar se “a citação realmente existe”. É preciso conferir se ela contém o número ou nome que responde à pergunta e se o sujeito é a mesma pessoa mencionada na pergunta
- Um modelo de 300 milhões que roda na CPU é ideal para perguntas e respostas sobre documentos que não podem ir para a internet. Em um notebook ou servidor sem GPU, ele pode responder com base apenas nos documentos locais. A velocidade é de alguns segundos a dezenas de segundos por pergunta e, com quantização, deve ficar ainda mais rápido (não verificado)
A próxima tentativa será uma versão de 1 bilhão de parâmetros, buscando 90% em contextos longos.