Criei um modelo croata de síntese de voz com 32 milhões de parâmetros. Comparando vozes ao longo do treinamento
Depois do LLM para RAG em croata, desta vez criei um pequeno modelo de síntese de voz (TTS) dedicado ao croata. O objetivo era fazê-lo funcionar em tempo real na CPU de um smartphone.
O método foi a “destilação”. Fiz um grande modelo de síntese de voz (HiggsAudio v3) ler roteiros em croata para criar dados de treinamento e, com eles, treinei um modelo pequeno do zero. Primeiro, fiz um treinamento piloto com 7,5 horas de dados e comparei como uma mesma frase mudava ao longo do treinamento.
Primeiro, a conclusão.
- Com 32 milhões de parâmetros (18,3 milhões do Matcha-TTS + 13,5 milhões do Vocos), ele realmente falou croata
- Após 50 minutos de treinamento (5.000 etapas), já lia conforme o roteiro. Depois disso, a principal melhora foi no “ruído”
- A taxa de erro de caracteres em 14 frases de avaliação foi de 0,9% ao final (10 das 14 frases corresponderam perfeitamente)
- Mesmo com 1 thread de CPU, foi possível gerar 1 segundo de áudio em 0,09 segundo (i7-13700K)
Demonstração: fazendo-o falar de verdade
Coloquei a versão final de 30.000 etapas do modelo deste artigo no playground de TTS em croata. Basta inserir qualquer texto em croata para que ele o leia na hora.
- Você pode escolher entre 50 frases de exemplo (cumprimentos, viagens, hospitais etc.) ou inserir até 1.000 caracteres próprios
- É possível alterar a velocidade da fala, a intensidade da entonação e o número de etapas de síntese. Ao fixar a seed, a mesma frase gera sempre o mesmo áudio
- A síntese roda apenas na CPU do servidor (ONNX Runtime; sem GPU ou APIs externas)
- Ele não lê números, então é preciso escrevê-los por extenso, como “dvadeset pet (25)”
O que fiz
1. Criar os roteiros: pedi ao Gemma 4 31B local que escrevesse falas de conversas cotidianas em croata. Defini aleatoriamente situação, interlocutor, emoção e extensão — por exemplo, “conversando com uma avó no mercado” ou “com medo depois de ouvir um barulho estranho no meio da noite” — em lotes de 22 linhas. A configuração era de uma única locutora na casa dos 30 anos. Misturei 23 tipos de emoção (normal, alegria, raiva, sussurro etc.).
2. Gerar o áudio: fiz o HiggsAudio v3 ler os roteiros com a voz de um áudio de referência de 16 segundos. Ao adicionar tags de emoção (como <|emotion:anger|>), ele realmente ficava bravo ou alegre. Criei 4.500 arquivos em cerca de 5 horas.
3. Inspecionar automaticamente: transcrevi os áudios com o Whisper large-v3 e os comparei aos roteiros, descartando erros de leitura. Também medi, com um modelo de reconhecimento de locutor, a proximidade da voz em relação ao áudio de referência, descartando casos em que a voz havia mudado. Foram aprovados 4.393 de 4.500 arquivos (97,6%). Após cortar os silêncios no início e no fim, restaram 7,46 horas.
4. Treinar o modelo pequeno: treinei o Matcha-TTS (um TTS baseado em flow matching) em uma RTX 4090 por 5 horas, cerca de 30 mil etapas. Para a parte que reconverte em forma de onda de áudio, o vocoder, usei o Vocos público sem alterações.
O croata é uma língua que, em grande parte, se lê como se escreve, então usei os caracteres diretamente como entrada, sem convertê-los em símbolos fonéticos. No entanto, lj, nj e dž são sons únicos, por isso foram agrupados como um só caractere.
Comparando os áudios durante o treinamento
Sintetizei, com modelos em diferentes estágios de treinamento, uma frase que não fazia parte dos dados de treinamento: “Molim Vas, možete li mi reći koliko košta ova haljina?” (Com licença, quanto custa este vestido?).
etapa 5.000 (cerca de 50 minutos após o início do treinamento)
etapa 10.000 (cerca de 1 hora e 40 minutos)
etapa 15.000 (cerca de 2 horas e 20 minutos)
etapa 20.000 (cerca de 3 horas e 10 minutos)
etapa 30.000 (cerca de 5 horas, final)
Como referência, um dos áudios de treinamento criados pelo HiggsAudio, que fez o papel de professor (outra frase: “Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.”).
Na transcrição pelo Whisper, essa frase foi idêntica ao roteiro, caractere por caractere, desde a etapa 5.000 até o fim. Em outras palavras, o modelo já conseguia dizer o conteúdo certo desde o início.
A diferença está na limpeza do som. Pela impressão auditiva, a etapa 5.000 tinha um ruído áspero, que diminuiu bastante na etapa 10.000. Isso fica bem claro ao observar espectrogramas do mesmo áudio (tempo no eixo horizontal, frequência no vertical).
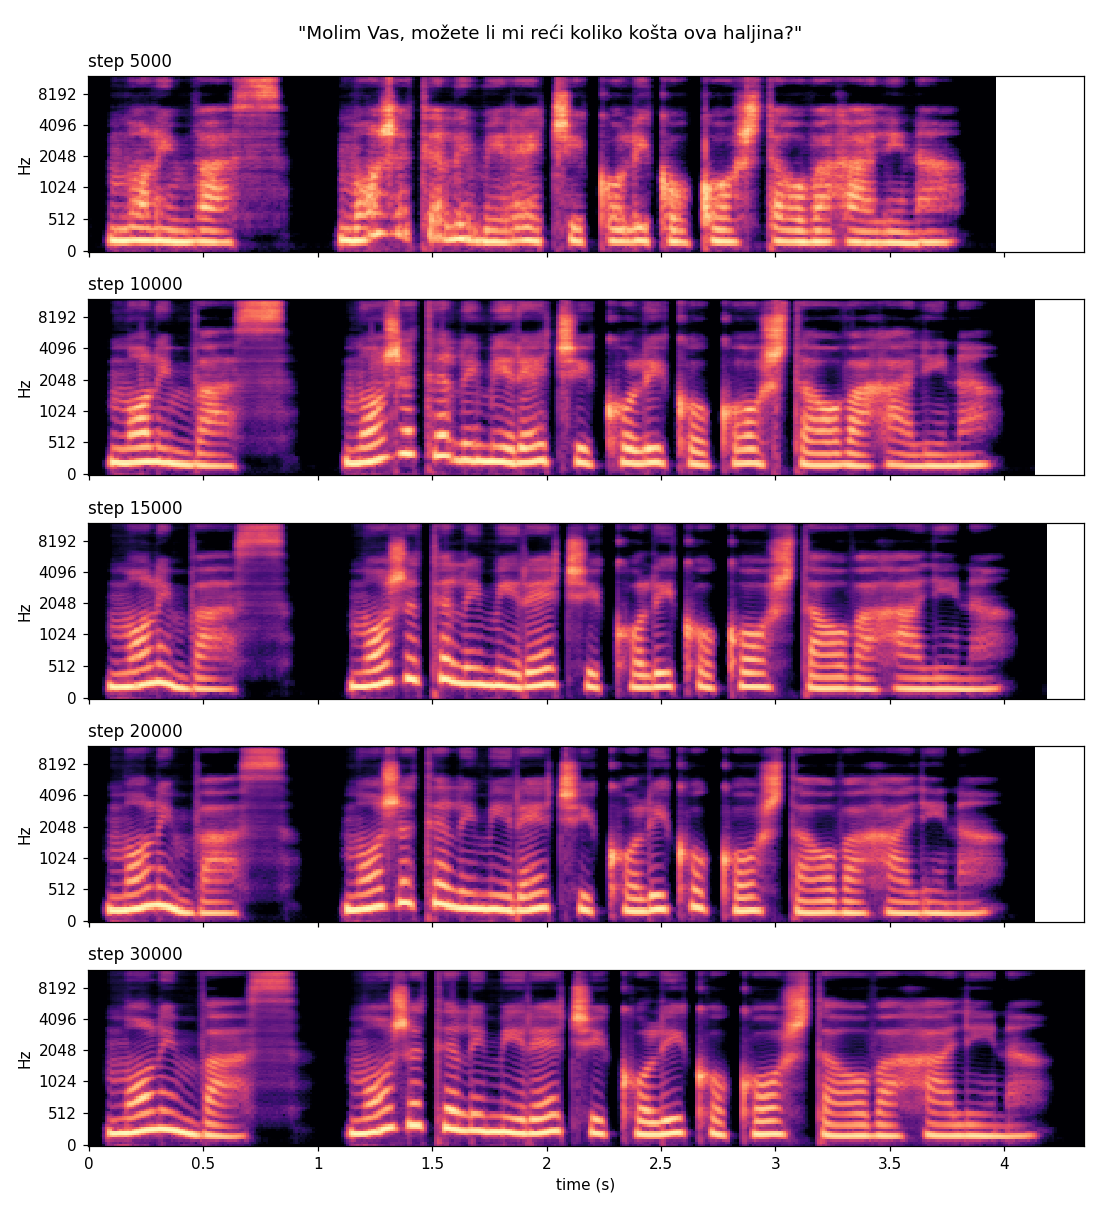
As faixas horizontais alinhadas à altura da voz (harmônicos) estão borradas na etapa 5.000, e os espaços entre elas parecem preenchidos por uma névoa. Essa é a parte que soa como ruído. A partir da etapa 10.000, as faixas ficam nítidas e os espaços escurecem. Conforme o treinamento avança, as faixas passam a formar curvas suaves para cima e para baixo; os movimentos da altura da voz, ou seja, a entonação, também parecem ficar mais claros.
Em números
Transcrevi 14 frases de avaliação — todas fora dos dados de treinamento — com o Whisper large-v3 e medi a taxa de erro de caracteres (CER). Elas incluem desde cumprimentos curtos até monólogos de cerca de 16 segundos.
| Etapas | Tempo de treinamento | Taxa de erro de caracteres | Correspondência perfeita |
|---|---|---|---|
| 5.000 | Cerca de 50 min | 1,1% | 9 / 14 |
| 10.000 | Cerca de 1 h 40 min | 3,4% | 8 / 14 |
| 15.000 | Cerca de 2 h 20 min | 0,7% | 11 / 14 |
| 20.000 | Cerca de 3 h 10 min | 0,9% | 11 / 14 |
| 30.000 | Cerca de 5 h | 0,9% | 10 / 14 |
- O resultado pior na etapa 10.000 ocorreu quase inteiramente porque, na frase “Bok!” (Oi!), o sistema ouviu “Vok”. Como é uma diferença de 1 caractere em 3, só essa frase tem uma taxa de erro de 33%. Ouvindo, a etapa 10.000 era muito mais limpa do que a 5.000. A taxa de erro de caracteres só mede se o texto foi lido corretamente, portanto a qualidade sonora só pode ser julgada ouvindo
- Os erros que restaram até o fim foram đ e dž em “Đak je pojeo džem” (O aluno comeu geleia). São sons pouco frequentes até no croata, e foram reconhecidos como “Žak” e “Džak”
Velocidade na CPU
Medi em um i7-13700K, com PyTorch sem otimização. É a média de três gerações de quatro frases, totalizando 47,6 segundos de áudio. RTF é “tempo gasto para gerar ÷ duração do áudio”; quanto menor, mais rápido.
| Número de threads | Número de etapas | Matcha | Vocos | RTF total |
|---|---|---|---|---|
| 1 | 2 | 0,042 | 0,025 | 0,067 |
| 1 | 4 | 0,067 | 0,025 | 0,092 |
| 4 | 4 | 0,032 | 0,010 | 0,042 |
| 8 | 4 | 0,028 | 0,007 | 0,036 |
O “número de etapas” é a quantidade de iterações que transformam ruído em áudio durante a síntese; as comparações auditivas acima foram geradas com 4 etapas. Mesmo com uma thread, é possível produzir 1 segundo de áudio em 0,09 segundo. A CPU de um smartphone será mais lenta, mas parece que ainda caberá em tempo real (ainda não medi em um aparelho real, então é uma previsão).
Quantas horas de dados um TTS precisa?
Como foi possível chegar a esse ponto com 7,5 horas, pesquisei referências gerais.
- O LJSpeech em inglês, muito usado para TTS de uma única voz, tem cerca de 24 horas. O modelo oficial do Matcha-TTS também é treinado com ele
- O JSUT em japonês e o CSMSC em chinês têm cerca de 10 horas e são normalmente usados como corpus de uma única voz
- Para treinamento do zero, cerca de 1 hora é o limite inferior; dependendo do modelo, os erros de pronúncia aumentam
- Para ajustar um modelo pré-treinado, há um relato de que 30 minutos tiveram resultado semelhante a treinar do zero com 27 horas
Também encontrei uma pesquisa que treinou o Matcha-TTS apenas com voz sintetizada (Universidade Jiao Tong de Xangai, dezembro de 2025). Ela aponta que o desempenho melhora quanto maior for a variedade de textos, quanto mais limpo e sem ruído for o áudio e quanto mais consistente for o estilo de fala. Como dados sintéticos não têm ruído e mantêm um estilo de fala consistente, talvez sejam mais fáceis de treinar do que gravações reais para a mesma duração. O fato de termos chegado até aqui com 7,5 horas também parece apoiar essa ideia.
Onde enfrentei dificuldades
- O PC travou: o modelo de 31B usado para criar os roteiros acabou sendo carregado duas vezes na GPU, esgotando a VRAM. Desde então, a regra passou a ser “apenas um modelo carregado na GPU por vez”
- Gemma 4 pensando demais: cerca de dois terços da saída eram “raciocínio”. Ao desativá-lo, ficou aproximadamente três vezes mais rápido
- Alucinações do HiggsAudio: no primeiro teste, ele acrescentou espontaneamente “Hvala što pratite kanal” (Obrigado por acompanhar o canal) ao silêncio após a frase, criando um clipe de 81 segundos. Parece ter memorizado frases de encerramento do YouTube. Passei a descartar arquivos cuja duração divergia muito do esperado
- Matcha-TTS não funciona no Windows: algumas extensões em C não puderam ser compiladas, então reescrevi essa parte em Python (numba)