Experimentei usar previs com geração de vídeo por IA. Mesmo simples, vale a pena
Experimentei fornecer à geração de vídeo por IA um previs simples, feito com caixas e manequins. O previs é um vídeo rascunho usado para definir antecipadamente a posição e os movimentos das pessoas, além do trabalho de câmera.
Em resumo: funciona muito bem. Mas os detalhes não são reproduzidos exatamente como estão. Em vez disso, ao fornecer uma direção geral, a IA complementa o que falta de forma convincente. Ele foi útil como um projeto para isso.
Comparando o previs com o resultado gerado
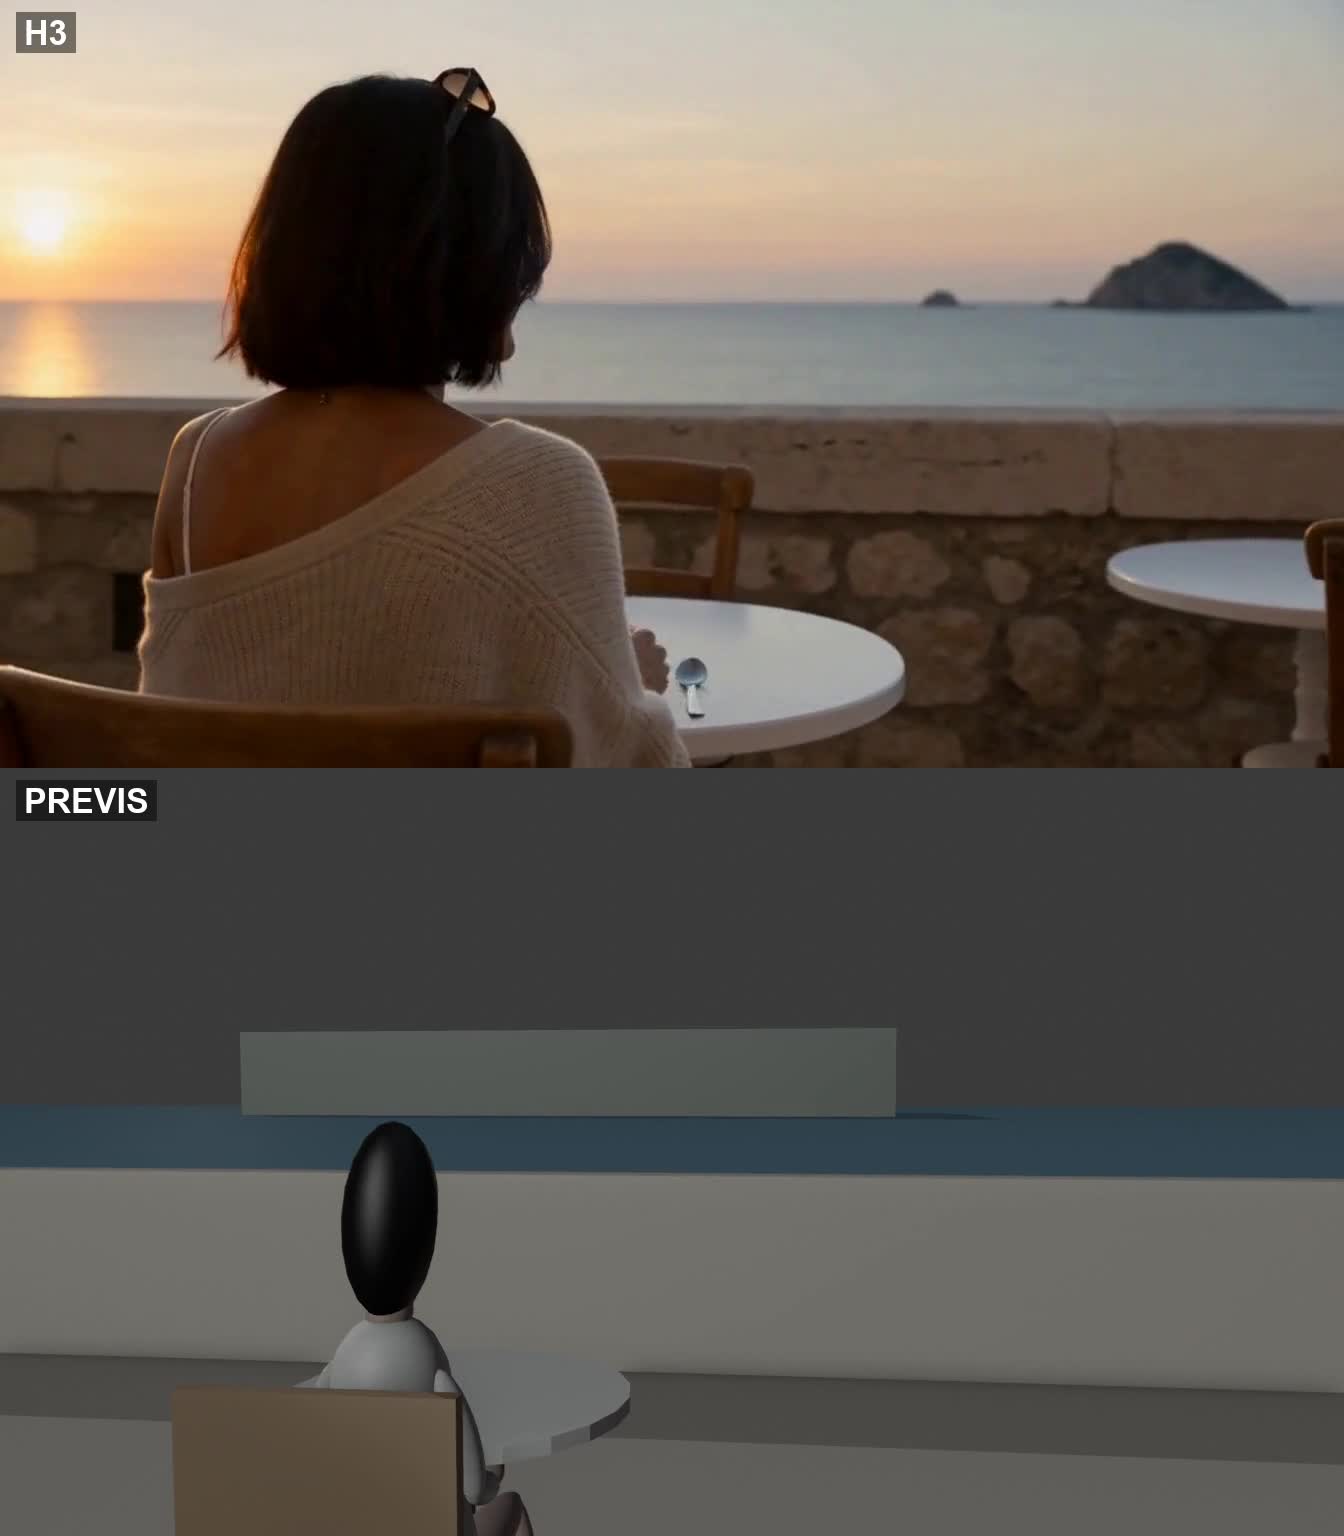
Em todos os vídeos, a parte de cima é o vídeo gerado por IA, e a de baixo é o previs original. Cada um tem cerca de 15 segundos. Estou testando até que ponto é possível transmitir o fluxo de uma cena sem elaborar cenários ou personagens.
Café à beira-mar
A partir de uma disposição simples de mesa e personagens, chegamos a um café ao entardecer. Movimentos como levar a bebida à boca foram transformados em imagens de estilo realista.
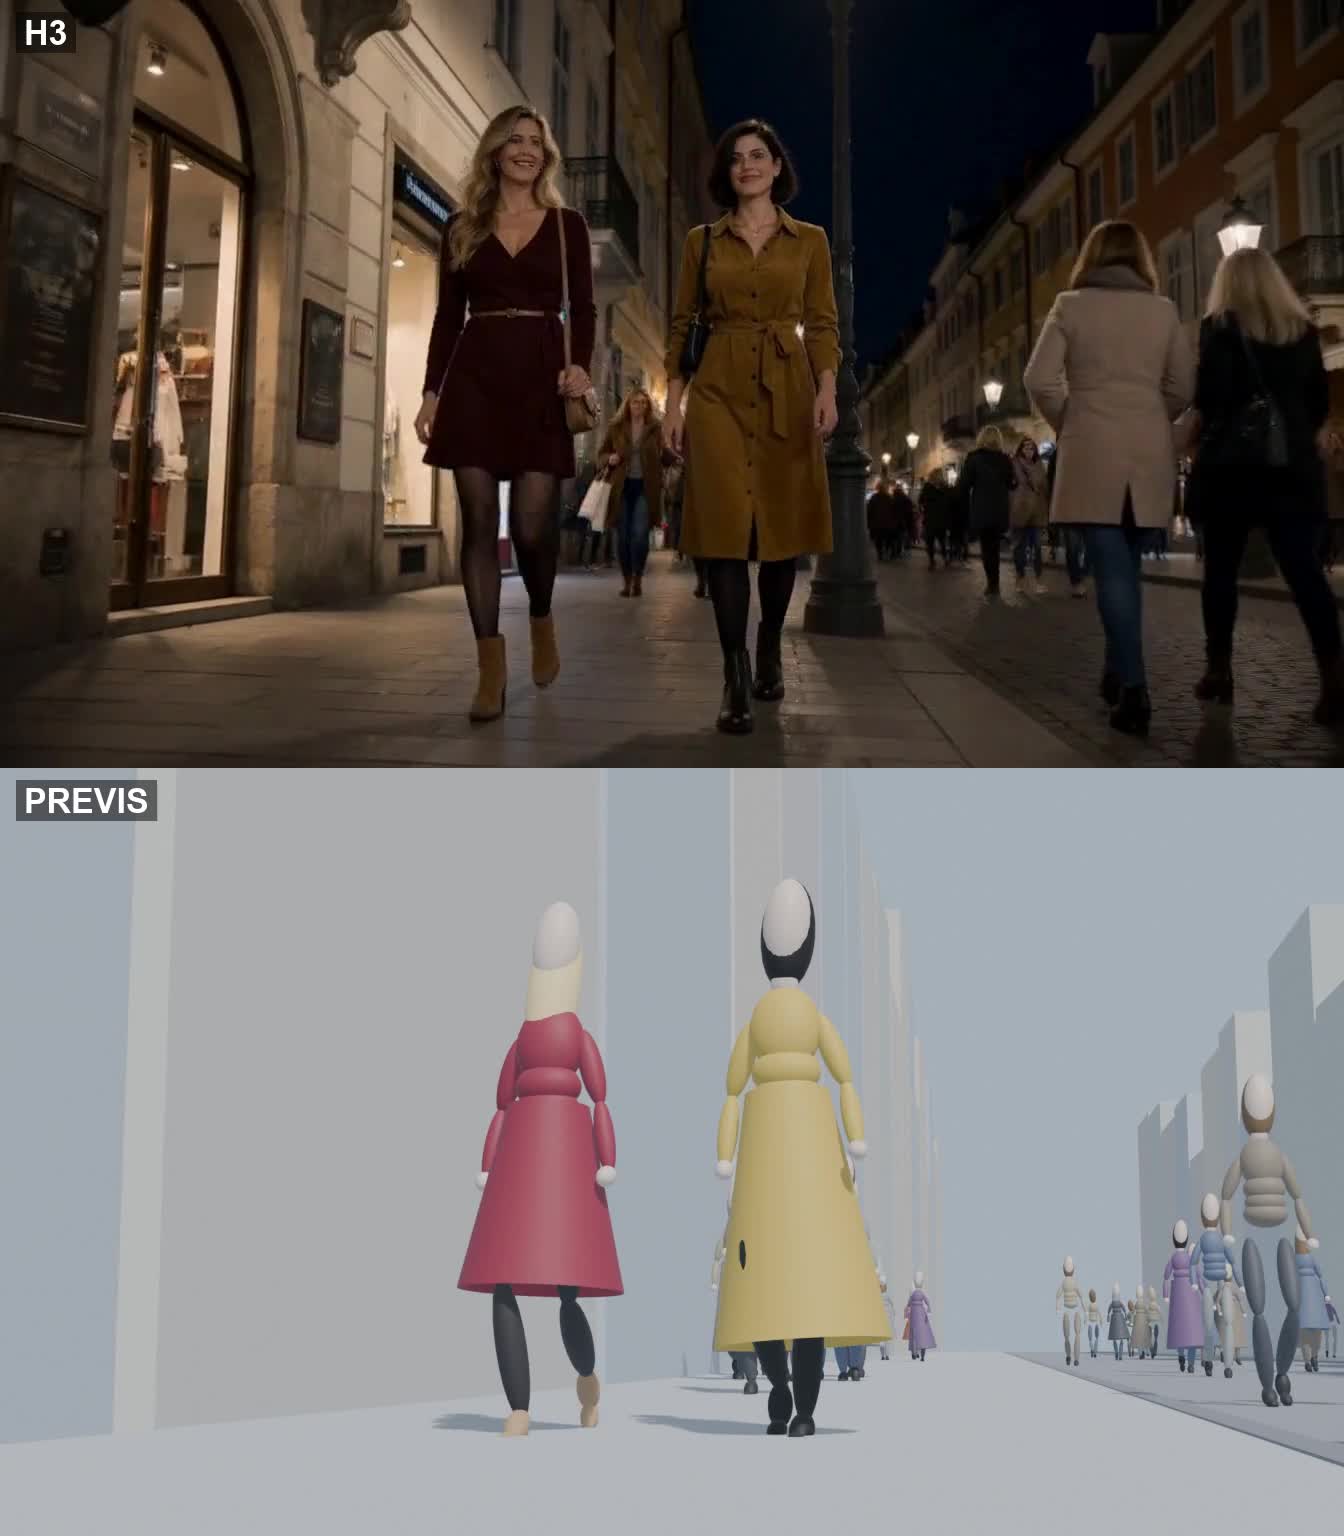
Caminhando pela cidade à noite
As posições dos personagens e a direção da caminhada foram definidas no previs. Uma paisagem urbana simples e clara, quase como durante o dia, foi transformada em uma cidade noturna com o prompt.
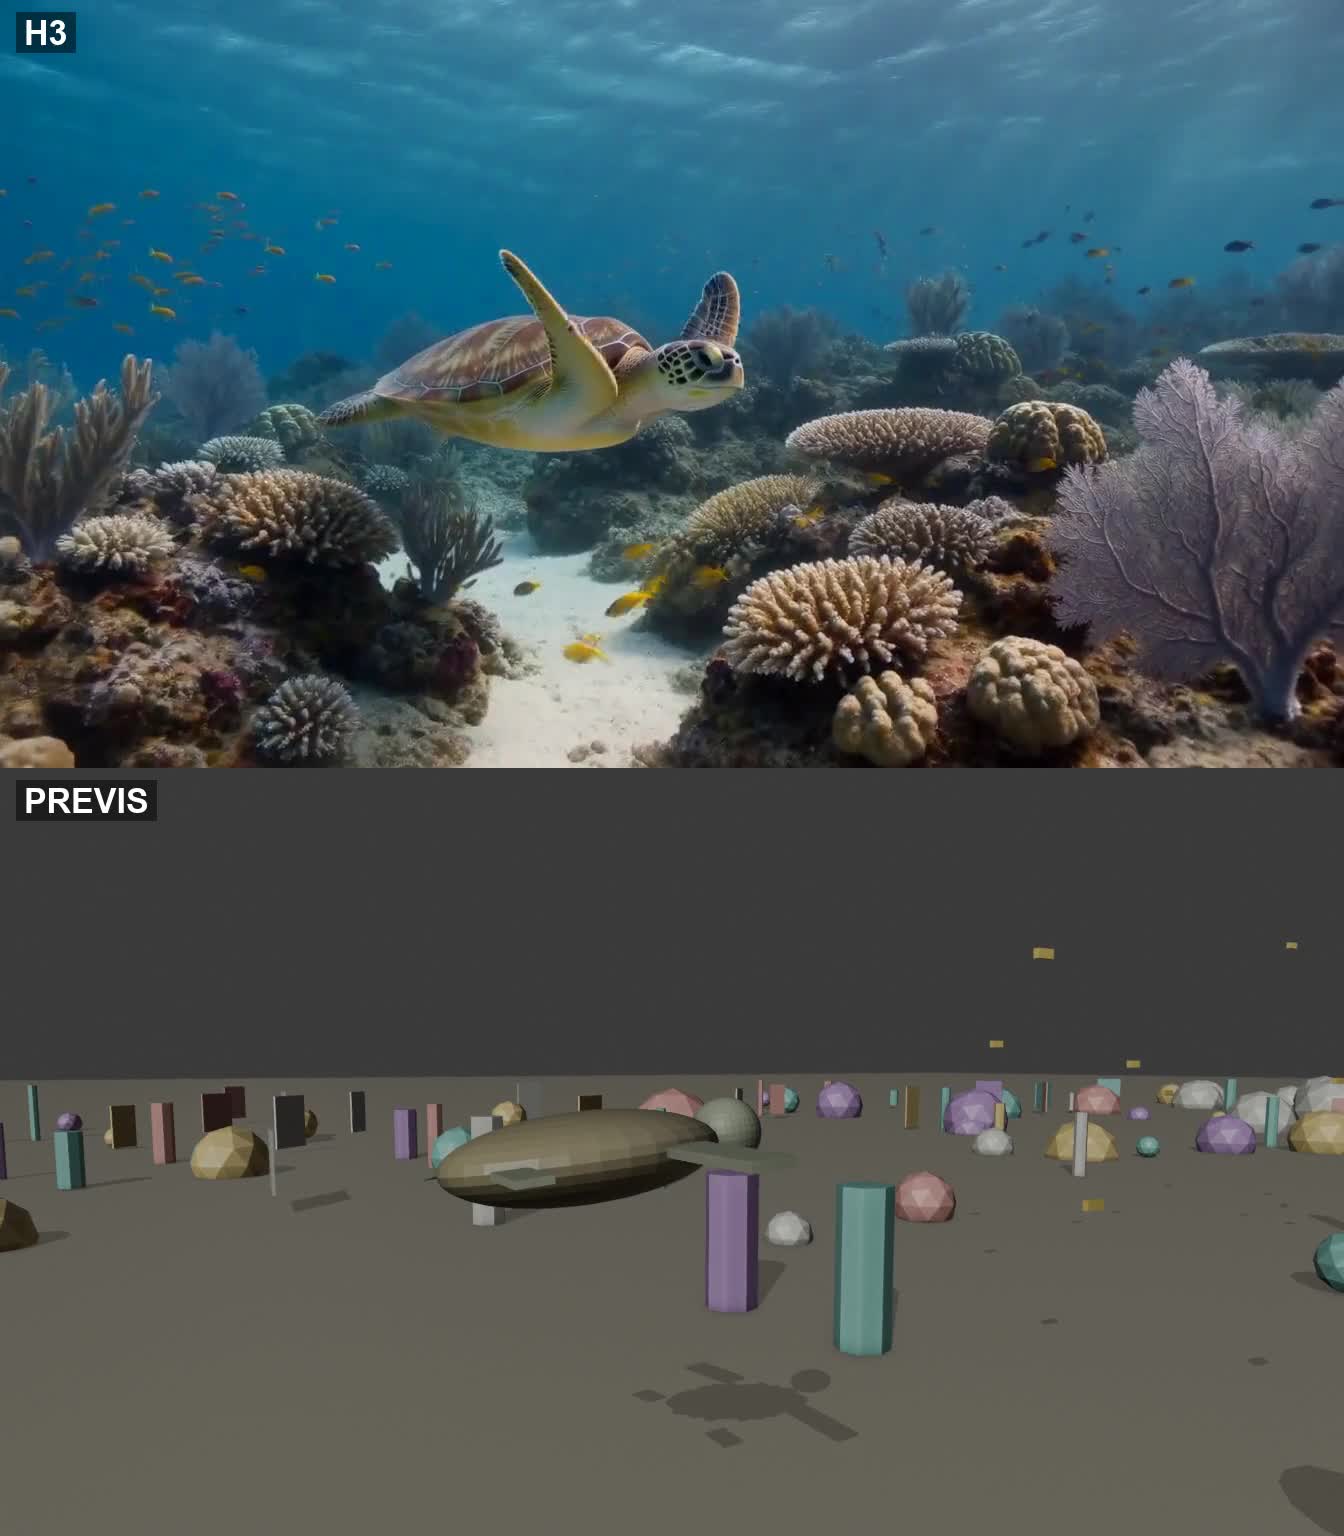
Tartaruga marinha submersa
A partir de um fundo do mar e do movimento aproximado da tartaruga, criamos uma paisagem com luz subaquática e corais. É um exemplo em que a complementação visual fica fácil de entender.
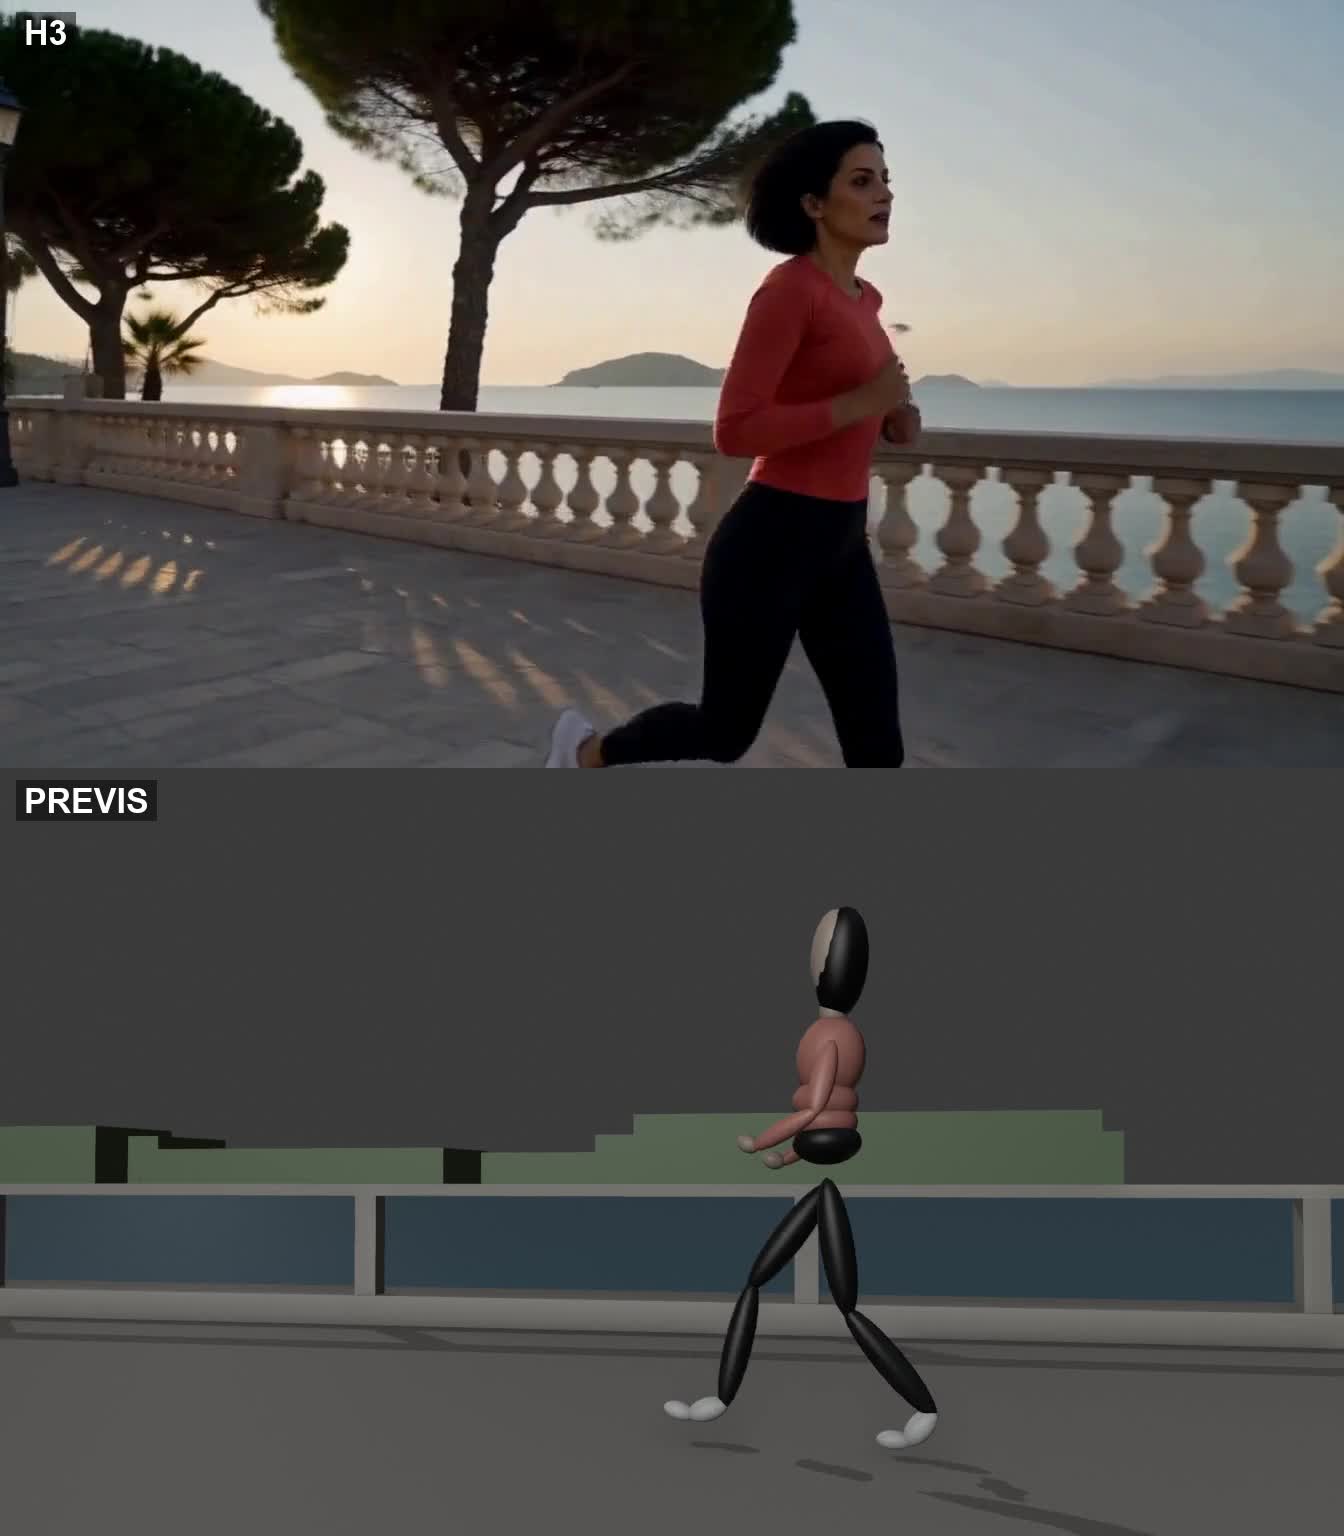
Corrida à beira-mar
Definimos uma pessoa correndo e o movimento da câmera que a acompanha. O cenário rascunhado foi substituído por um calçadão à beira-mar.
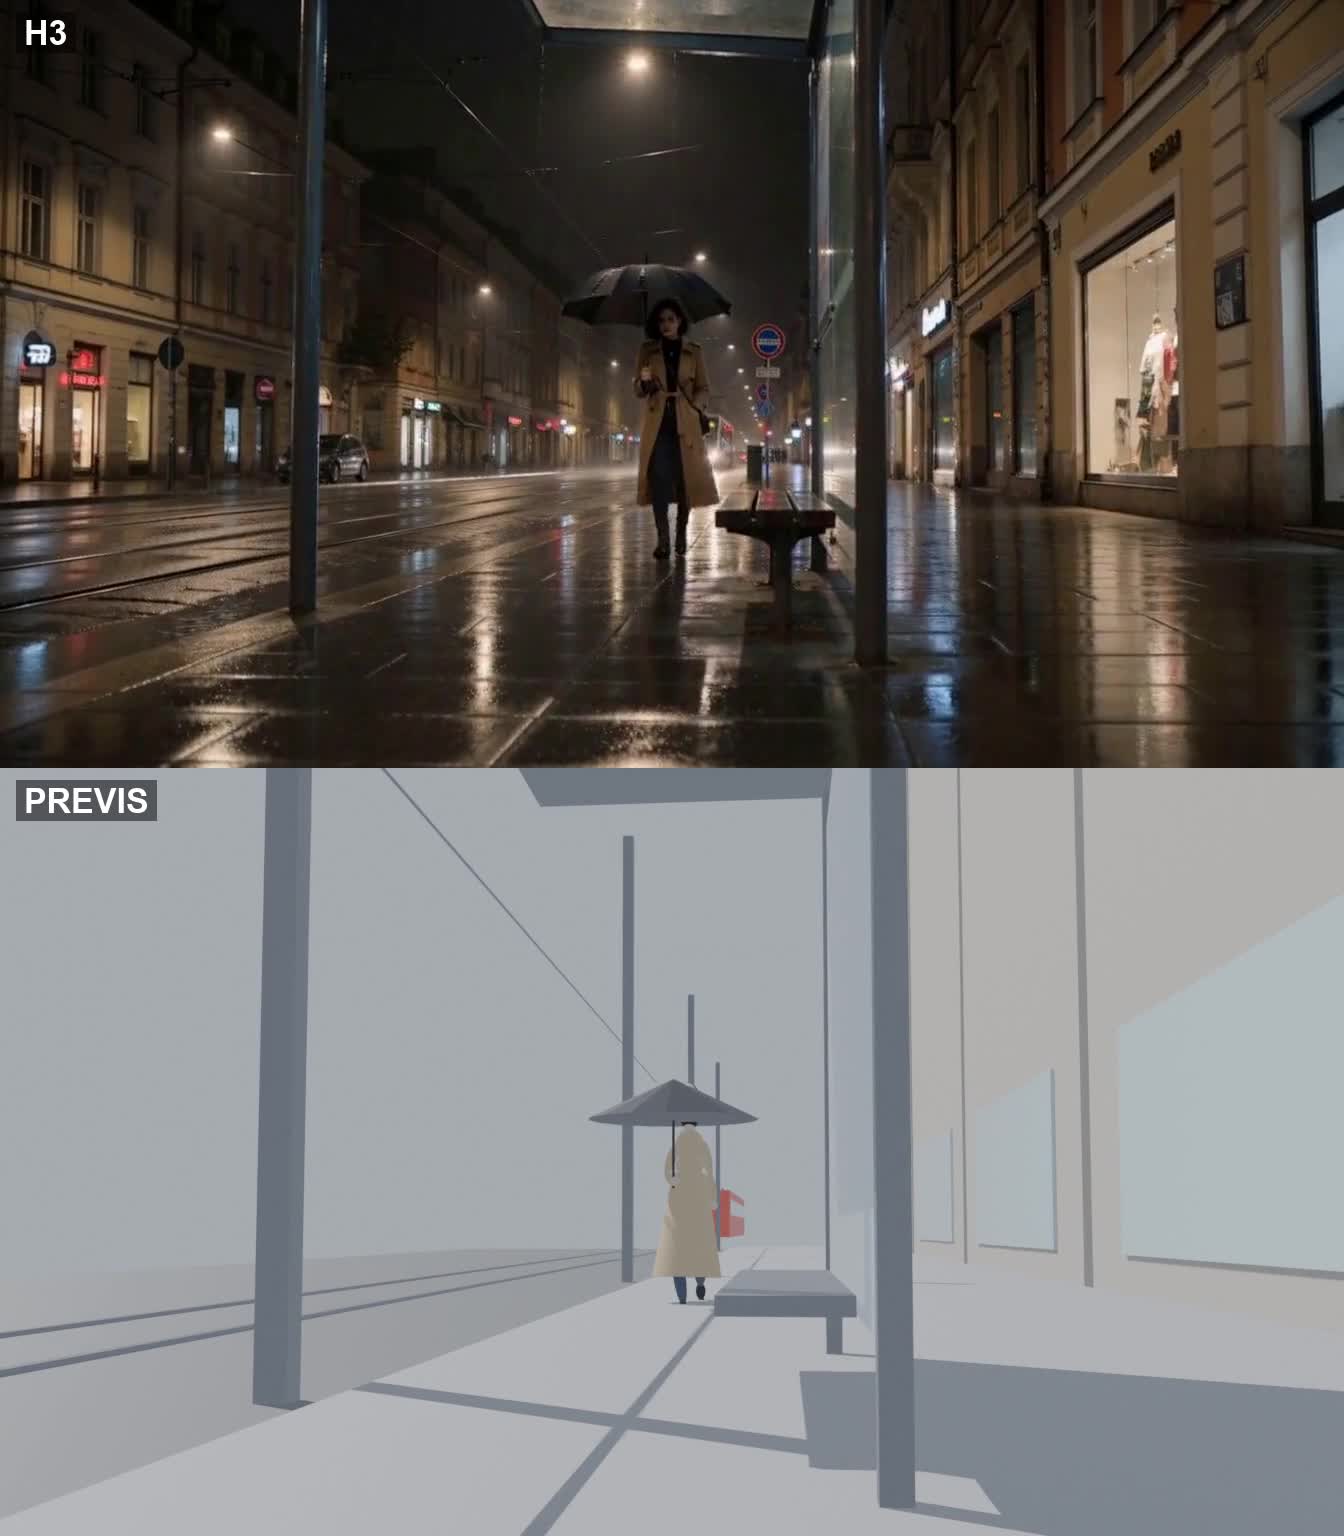
Cidade chuvosa e bonde
Com base na disposição de uma pessoa com guarda-chuva e de um bonde, adicionamos a atmosfera de uma noite chuvosa.
O processo é simples
Nesta produção, segui o fluxo abaixo.
- Com Python + Blender 4.2, criei um previs usando caixas e formas simples. Também usei o Mixamo para os movimentos dos personagens.
- Preparei imagens de referência de personagens e outros elementos com a geração de imagens do Codex.
- Enviei o previs, as imagens de referência e o áudio de referência ao MiniMax-H3 Ref2VA para gerar vídeos de cerca de 15 segundos.
- Preparei as falas com HiggsAudio v3, os efeitos sonoros com Stable Audio 3 Medium e a trilha sonora com ACE-Step 1.5; depois, fiz a mixagem e a edição com ffmpeg. Usei o Claude Code para os scripts de produção e o gerenciamento das execuções.
O ponto principal das instruções é separar o papel de cada referência: a imagem serve para o rosto e o figurino; o previs, para posicionamento, ações e movimento de câmera. Também é preciso informar que a aparência dos manequins e das caixas não deve ser mantida. O acabamento, como noite, chuva e iluminação, foi especificado em texto.
É útil, mas os detalhes mudam bastante
A posição dos personagens, a direção do deslocamento, a sequência das ações e o movimento geral da câmera são transmitidos com facilidade. Já indicações detalhadas, como “parar em determinado segundo” ou “dar um zoom de certa intensidade”, podem variar ou simplesmente não ser aplicadas. Não é possível fixar todos os detalhes com precisão.
Além disso, a cintilação da iluminação no previs ou cenários organizados de forma excessivamente regular às vezes permaneciam no resultado gerado. Parece melhor manter a iluminação e as formas do previs simples, concentrando-se no movimento que se deseja comunicar.
Ainda assim, é muito útil que ele complemente instruções gerais até chegar a imagens visualmente atraentes. Embora os detalhes possam mudar bastante, é suficiente para transmitir a direção geral da cena. A conclusão desta experiência é que não é necessário produzir um previs perfeito; mesmo simples, vale a pena usá-lo.