Guia completo do Qwen-Image 2.1: geração, edição e PNG transparente com 7B, com 100 exemplos comentados no Reddit
Em 20 de setembro de 2026, a equipe Qwen lançou o modelo de geração de imagens «Qwen-Image 2.1». Seu principal diferencial é reunir em um único modelo a geração de imagens a partir de texto, a edição com imagens de referência, a composição de múltiplas imagens, a edição local e a geração e edição com fundo transparente (RGBA). A parte geradora de imagens tem 7 bilhões de parâmetros. Em vez de perseguir apenas modelos cada vez maiores, o projeto busca um tamanho e uma eficiência de processamento mais adequados a ambientes locais.
Em resumo, o Qwen-Image 2.1 é mais interessante não como um modelo que cria a melhor imagem possível do zero, mas como um modelo de produção que evita destruir demais imagens existentes, combina vários materiais e altera precisamente as áreas desejadas. No Reddit, os maiores elogios se concentram em edição, consistência de personagens, composição de produtos, outpainting e materiais transparentes. Por outro lado, também há relatos claros de fraquezas em mãos e dedos, rostos ao fundo, ruído em detalhes, pretos excessivamente fechados, restauração de fotos antigas e estilos de anime.
Este artigo organiza todos os recursos com base nas informações oficiais e, cruzando os principais tópicos do Reddit, reúne os testes de geração e edição que ganharam destaque em uma seleção de «100 exemplos». O número 100 não significa 100 publicações independentes: ele conta temas individuais de criação e operações de edição testados em várias publicações populares, galerias e fluxos de trabalho.
O que é o Qwen-Image 2.1
Qwen-Image 2.1 é um modelo integrado de geração e edição de imagens da família Qwen. Segundo a descrição oficial, sua parte geradora adota um Single-Stream DiT de 32 camadas e 7 bilhões de parâmetros. O Qwen3-VL 8B converte instruções textuais e imagens condicionais em uma representação comum, enquanto o VAE RGBA de 64 canais oferece compressão espacial de 16× e transparência nativa.
As quatro melhorias destacadas oficialmente são as seguintes.
- Compacto e eficiente: atenção de granularidade mista e reutilização de prefix KV cache melhoram o equilíbrio entre qualidade e custo computacional.
- Geração e edição unificadas: imagens comuns e transparentes podem ser geradas e editadas pelo mesmo modelo.
- Edição versátil: suporta até 10 imagens de referência, indicação local por máscaras ou anotações desenhadas e preservação da identidade de pessoas e produtos.
- Texturas e estética: melhora tipografia, iluminação de retratos e texturas sutis.
Fontes: blog oficial da Qwen, GitHub oficial, documentação do Diffusers
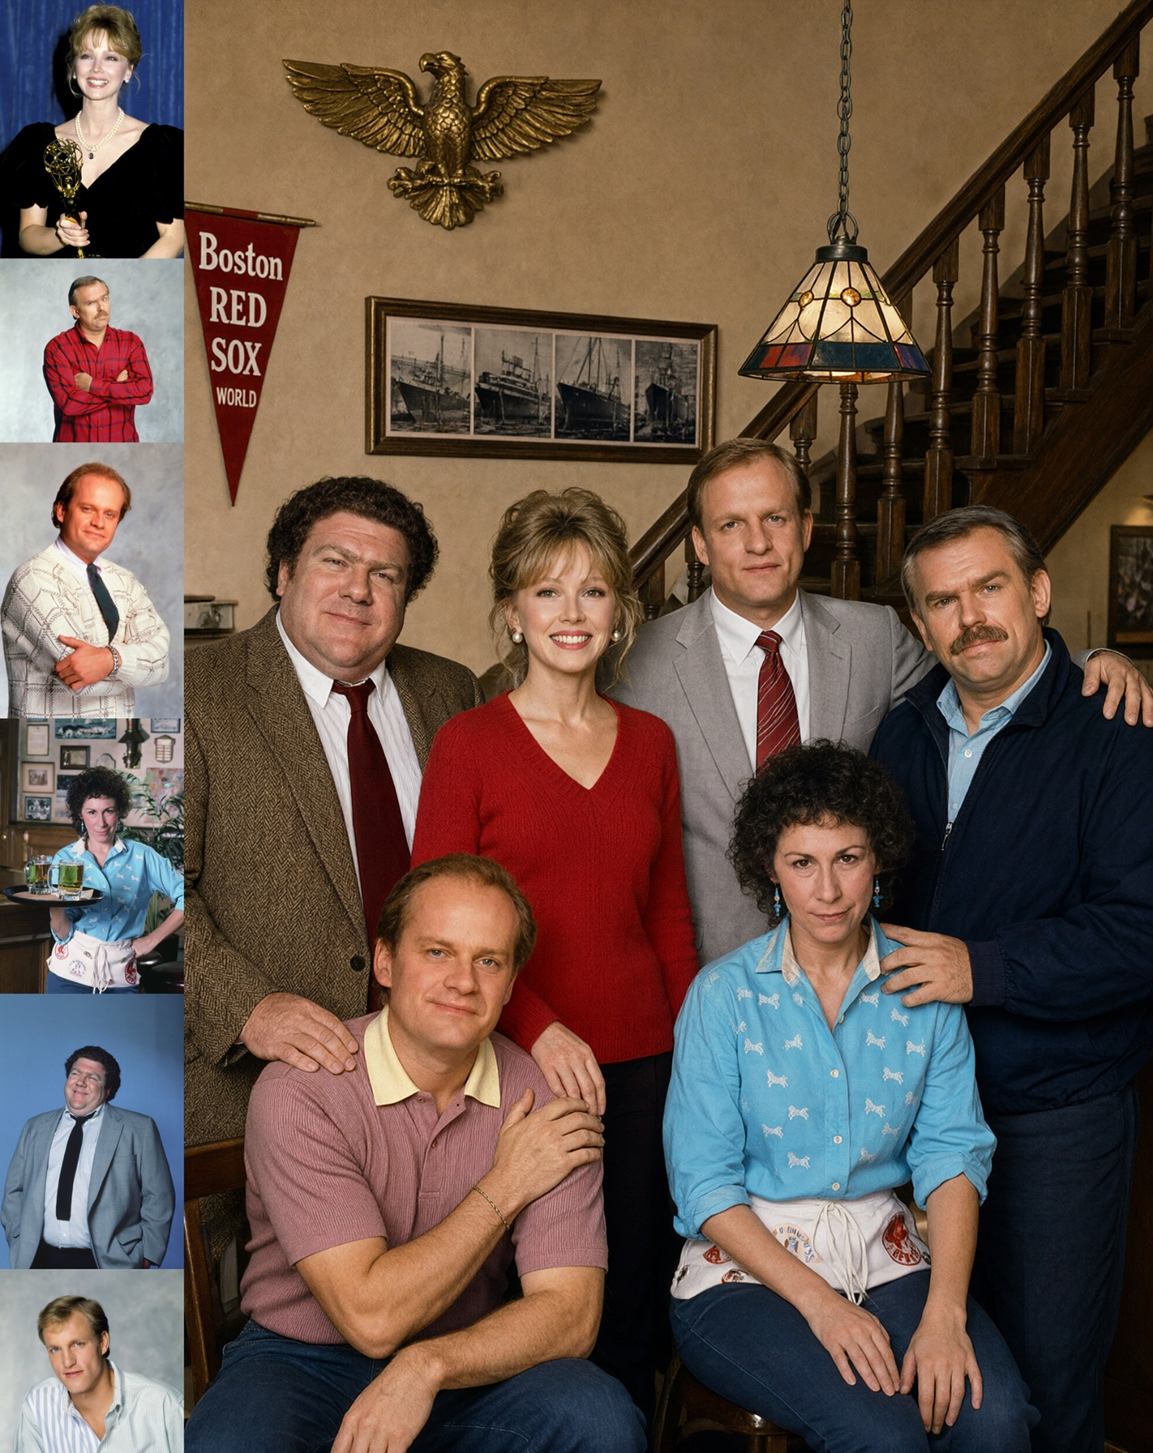
Todos os recursos organizados
1. Geração de imagens a partir de texto
Suporta o fluxo normal Text-to-Image. Além de instruções curtas, consegue lidar, via Qwen3-VL, com textos naturais longos e instruções complexas contendo composição, luz, materiais, primeiro plano, fundo e elementos textuais. Os exemplos oficiais usam 40 passos como padrão, mas a comunidade também testa LoRAs rápidos de 8 a 16 passos e configurações de 30 a 40 passos voltadas à qualidade.
2. Edição de imagens
É possível fornecer simultaneamente uma imagem de entrada e uma instrução para alterar cor, clima, fundo, roupas, pose, materiais, iluminação, ângulo de câmera e outros aspectos. No Reddit, muitos consideram a edição mais forte que o T2I puro.
3. Até 10 imagens de referência
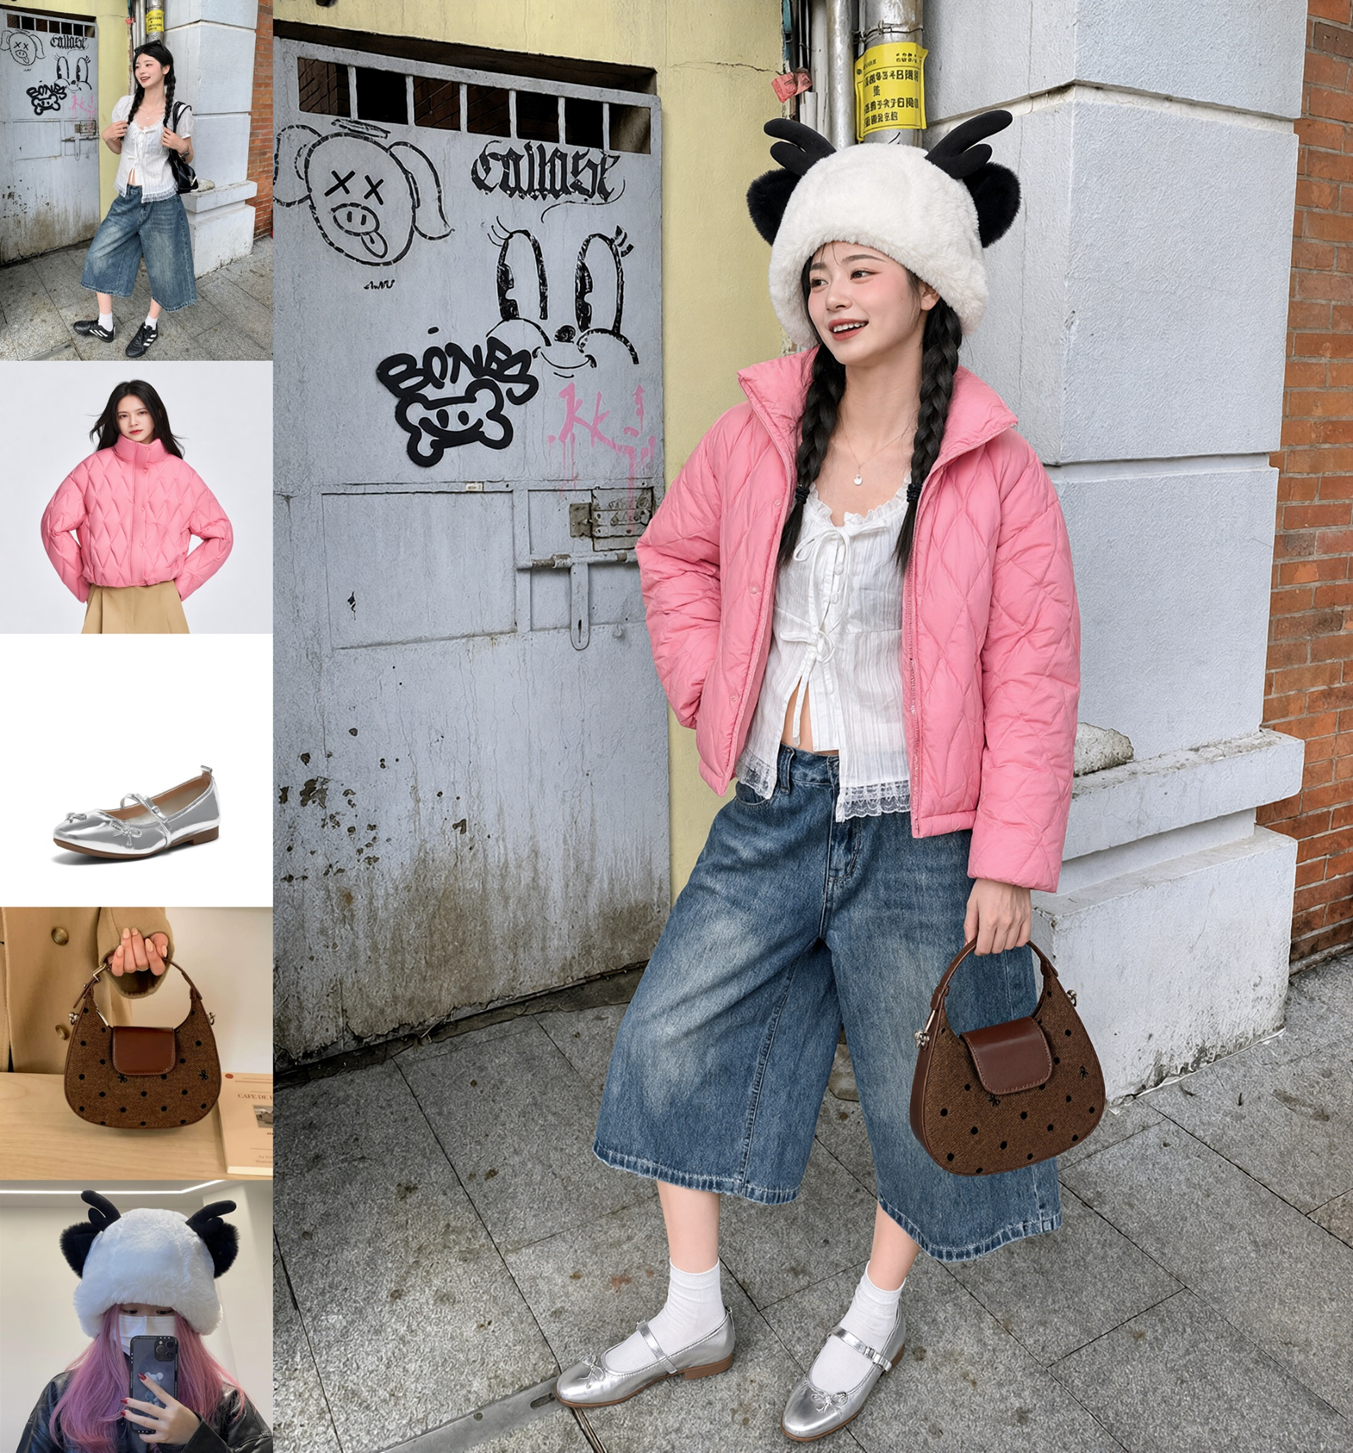
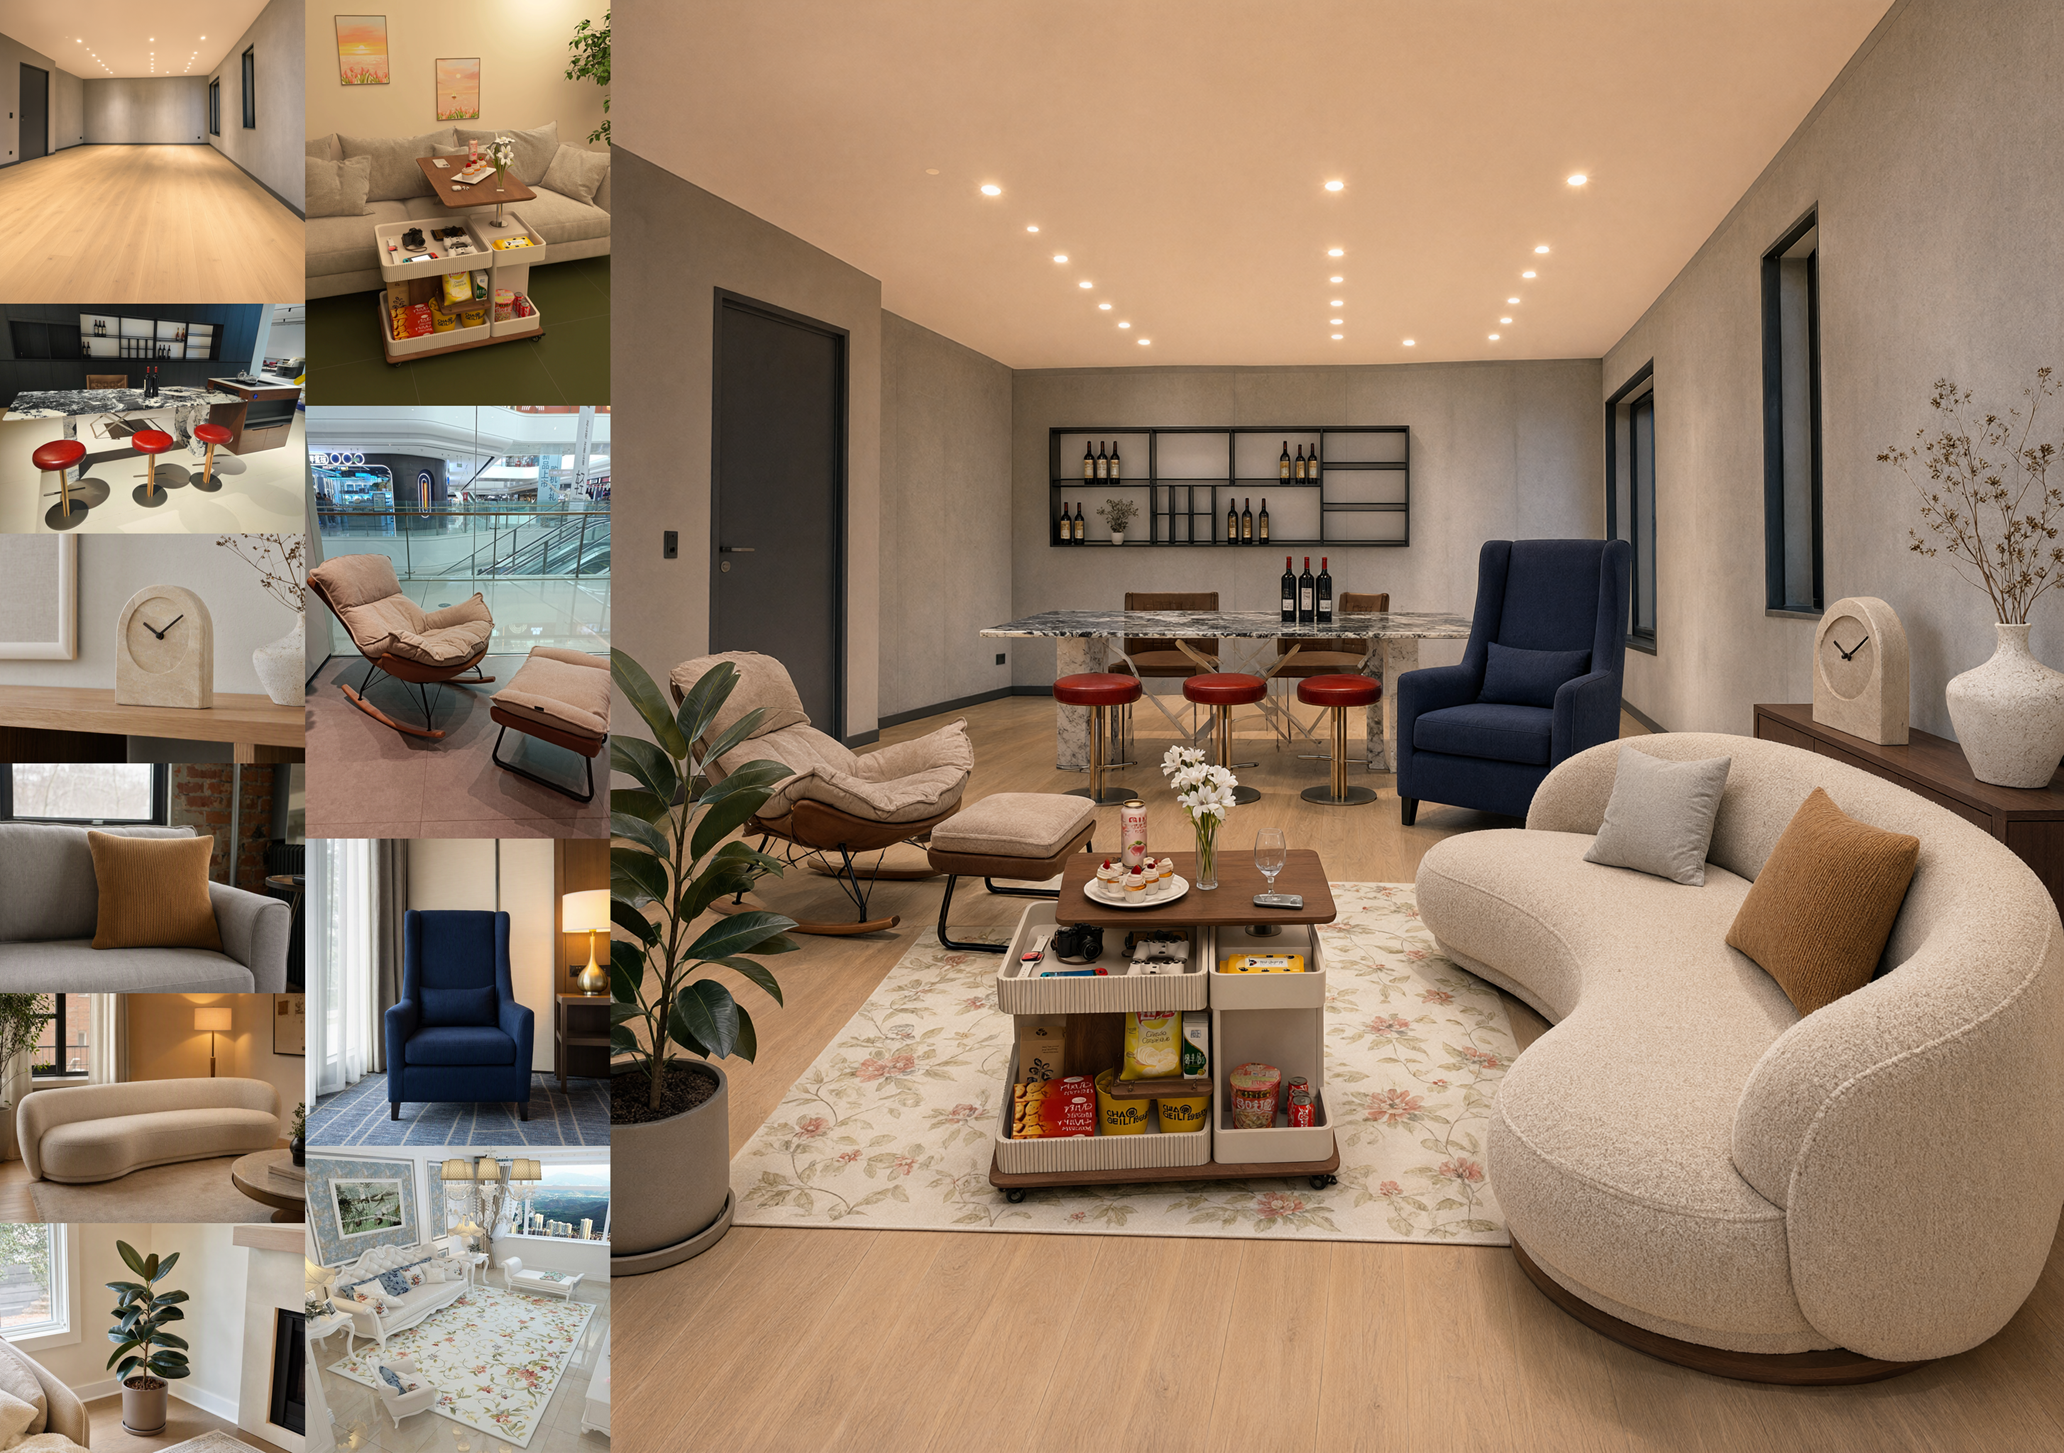
Pessoas, roupas, sapatos, bolsas, chapéus, móveis e produtos podem ser extraídos de imagens separadas e integrados a uma única cena. Os exemplos oficiais incluem uma foto de grupo que reúne seis rostos, prova virtual com cinco materiais e design de interiores com dez peças de mobiliário. Porém, a comunidade também relata que, quanto mais referências se usam, maior a chance de instruções conflitantes e mistura de atributos.
4. RGBA nativo e fundo transparente
Em vez de apenas remover o fundo no pós-processamento, o modelo pode gerar diretamente imagens que incluem um canal de transparência. Isso serve para recortar um sujeito de uma foto, editar a forma de um material transparente e criar assets transparentes com múltiplos elementos.
5. Edição local e por máscara
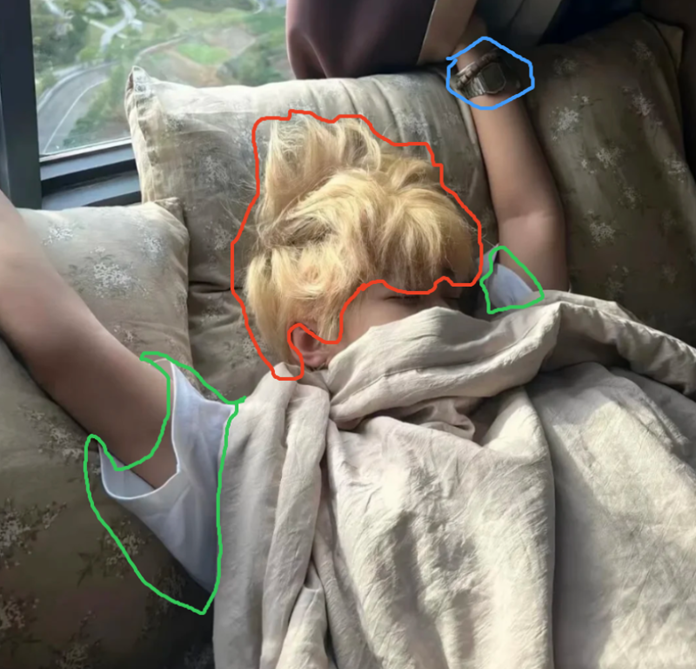
É possível indicar as áreas a modificar com círculos, anotações preenchidas ou máscaras independentes. No ComfyUI, usuários pintam cores sobre a imagem e testam instruções como «mude apenas a roupa na área vermelha». Em combinação com LanPaint, também é possível fazer inpainting do próprio canal alfa, não só das cores.
6. Outpainting
O canvas pode ser ampliado para cima, baixo, esquerda ou direita, preenchendo as áreas vazias de acordo com o contexto da imagem original. No Reddit, chamou atenção o relato de que é possível expandir várias direções de uma vez, mais rapidamente que fluxos de trabalho especializados convencionais.
7. Preservação de identidade
O uso principal é preservar rosto, roupa e pose de pessoas, ou formato e elementos de marca de produtos, enquanto se alteram apenas o fundo ou certos atributos. É especialmente comentado para fichas de personagens e produção de tomadas contínuas, embora ângulos extremos, expressões fortes e sequências longas exijam testar a deriva.
8. Renderização de texto e design
Suporta imagens com pôsteres, embalagens, sinalização e tipografia. É popular o fluxo em que um LLM externo organiza composição, hierarquia de informação, tamanho das letras e espaços em branco antes de enviar a instrução. Ainda assim, há relatos de caracteres chineses indesejados aparecendo em infográficos em inglês.
9. Reescrita de prompts
O repositório oficial inclui reescritores de prompt para T2I e I2I. Eles expandem pedidos curtos em composições detalhadas e, na edição, reescrevem a instrução para preservar tudo o que não deve mudar. A comunidade relata que, em alguns casos, modelos específicos por finalidade funcionam melhor que a reescrita padrão.
10. Aceleração, economia de memória e quantização
Há suporte a CPU offload do Diffusers, prefix KV cache do vLLM-Omni, CUDA Graph, FP8, paralelismo de tensores e offload de memória e kernels otimizados do SGLang. Para ComfyUI, surgiram variantes BF16, INT8 ConvRot, GGUF e de 4 bits. Há relatos de cerca de 2× mais velocidade com LoRA de 4 passos e de nós personalizados que executam expansão de prompt com 8 GB de VRAM, mas é essencial confirmar a troca entre velocidade e qualidade.
11. Ambientes compatíveis
São indicados a implementação oficial, Hugging Face Diffusers, ComfyUI, vLLM-Omni, SGLang-Diffusion, LightX2V e ModelScope. Também são apresentados exemplos ROCm para AMD Radeon e compatibilidade com múltiplos chips via FlagOS.
12. Atenção à licença
Os pesos do modelo são públicos, mas ele não é fornecido sob Apache 2.0: utiliza a «Qwen Research License Agreement». A licença oficial declara explicitamente que o uso comercial requer uma licença comercial separada. Há também obrigação de notificação na redistribuição e a exigência de indicar «Built with Qwen» ou «Improved using Qwen» na documentação de modelos de IA derivados. Confira sempre o texto original antes de adotá-lo em atividades profissionais.
Fonte: licença oficial
50 perspectivas nos exemplos oficiais
Aqui apresentamos 50 exemplos, principalmente amostras oficiais do Qwen-Image 2.1 divulgadas pela equipe Qwen, relacionando-os aos pontos mais debatidos no Reddit. A seleção não traz apenas «uma imagem bonita»: inclui entradas, resultados editados, máscaras, múltiplas referências, mudanças de câmera e geração de documentos, para mostrar em que etapas de produção o modelo pode ajudar.
Materiais transparentes e geração de ilustrações
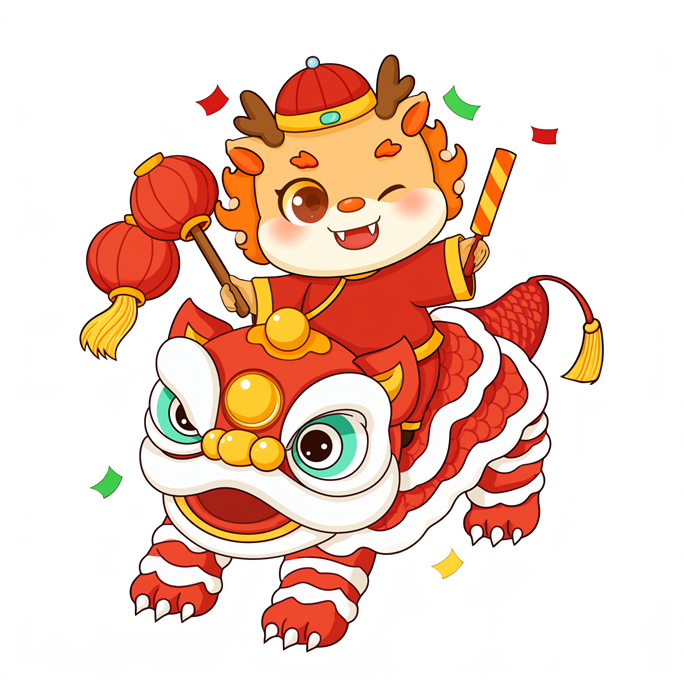
Exemplo 1: ilustração transparente com motivo de dança do leão. Exemplo de manipulação simultânea de ornamentos detalhados no contorno e fundo alfa.
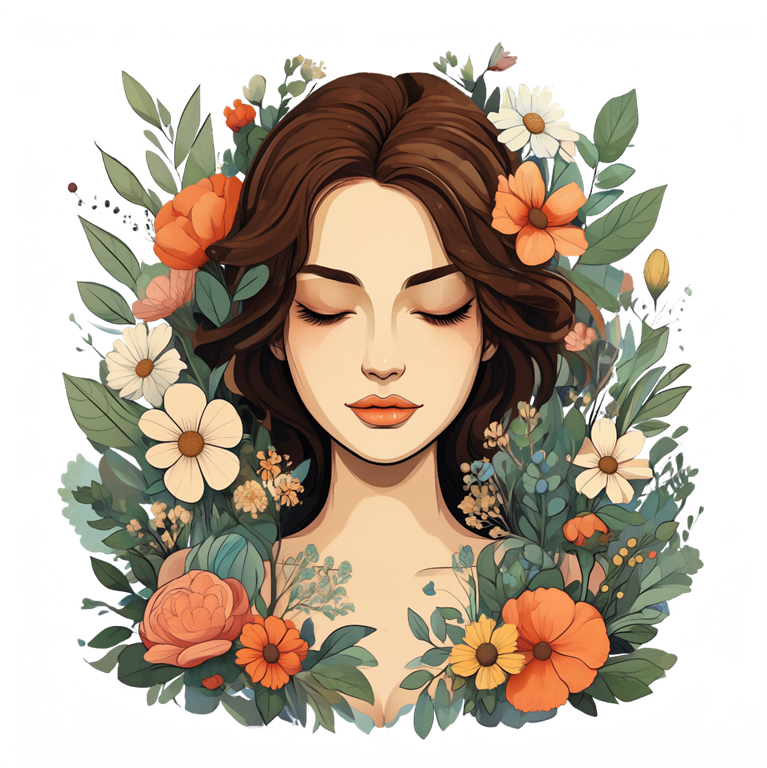
Exemplo 2: ilustração decorativa de uma mulher cercada por flores. Inclui limites complexos entre cabelo, pétalas e folhas.
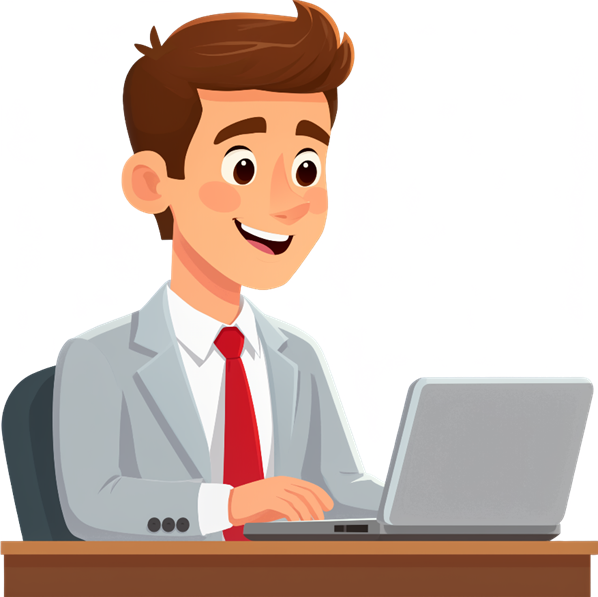
Exemplo 3: profissional usando notebook. Ilustração recortada para materiais de Web e apresentações.
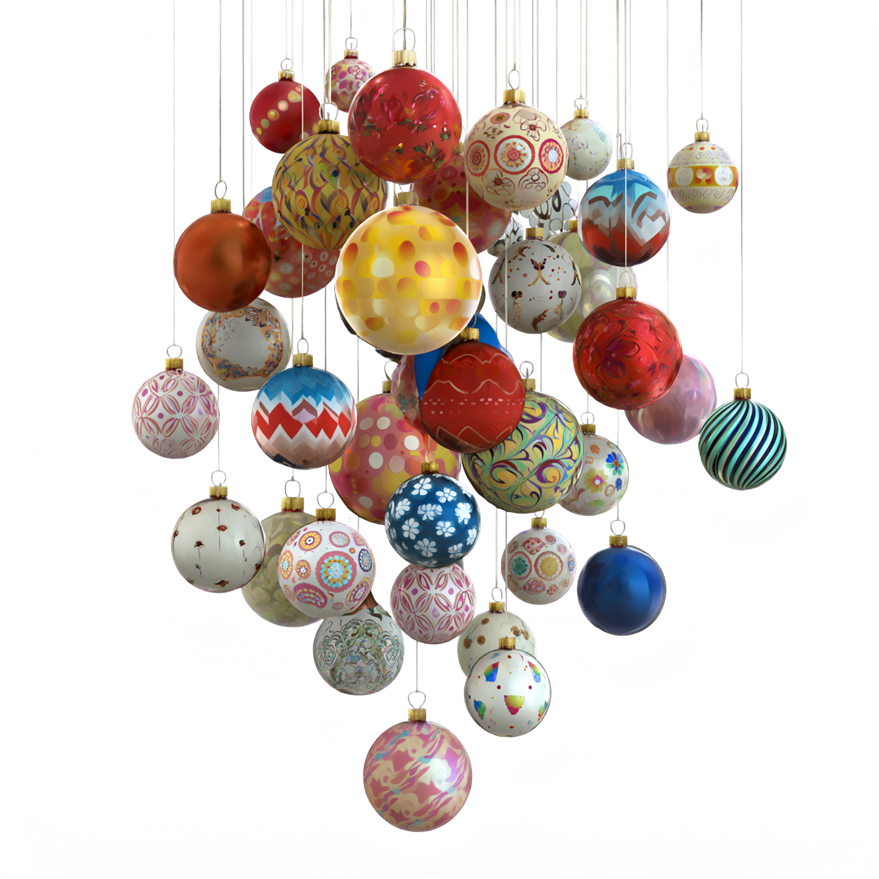
Exemplo 4: vários enfeites suspensos. Integra sensação de semitransparência, fios finos e materiais distintos em uma única imagem.
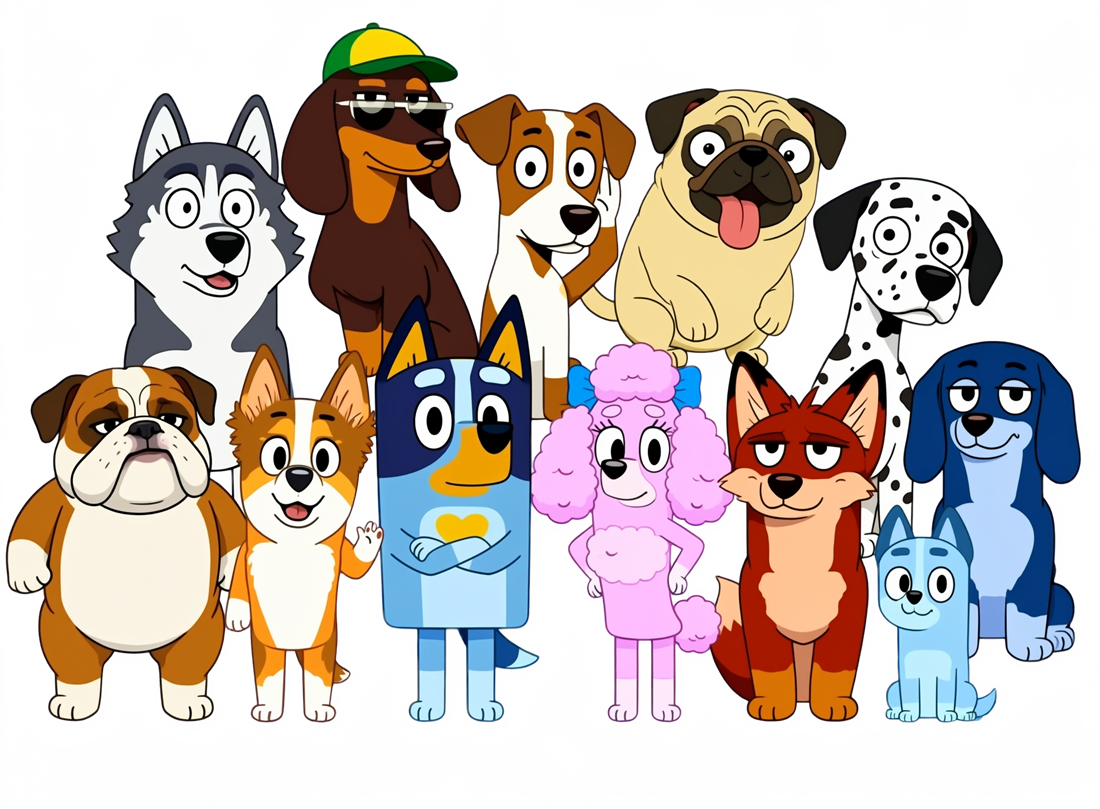
Exemplo 5: muitos personagens de cachorro. Exemplo de diferenciação de vários sujeitos e composição coletiva.
Edição de imagens e substituição de texto
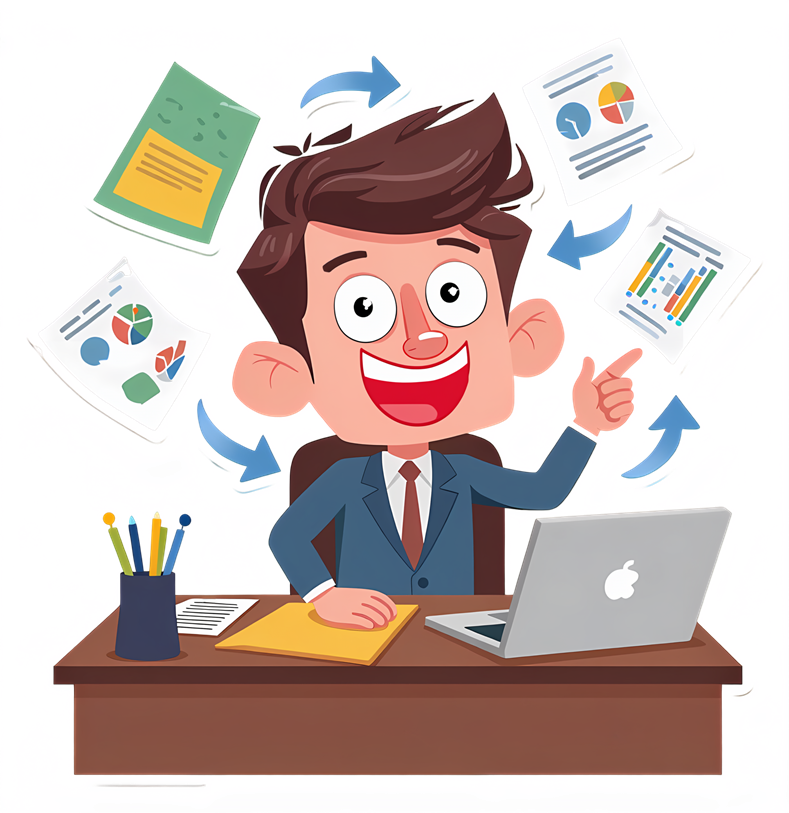
Exemplo 6: imagem original de um funcionário cansado. Imagem condicional para comparação com o resultado da edição seguinte.
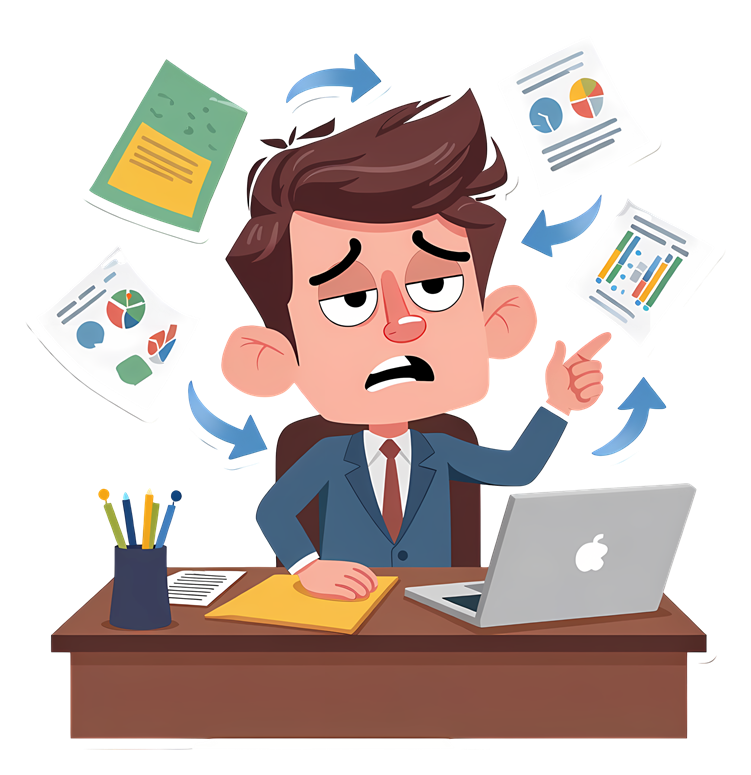
Exemplo 7: funcionário com expressão e clima modificados. Muda a emoção da pessoa preservando o layout.
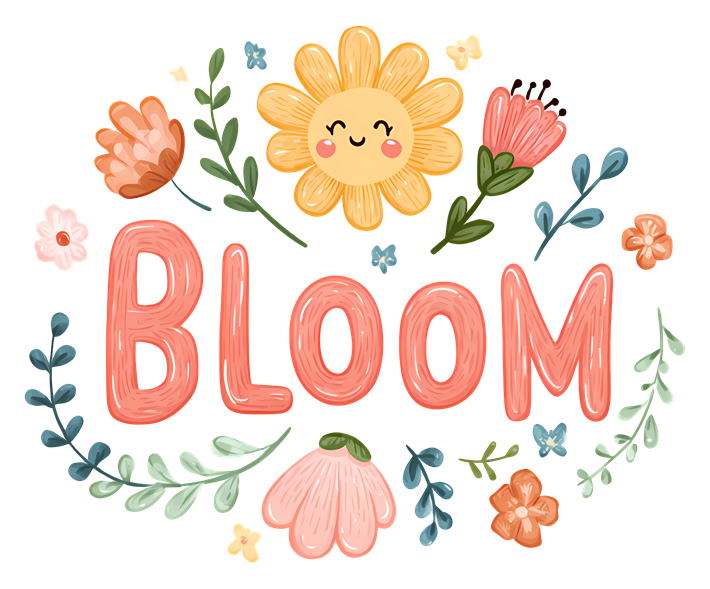
Exemplo 8: letras florais «BLOOM». Exemplo-base de texto, ornamento e posicionamento central.
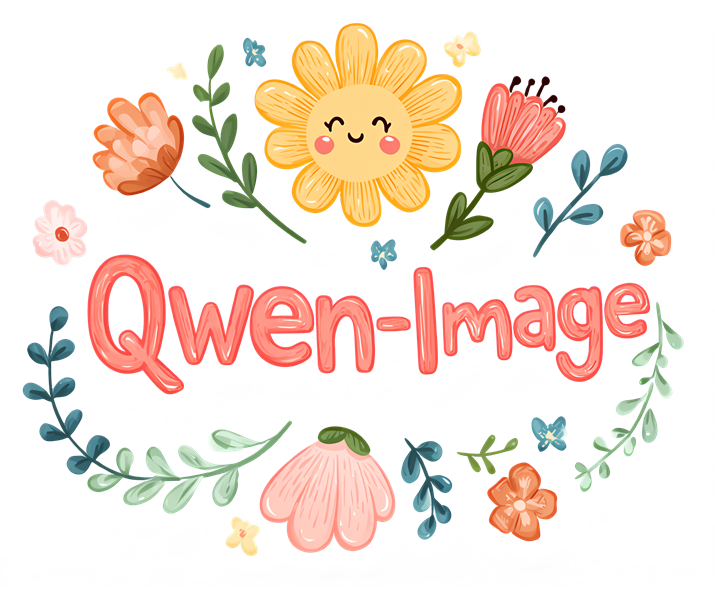
Exemplo 9: substituição do texto por «Qwen-Image». Edição tipográfica que preserva o estilo floral.
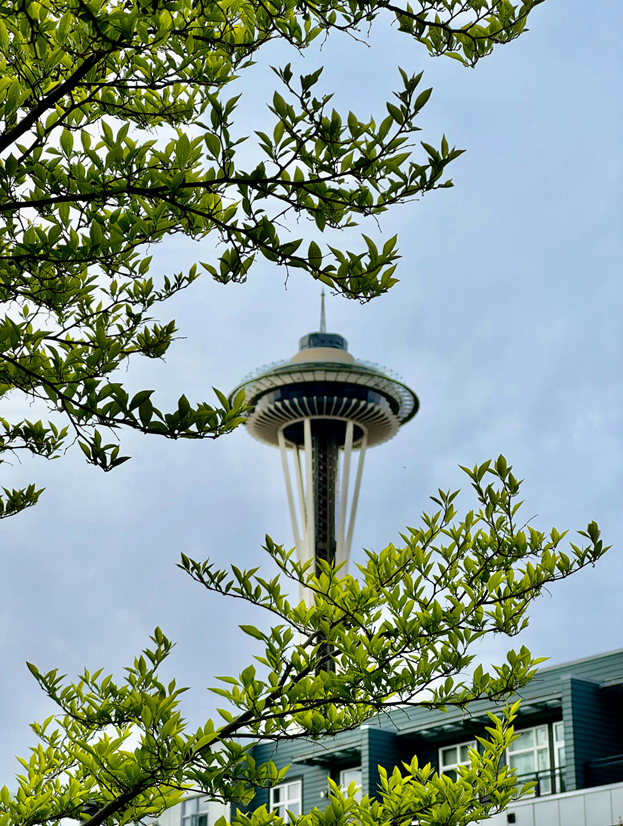
Exemplo 10: foto de uma torre durante o dia. Entrada para edição de horário e fundo.
Fundo, horário e múltiplas pessoas
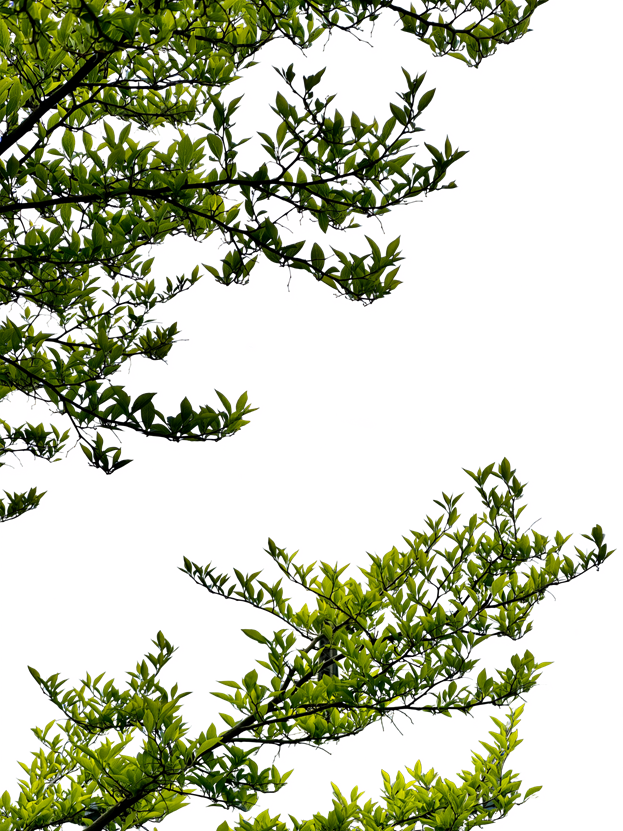
Exemplo 11: árvore florida à noite. Mostra a capacidade de transformar uma foto diurna em cena noturna ou mudar sua atmosfera.
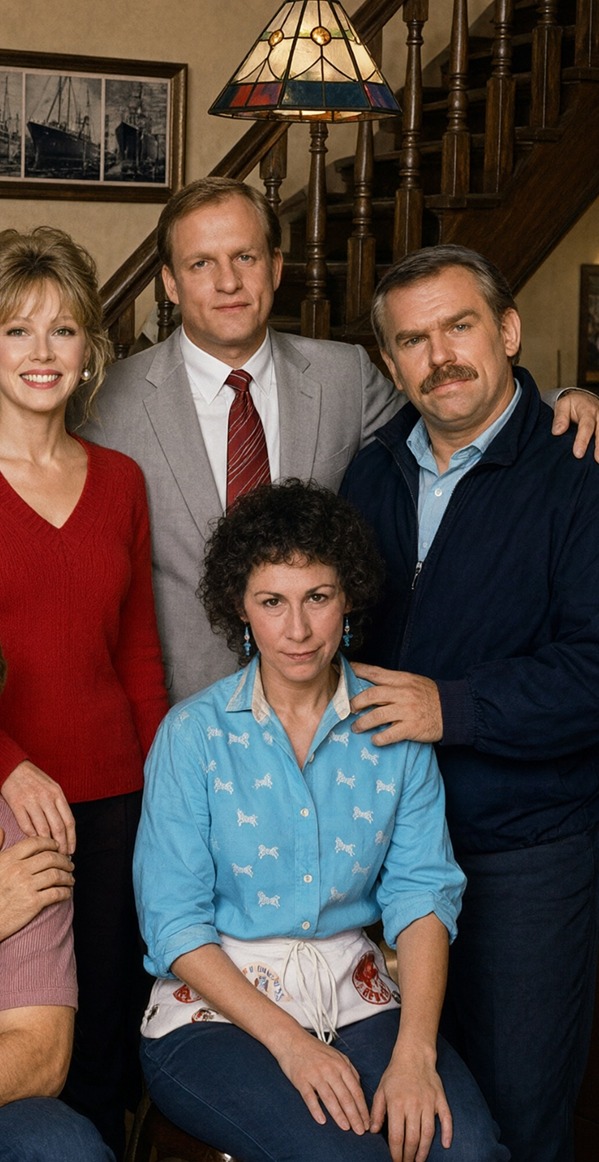
Exemplo 12: geração de foto de grupo a partir de várias referências de pessoas. Mostra o núcleo do recurso de até 10 referências.
Exemplo 13: combinação de várias referências de pessoa e roupas. Próximo à ideia de prova virtual.
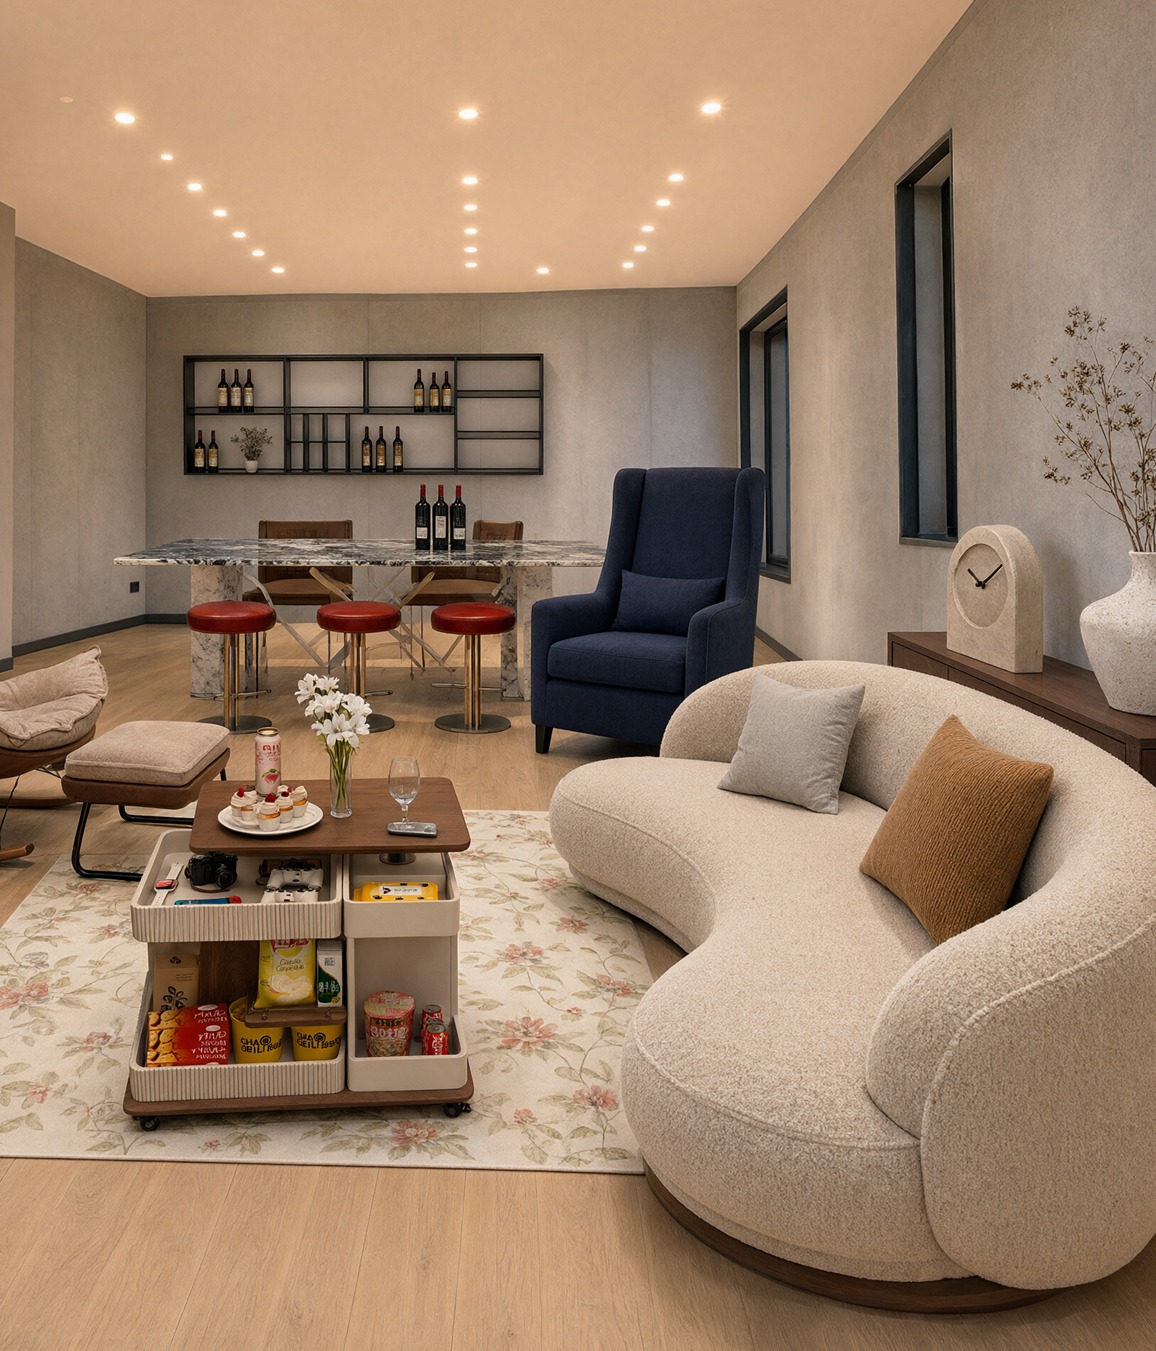
Exemplo 14: ambiente criado a partir de muitas imagens de móveis. Uso para posicionar catálogos de produtos em um cômodo.
Exemplo 15: instruções desenhadas em cores ao redor de um gato. Entrada de especificação local por anotações desenhadas.
Edição local, máscaras e composição
Exemplo 16: alteração apenas do gato indicado. Substitui o sujeito preservando cama e pessoa.
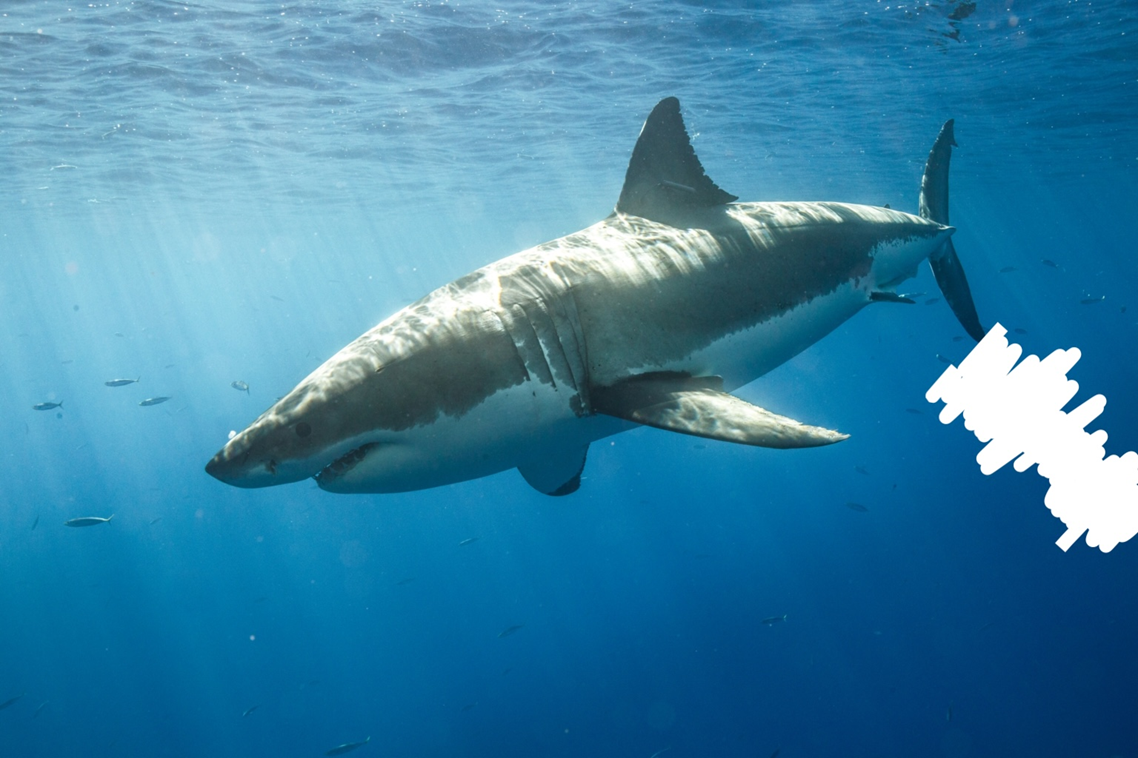
Exemplo 17: tubarão submerso com instrução local. Entrada de edição desenhada diretamente sobre o objeto.
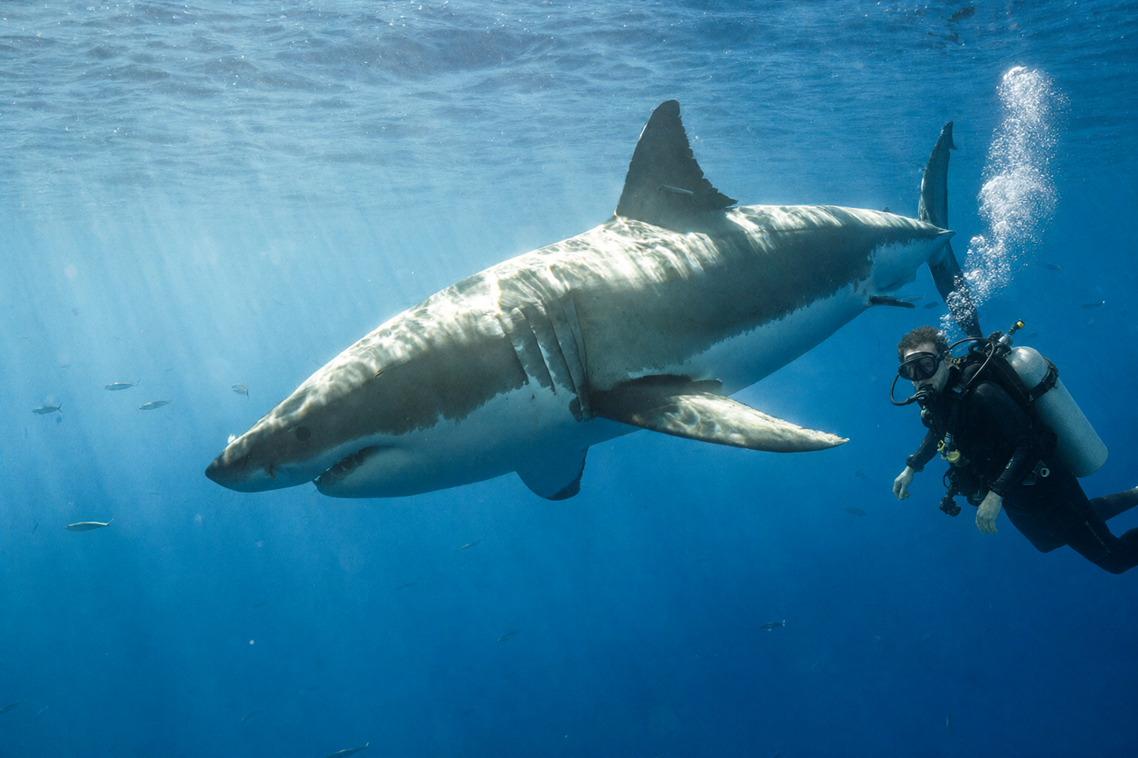
Exemplo 18: cena submarina com mergulhador adicionado. Composição que harmoniza luz submarina e escala.
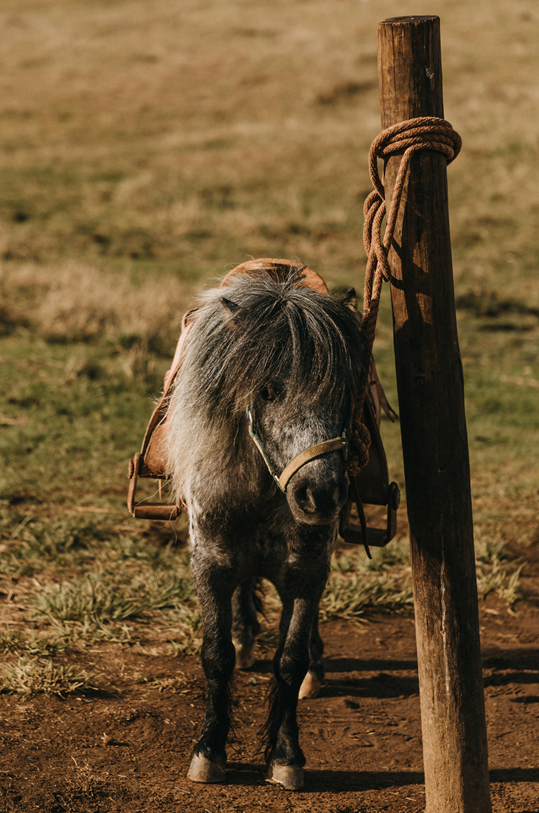
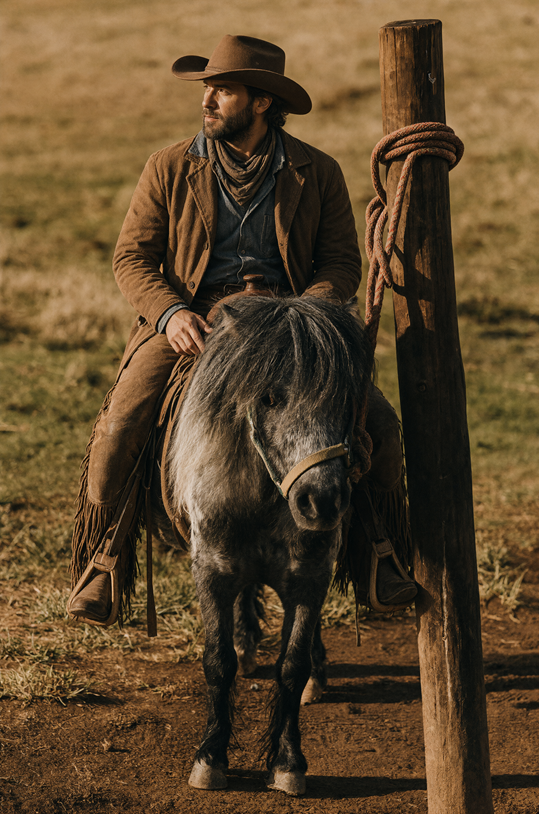
Exemplo 19: imagem original de uma pessoa montando um burro. Foto-base para edição por máscara.
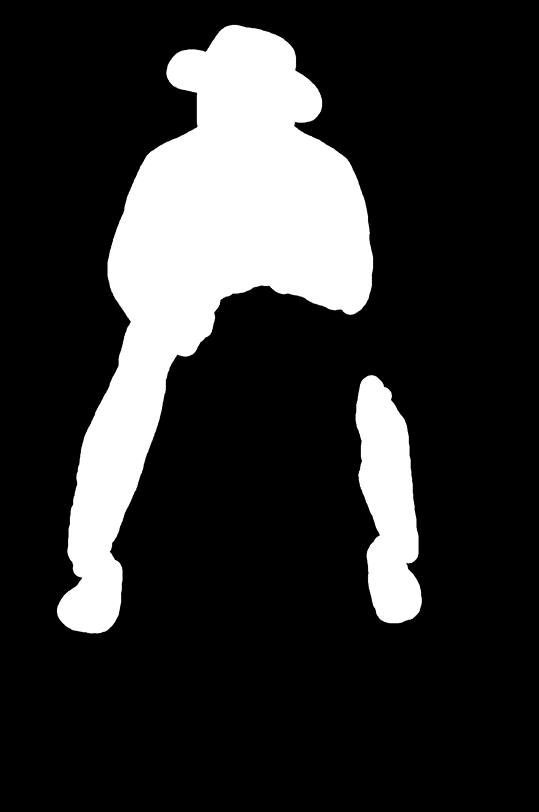
Exemplo 20: máscara que mostra a pessoa e o burro. Outro método que indica áreas a alterar em preto e branco.
Reposicionamento de pessoas e preservação do rosto
Exemplo 21: resultado de edição da pessoa com máscara. Também permite comparar a coerência com o campo ao fundo.
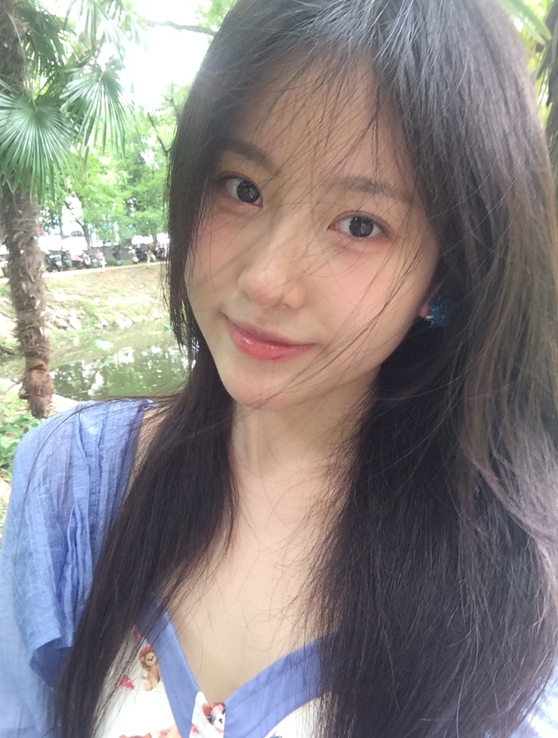
Exemplo 22: retrato para referência facial. Imagem-base usada na geração seguinte de corpo inteiro e novo ambiente.
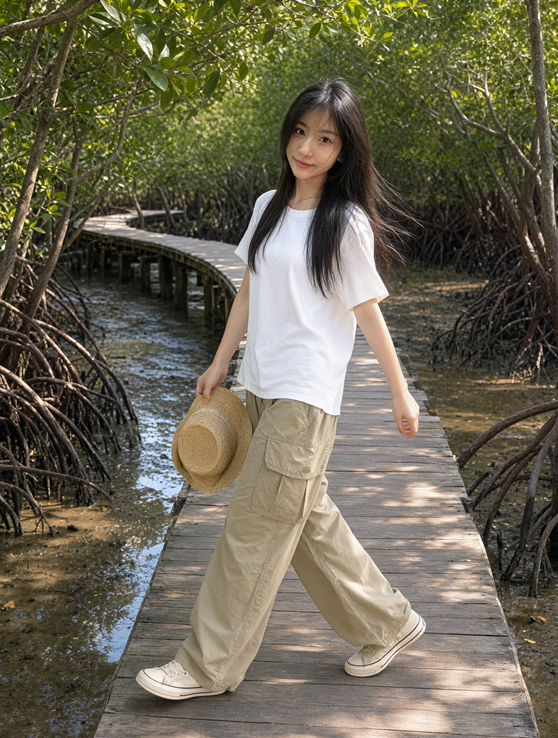
Exemplo 23: referência transformada em foto externa de corpo inteiro. Leva rosto e roupas a uma nova composição.
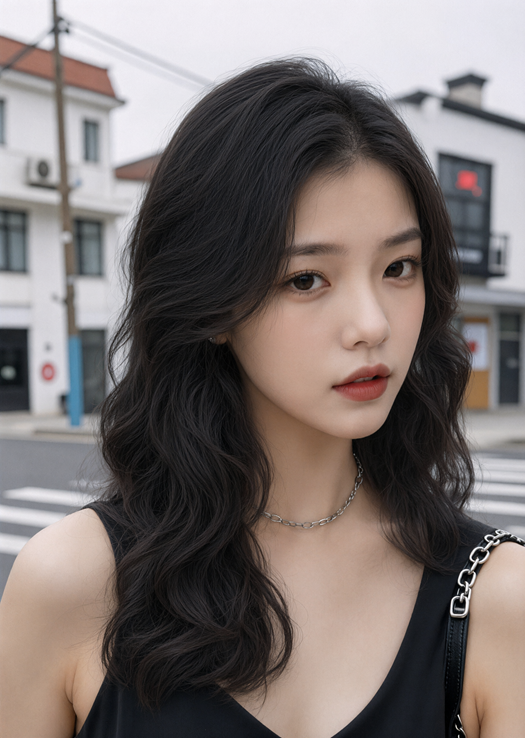
Exemplo 24: foto de rosto quase frontal. Condição de entrada para edição de penteado.
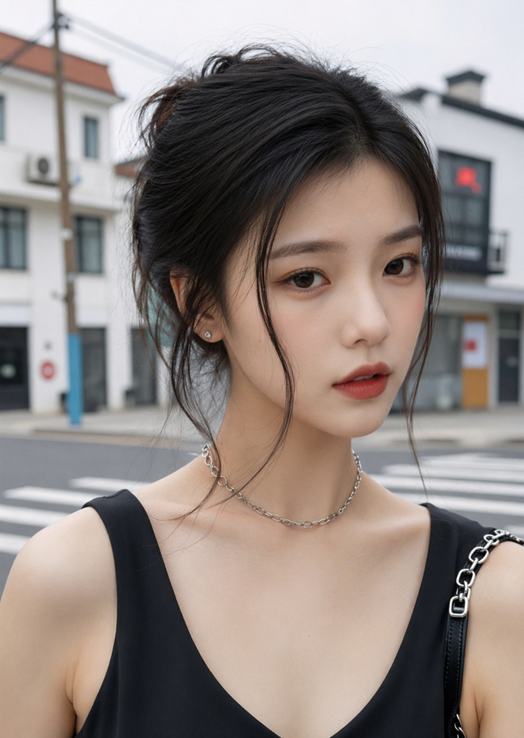
Exemplo 25: foto de rosto com penteado alterado. Preserva traços faciais e fundo e alonga apenas o cabelo.
Poses, cenas e fotos de produto
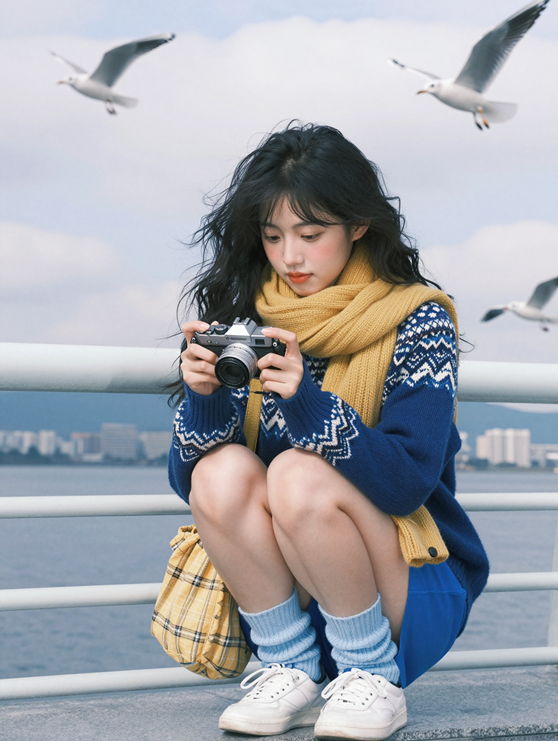
Exemplo 26: pessoa agachada no porto. Exemplo com pose complexa, acessórios e paisagem distante.
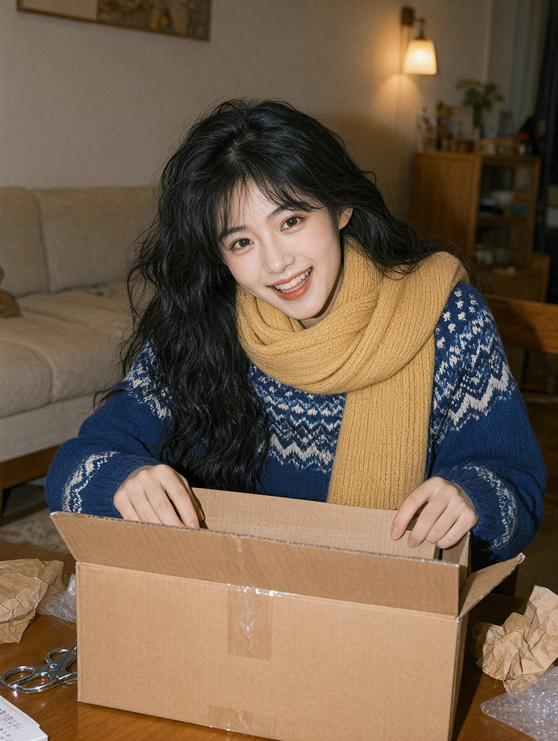
Exemplo 27: pessoa abrindo uma caixa em ambiente interno. Composição para observar dedos, caixa e sobreposição do corpo.
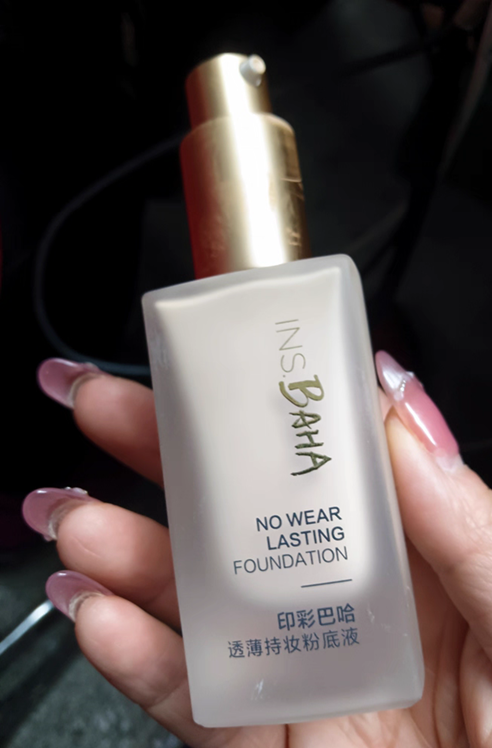
Exemplo 28: cosmético na mão. Foto de produto que inclui texto no rótulo e contato com os dedos.
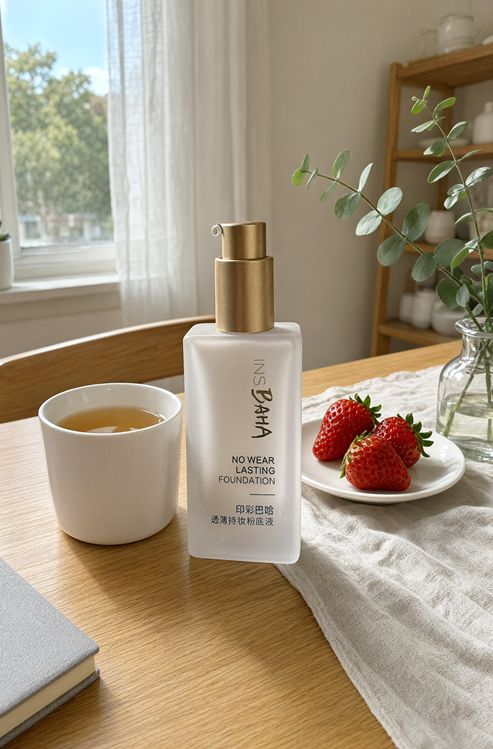
Exemplo 29: cosmético convertido em foto de produto interna. Adiciona luz natural, mesa e pequenos itens de comida.
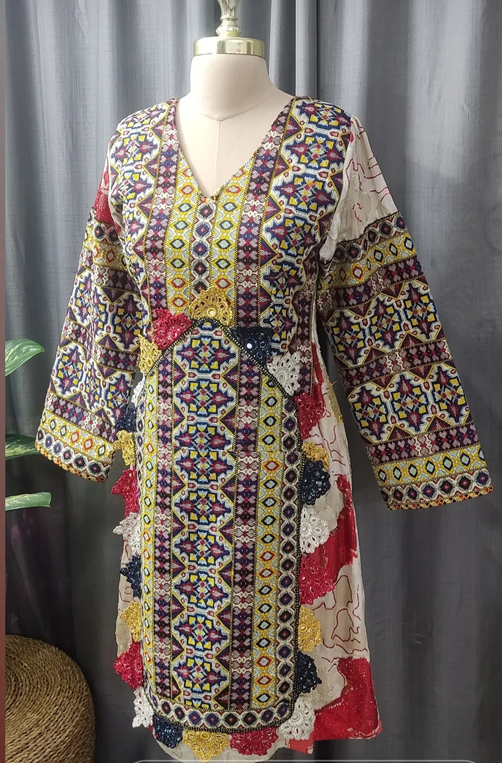
Exemplo 30: roupa em manequim. Referência de produto para a geração de prova virtual seguinte.
Prova virtual e composição de acessórios
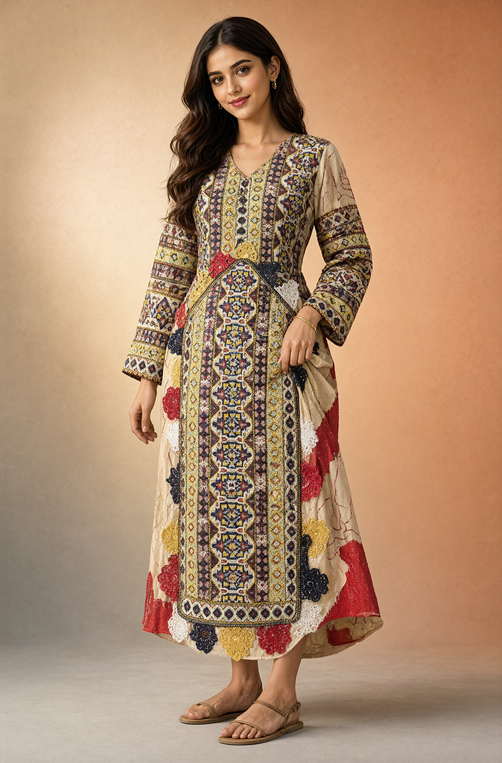
Exemplo 31: vestir uma pessoa com a roupa de referência. Ajusta estampa, comprimento e silhueta ao corpo.
Exemplo 32: foto de produto de uma pulseira isolada. Imagem condicional para composição de acessório.
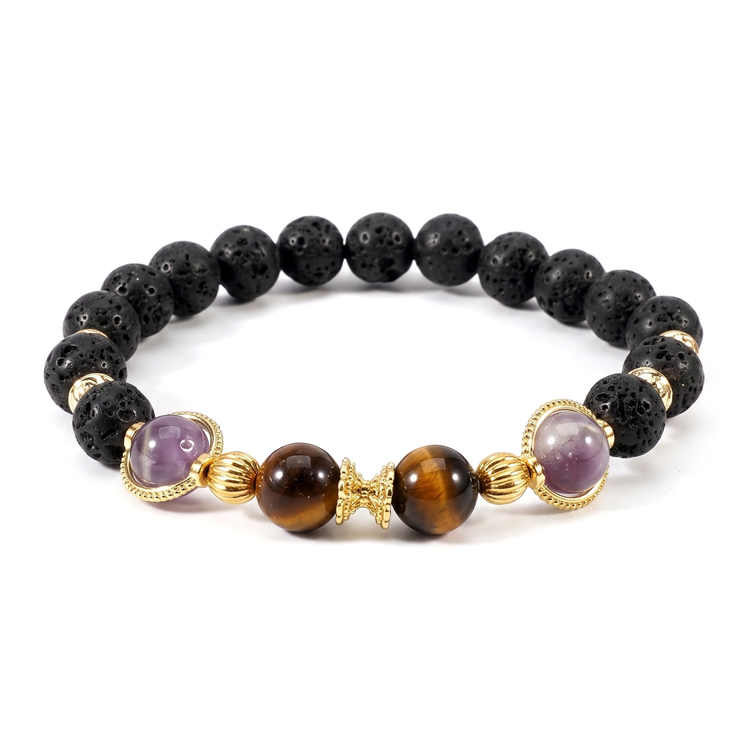
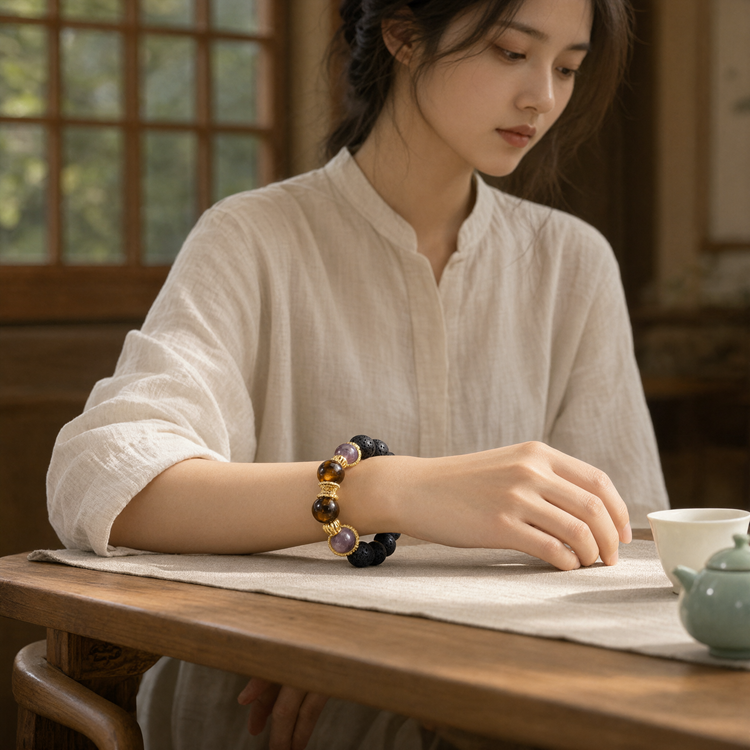
Exemplo 33: pulseira no pulso de uma pessoa. Ajusta naturalmente contato e sombra sobre a pele.
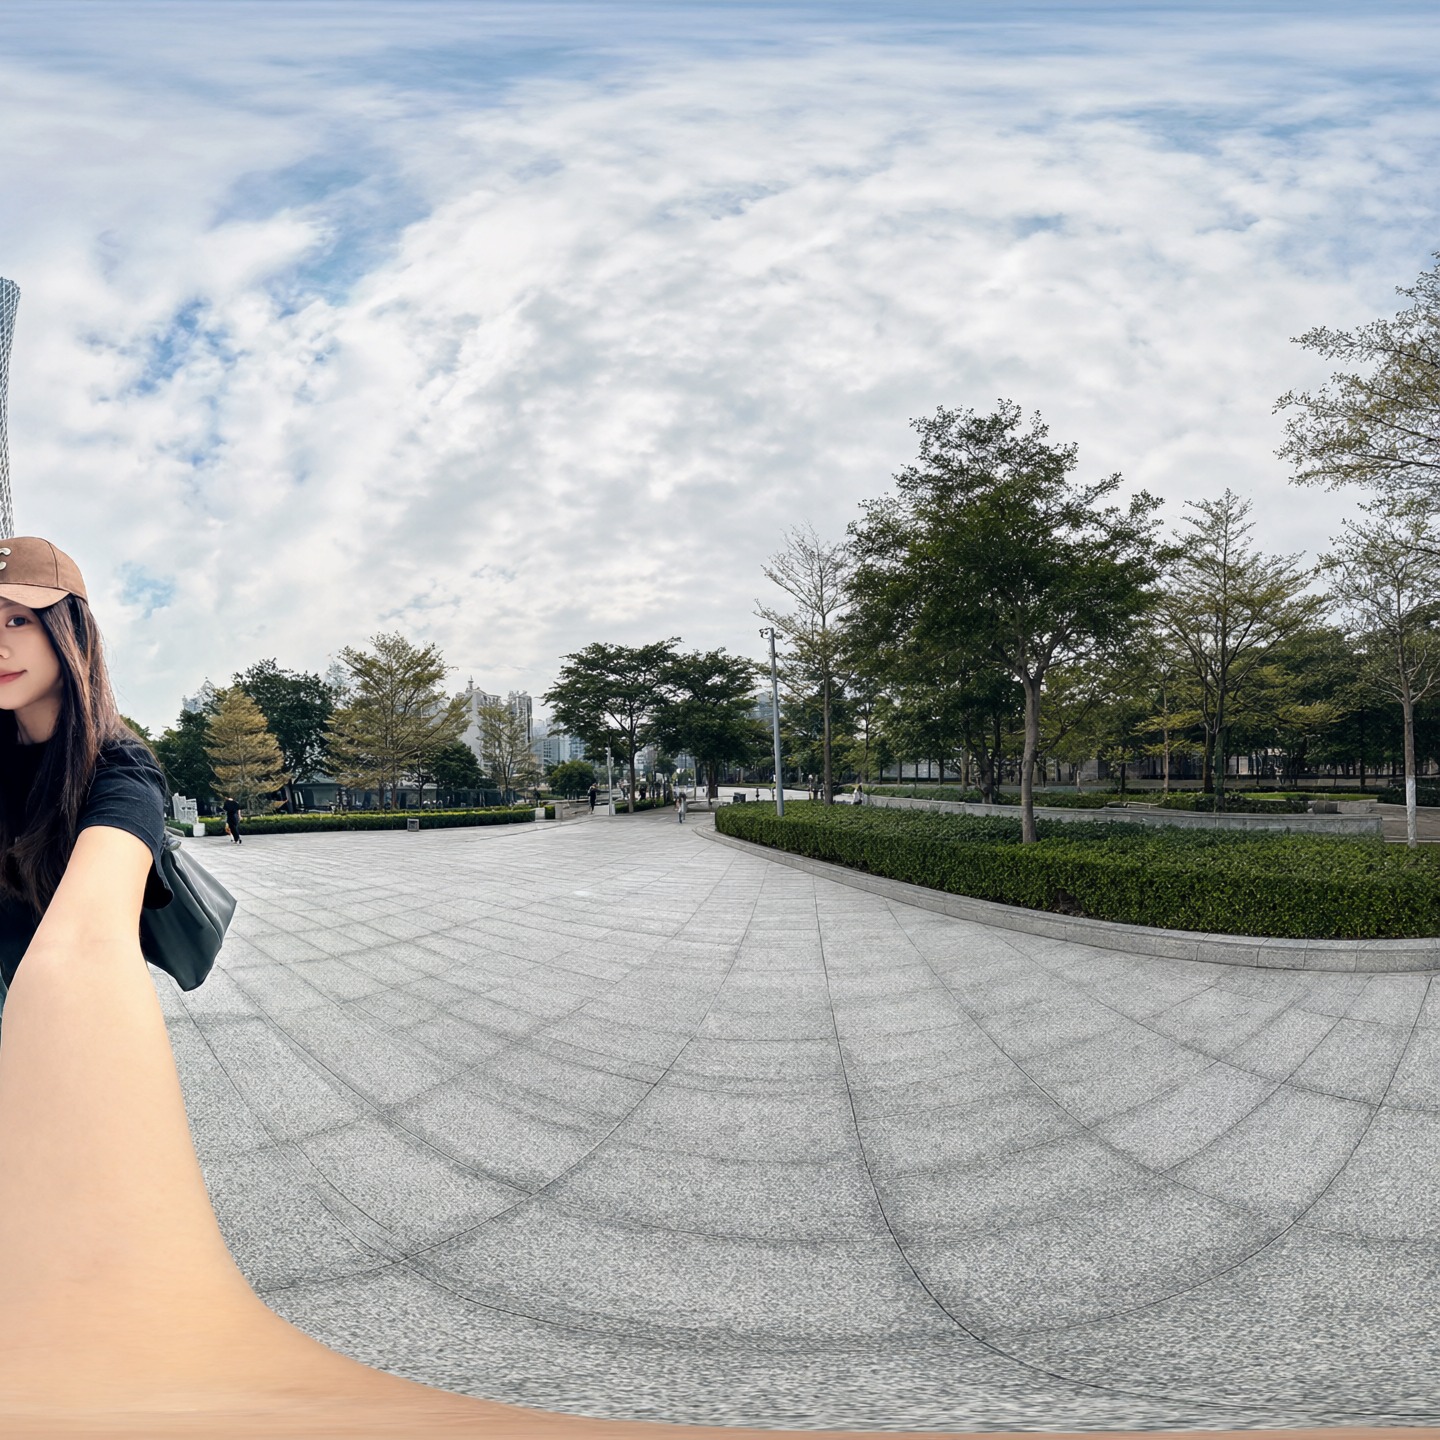
Exemplo 34: selfie em frente à torre. Foto de entrada para mudança de ponto de vista.
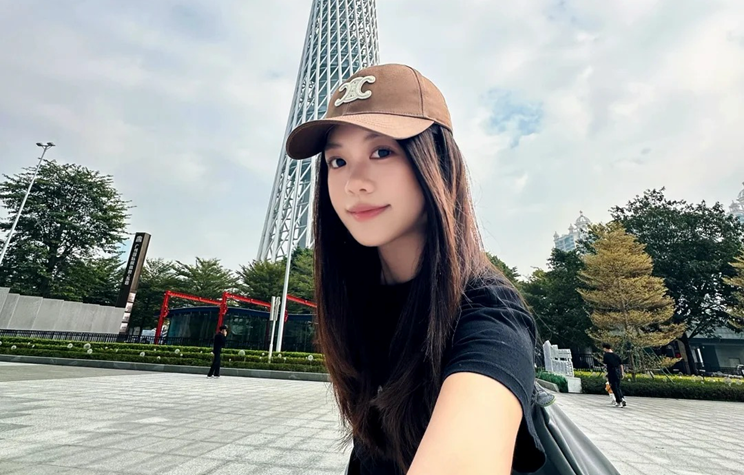
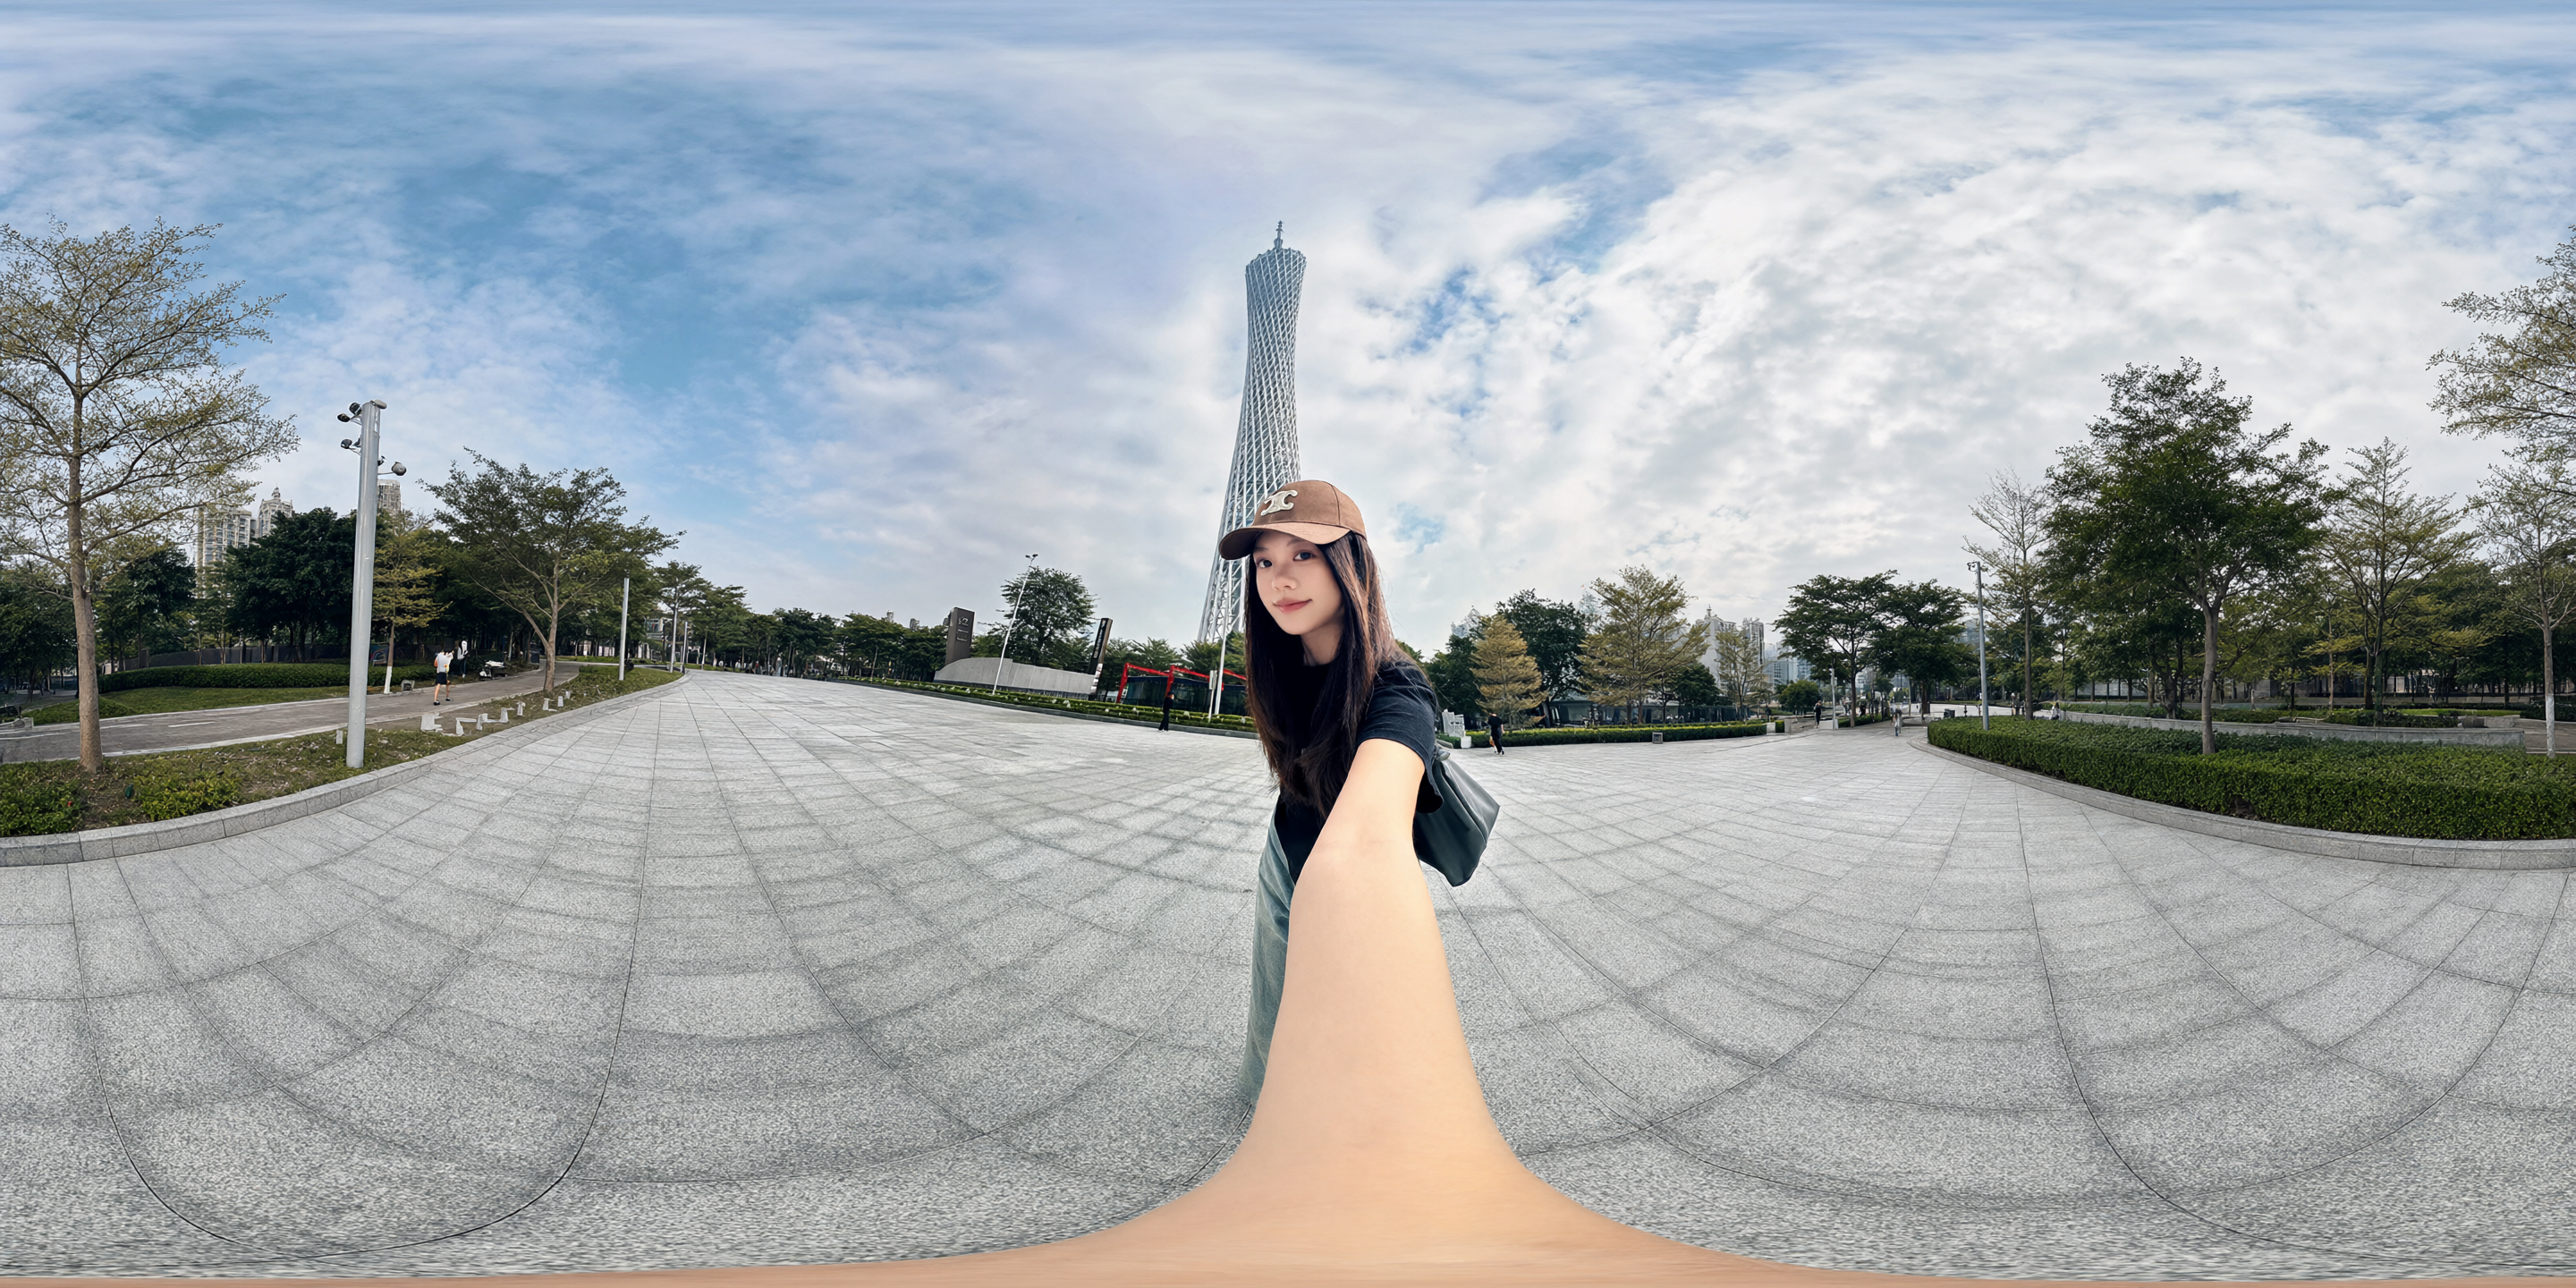
Exemplo 35: de selfie para visão de terceira pessoa. Reconstrói a mesma pessoa e local em um enquadramento amplo.
Fichas de personagem e continuidade
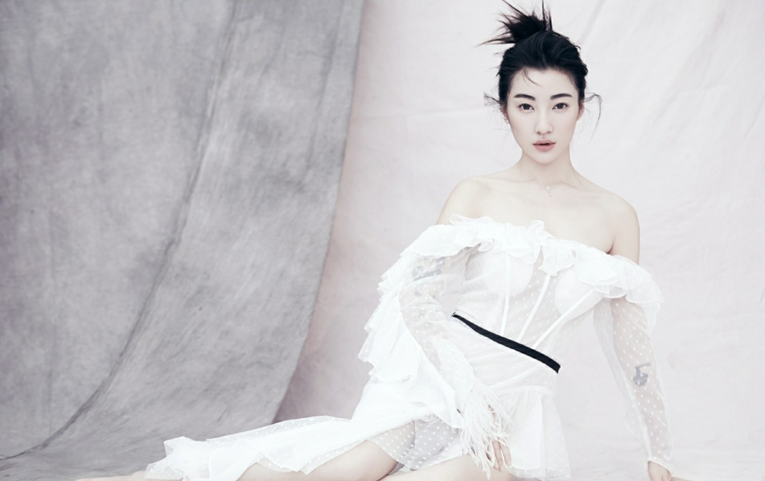
Exemplo 36: retrato de pessoa com roupa branca. Entrada para material de definição de personagem.
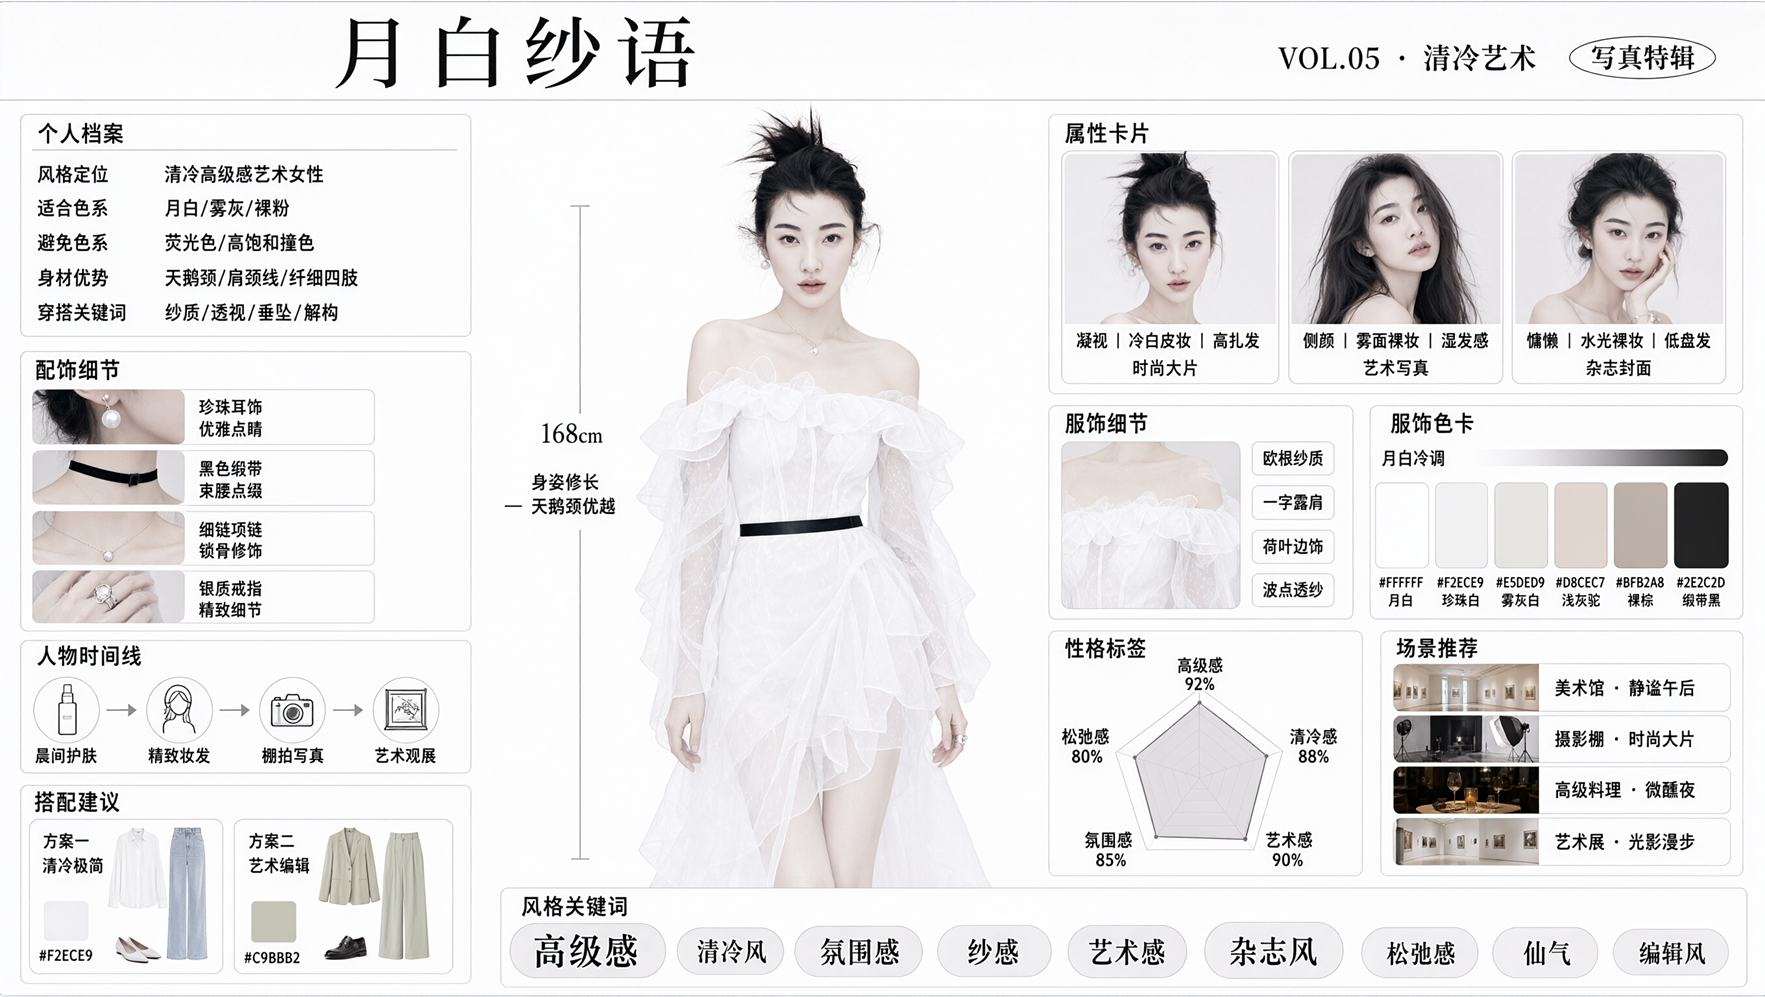
Exemplo 37: ficha de design que reúne a definição de uma pessoa. Integra rosto, roupa, acessórios e informações textuais.
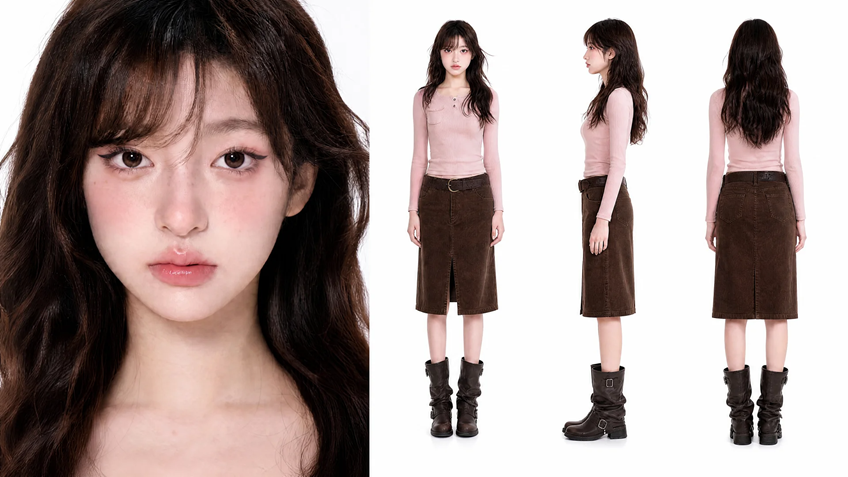
Exemplo 38: ficha de personagem com frente, lateral e costas. Para materiais de referência de vídeo ou quadrinhos.
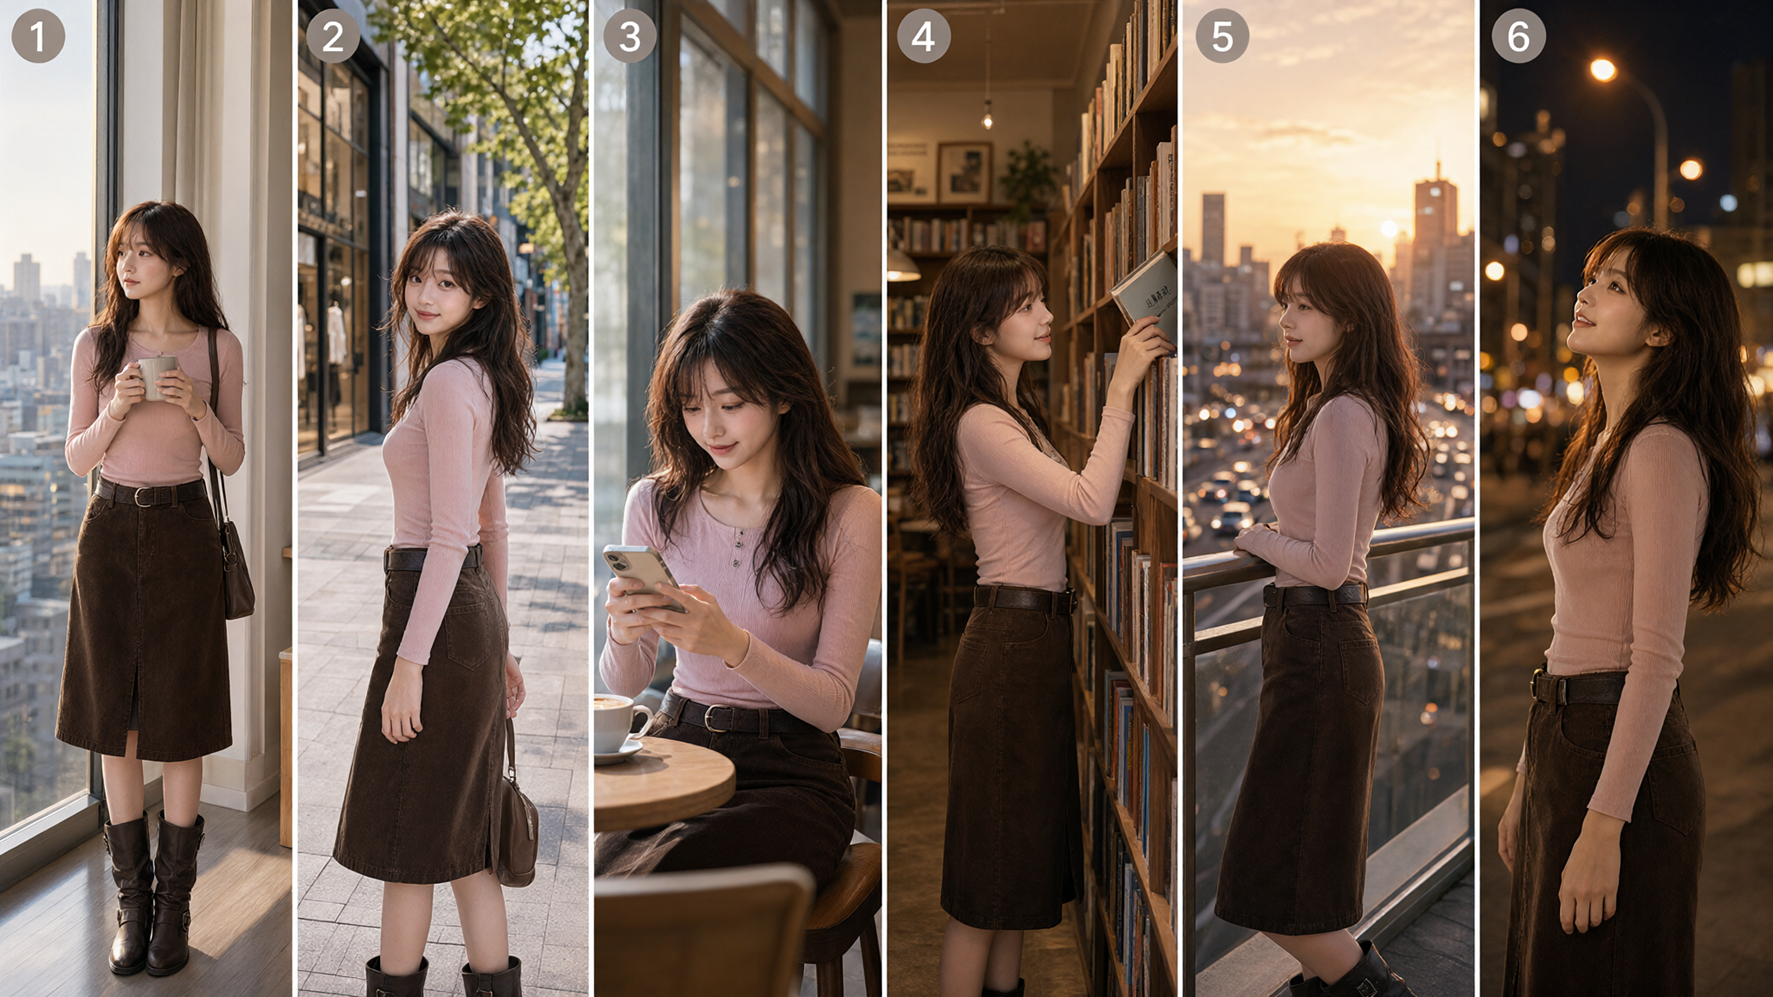
Exemplo 39: mesma pessoa em várias cenas. Observa a preservação de rosto e roupas quando pose e local mudam.
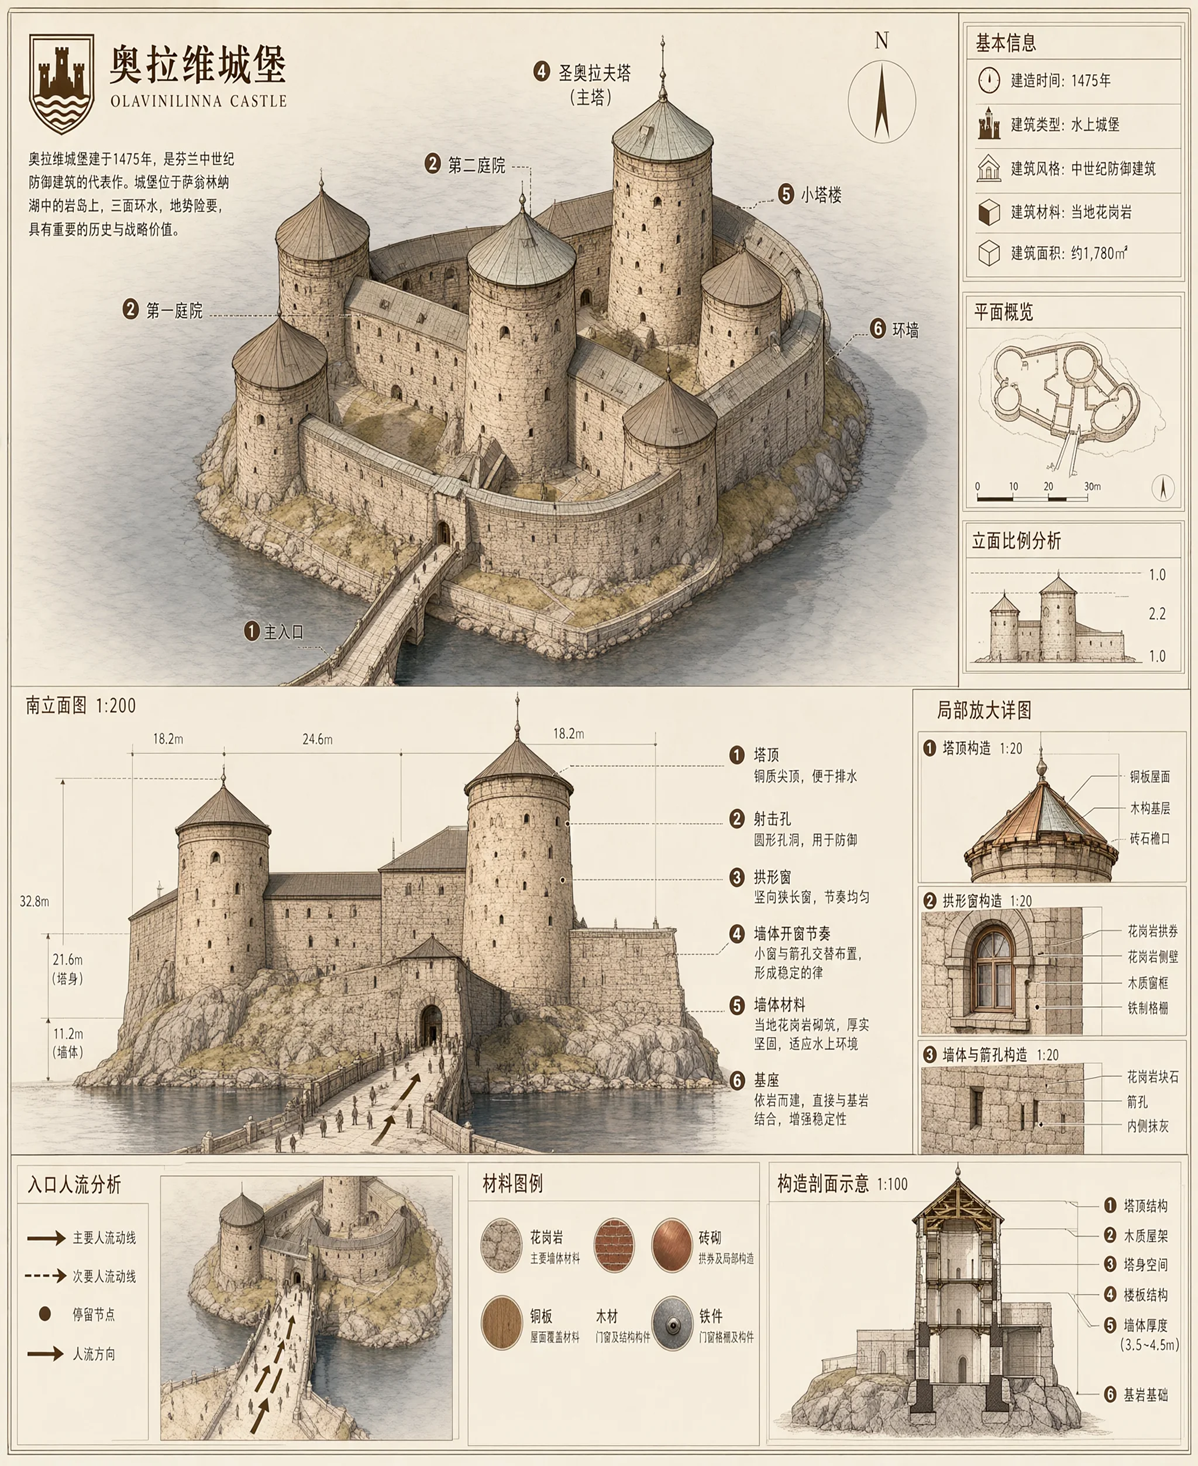
Exemplo 40: diagrama explicativo de um edifício. Geração de material que integra texto, planta, amostras de materiais e anotações em uma imagem.
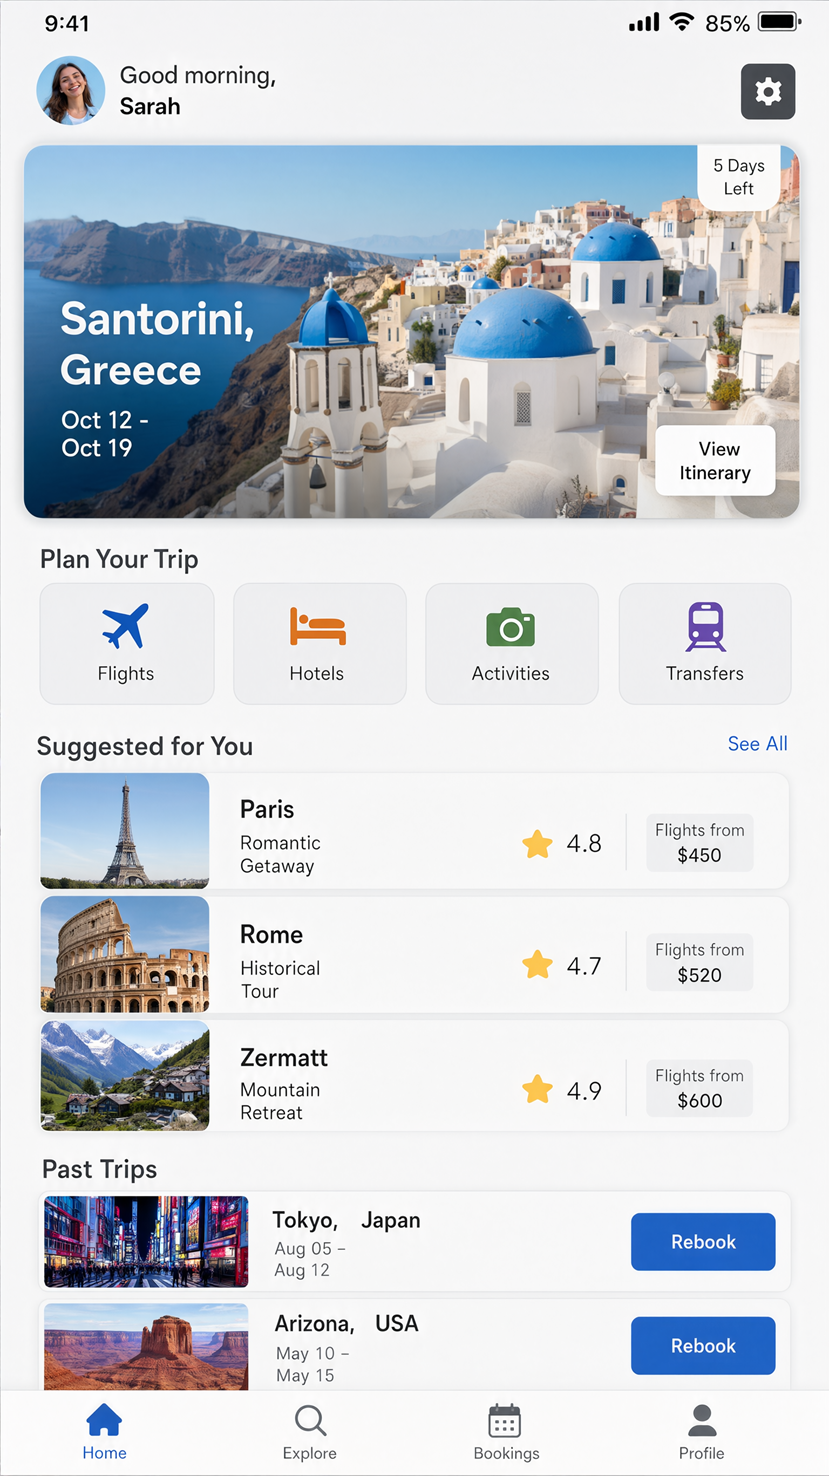
UI, documentos e fotos naturais de pessoas
Exemplo 41: UI de aplicativo de reserva de viagens. Projeto de tela com letras pequenas, cartões, fotos e botões.
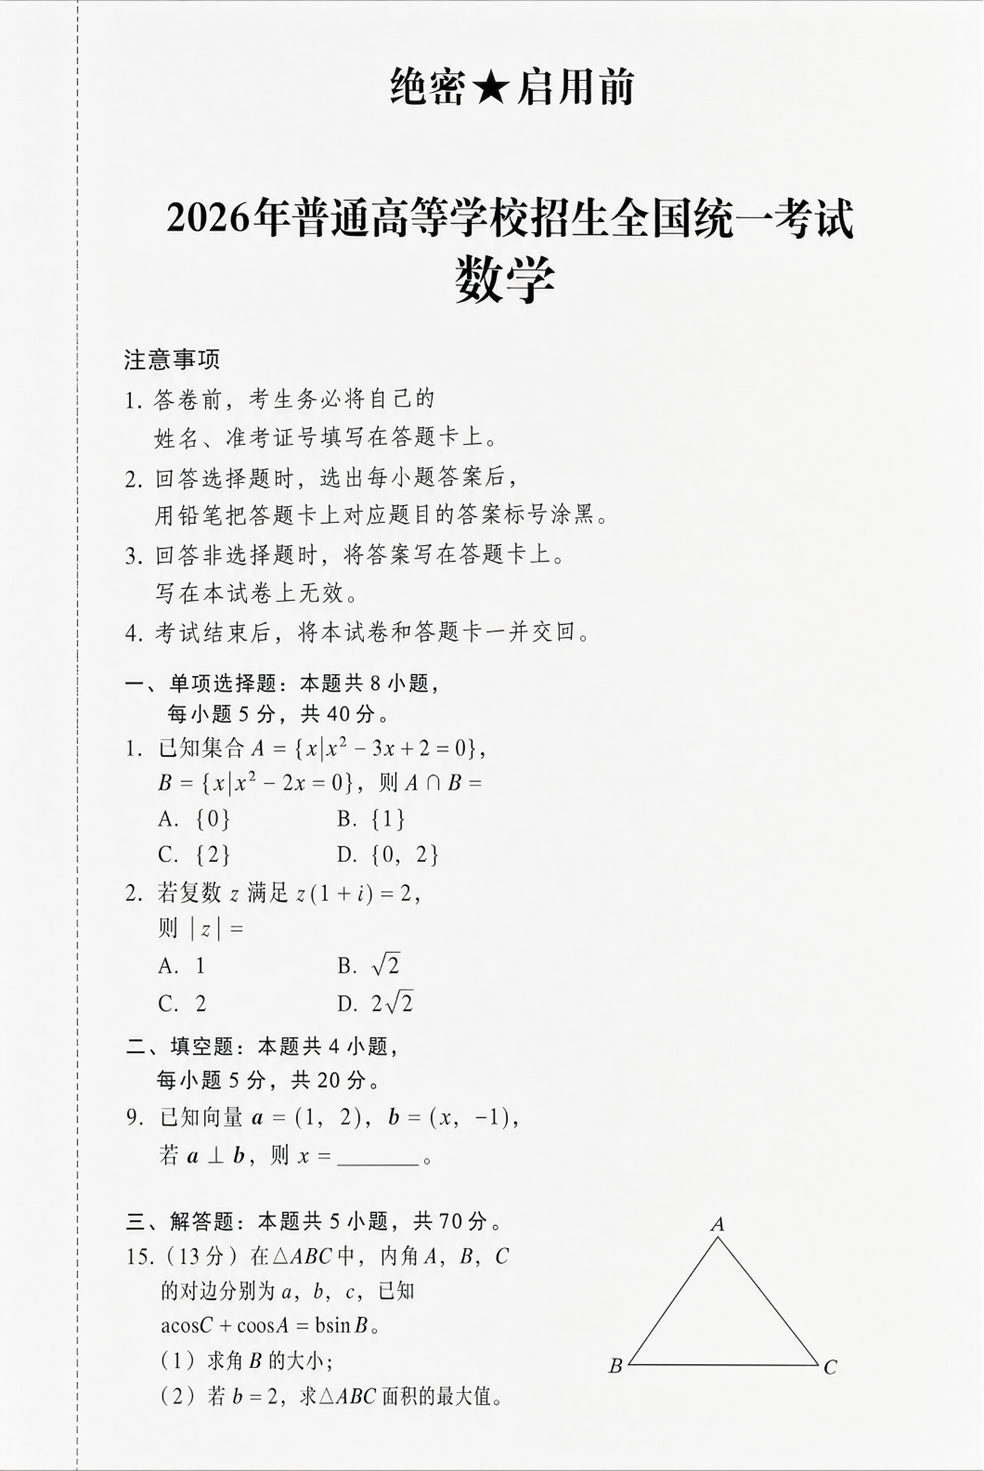
Exemplo 42: documento com problema de geometria. Mostra a dificuldade de gerar páginas com texto longo e figuras.
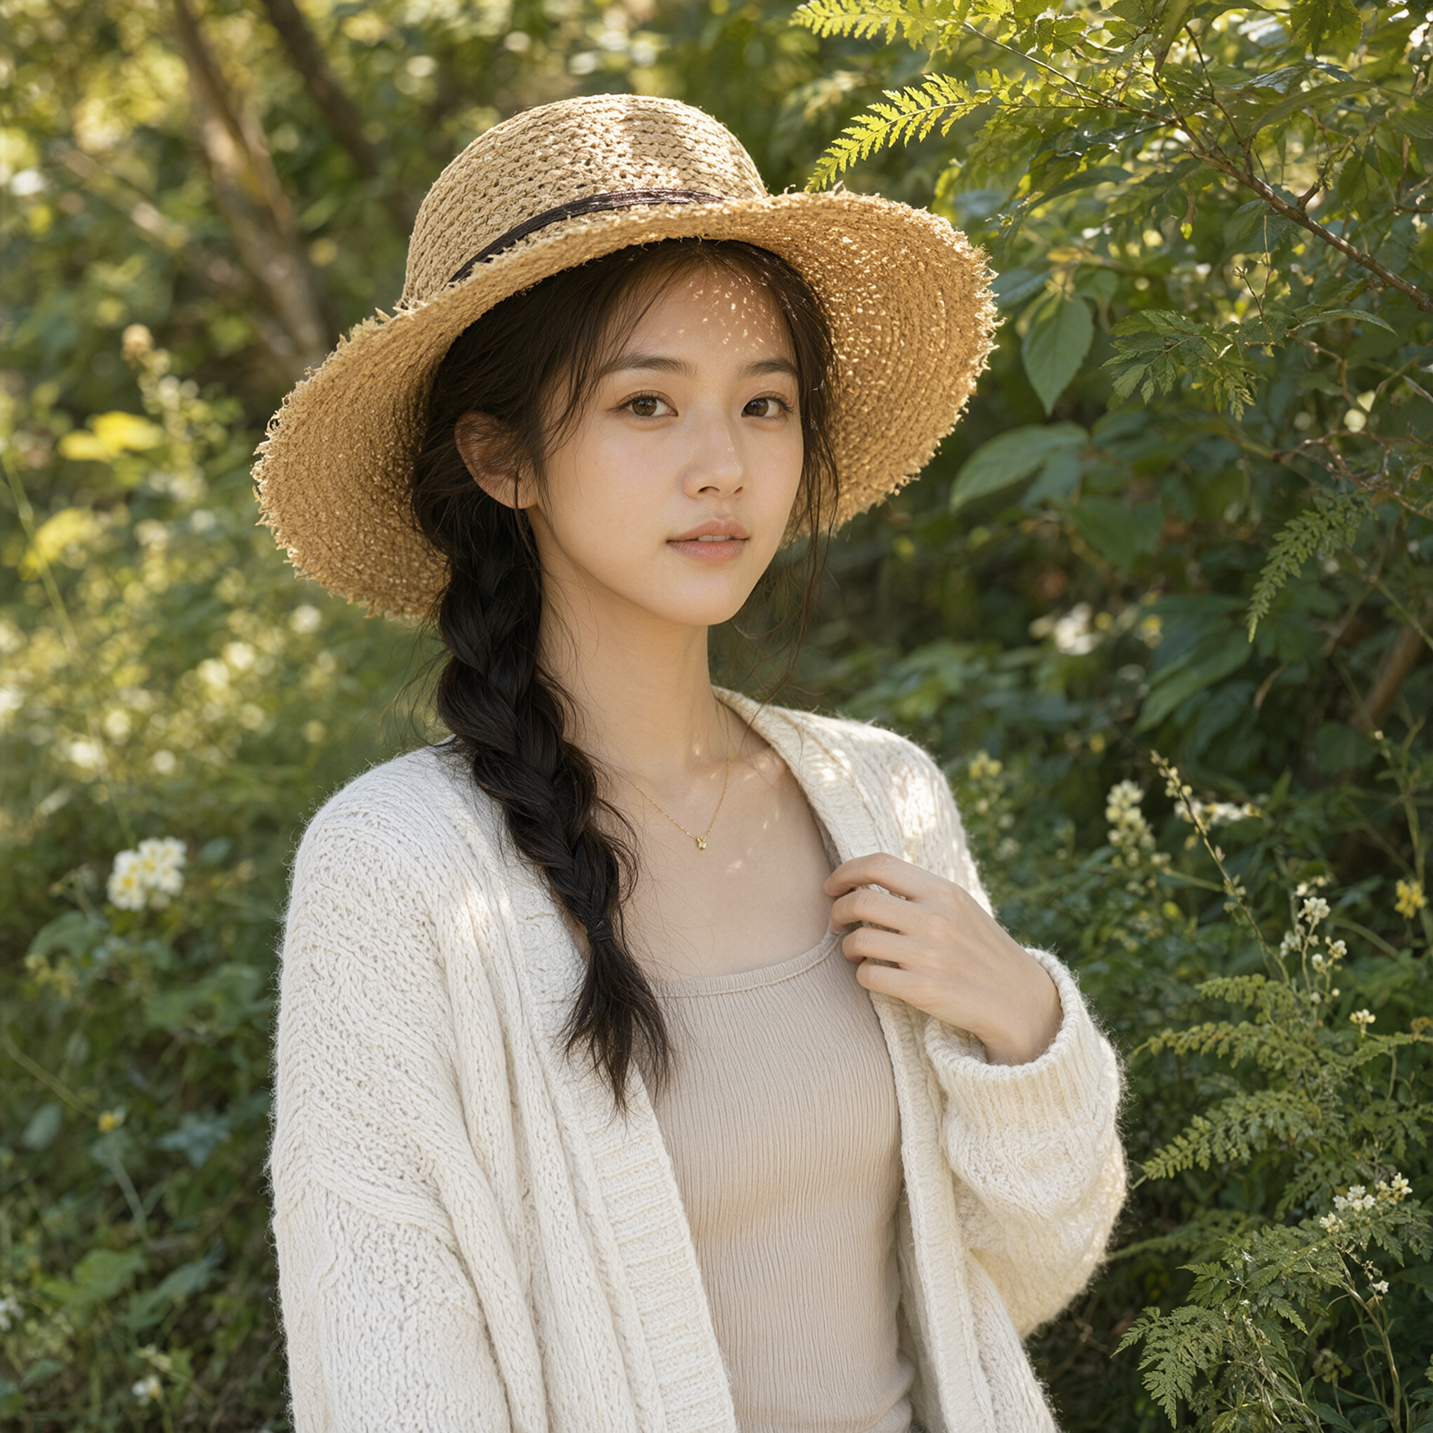
Exemplo 43: retrato externo com luz natural. Representação de chapéu, cabelo e luz filtrada pelas árvores.
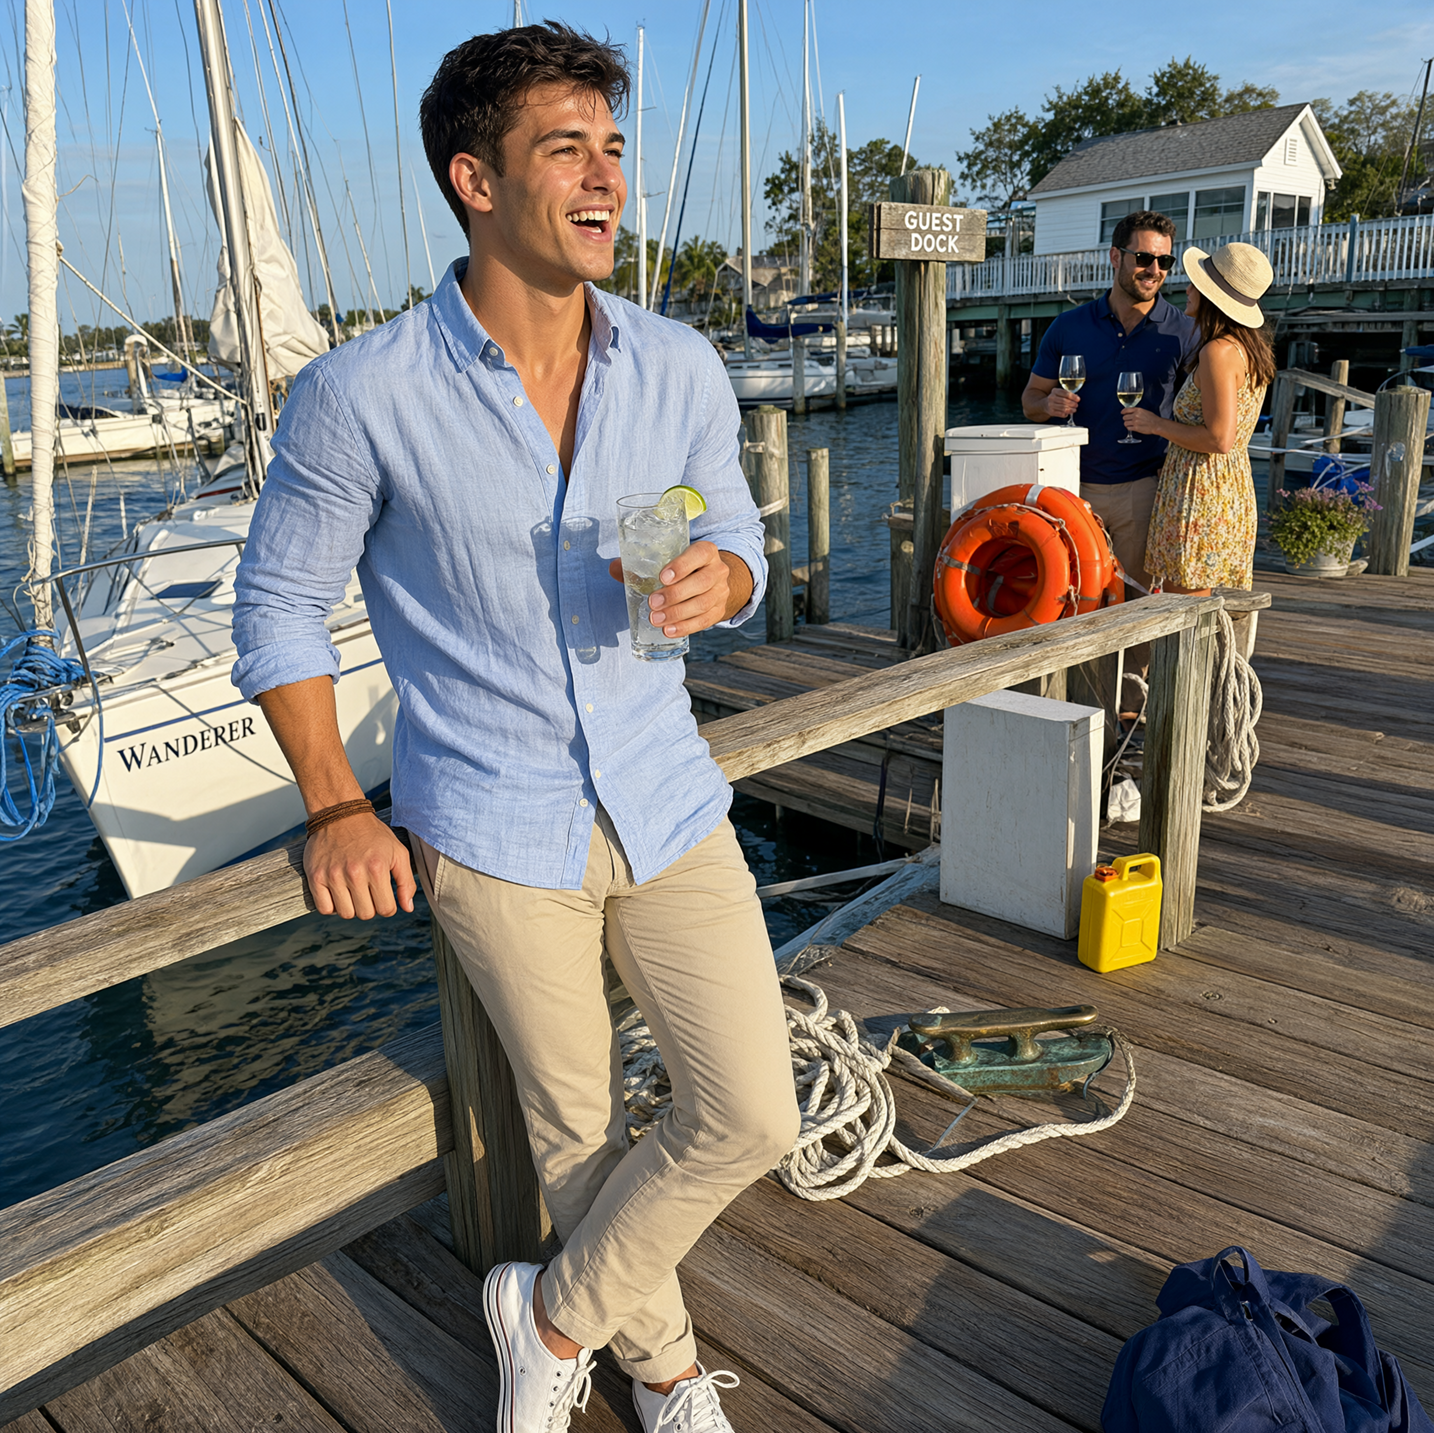
Exemplo 44: foto de pessoa na marina. Exemplo fotorrealista com fundo detalhado, incluindo cordas, barcos e ferramentas.
Ampliações e outros pontos de vista fáceis de comparar
Exemplo 45: ampliação de parte do resultado da foto de grupo. Permite verificar rostos, poses e iluminação ao reunir várias referências em um espaço.
Exemplo 46: ampliação do interior após integração dos móveis. Cria perspectiva e luz do cômodo inteiro a partir de referências de produtos individuais.
Exemplo 47: recorte quadrado após mudança de ponto de vista da câmera. Facilita observar a relação de escala entre a torre e a pessoa ao fundo.
Exemplo 48: ampliação da ficha de design de personagem. Permite conferir a qualidade local de variações faciais, texto e acessórios.
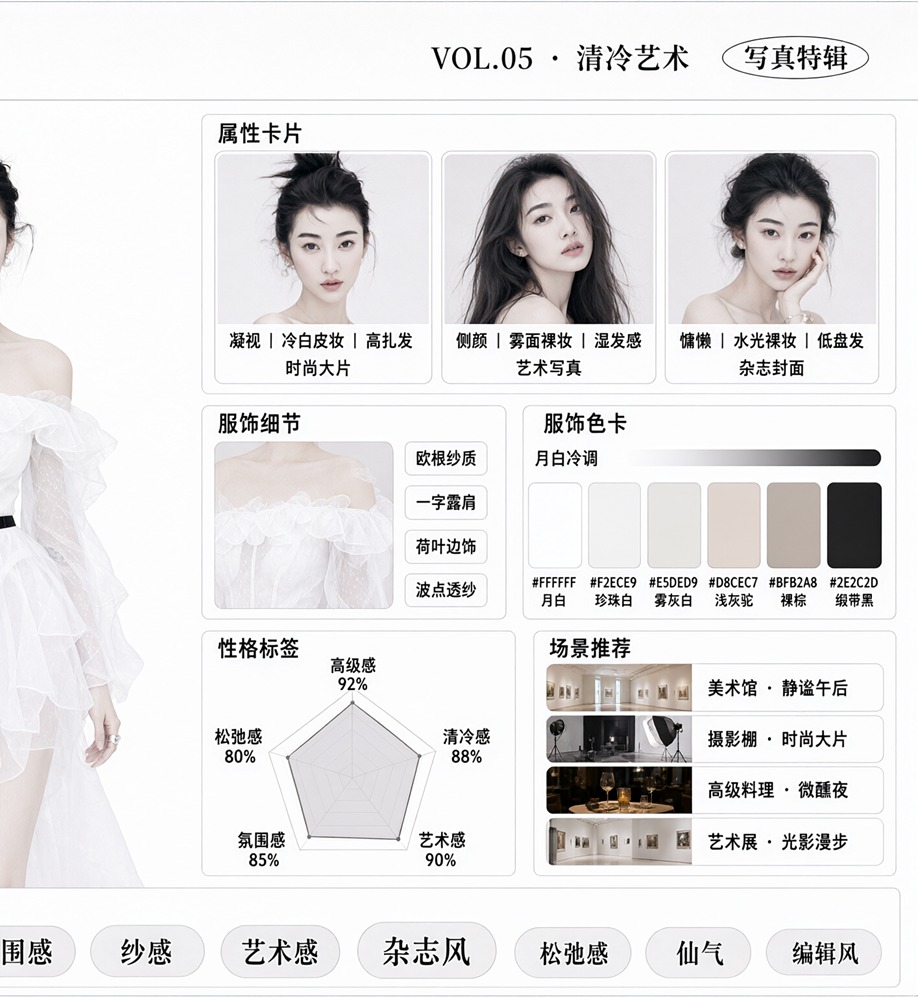
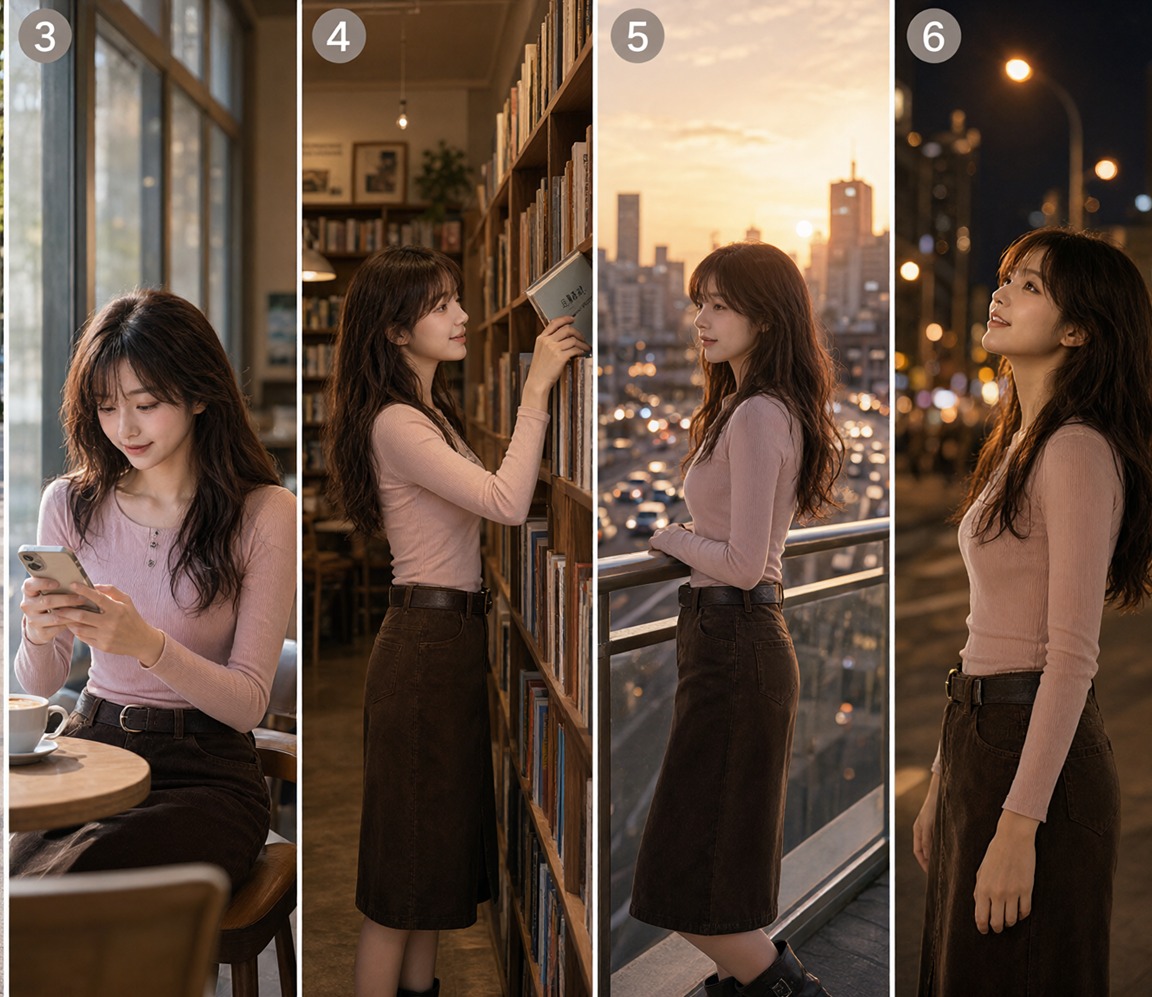
Exemplo 49: ampliação de parte da sequência com a mesma pessoa em várias cenas. Observa a consistência de roupa e rosto, importante em produções longas.
Exemplo 50: ampliação de infográfico arquitetônico. Mostra o desafio composto de desenho linear, materiais, anotações e planejamento de espaços em branco.
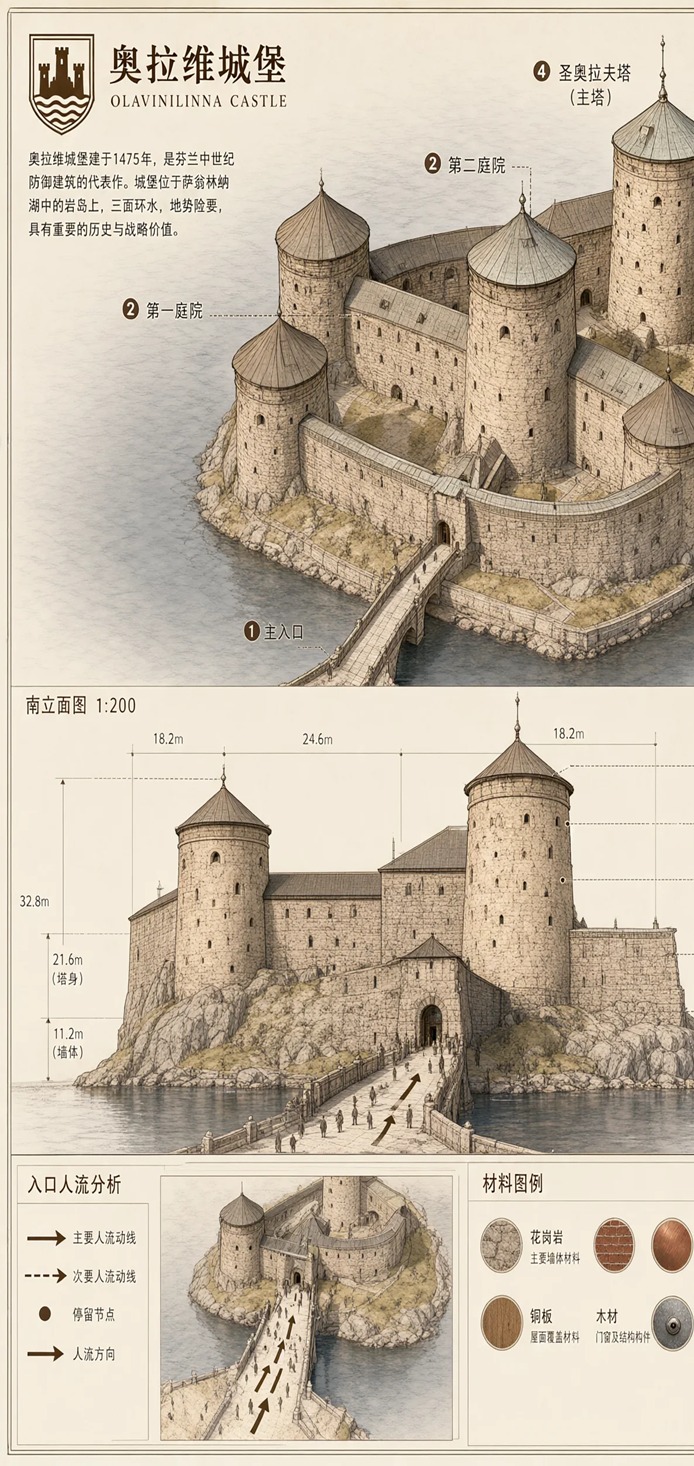
Fonte das imagens: amostras oficiais «Qwen-Image-2.1» da Qwen Team. As seis ampliações são recortes editados para explicação comparativa.
100 exemplos e testes que ganharam destaque no Reddit
A seguir, organizamos em 100 itens os tipos de criação e edição que de fato chamaram atenção nas principais publicações sobre Qwen-Image 2.1 no Reddit. Como incluem a subjetividade dos autores e diferenças de ambiente, não devem ser lidos como benchmark, mas como um catálogo prático do que testar para entender o comportamento do modelo.
A. Fotos de pessoas e retratos (1–10)
- Foto amadora de mulher, como se tivesse sido tirada com smartphone.
- Retrato cotidiano fotografado no corredor de um supermercado.
- Foto de pessoa com contraluz cinematográfica.
- Reiluminação de pessoa com cenário noturno ao fundo.
- Alteração simultânea de clima e horário para uma noite chuvosa.
- Foto de moda que preserva a textura da pele.
- Foto de perfil direito com câmera em posição baixa.
- Mudança de câmera de foto frontal para ângulo de três quartos.
- Regeneração de rosto com grande mudança de expressão.
- Geração de «rosto-base» integrado a partir de múltiplas condições de iluminação.
Destaques: teste com mais de 200 imagens de 1girl (cerca de 1.483 votos), review inicial
B. Consistência de personagens (11–20)
- Ficha do mesmo personagem vista de frente, de lado e de costas.
- Material de definição que reúne close do rosto e figura de corpo inteiro.
- Geração de um único rosto consistente a partir de referência facial 2×2.
- Mover a mesma pessoa para outro local preservando o rosto.
- Alterar apenas as roupas da mesma pessoa.
- Alterar apenas o penteado da mesma pessoa.
- Substituir apenas a pose da mesma pessoa.
- Representar a mesma pessoa em versão realista e em versão de quadrinhos.
- Criar várias poses para tomadas contínuas.
- Usar ficha de personagem como material de referência para geração de vídeo.
Destaques: ficha de design de personagem, referência facial em quatro direções (cerca de 157 votos), Qwen versus FLUX.2 Krea (cerca de 116 votos)
C. Transferência de pose, câmera e composição (21–30)
- Transferir a pose da referência 2 para a pessoa da referência 1.
- Colocar uma pessoa sentada em uma cadeira amarela de outra imagem.
- Mudar uma pessoa em pé para sentada preservando a roupa.
- Mudar a composição frontal para plano médio em ângulo baixo.
- Expandir apenas o enquadramento preservando o tamanho do sujeito.
- Transferir uma pose de imagem de estúdio de poses para pessoa realista.
- Transformar pessoa realista em estilo Simpsons preservando a pose.
- Preservar a posição de uso do produto mesmo mudando o ângulo de câmera.
- Aplicar grande profundidade de campo tanto ao primeiro plano quanto ao fundo.
- Transformar em foto de grupo sem desfazer a disposição de várias pessoas.
Destaques: dicas de edição (cerca de 513 votos), Editing Beast (cerca de 840 votos)
D. Produtos, publicidade e prova virtual (31–40)
- Substituir em lote uma lata de Coca-Cola amassada por lata de outro produto.
- Alterar apenas cor e design preservando a deformação da lata.
- Refletir a cor do produto nas superfícies brancas ao redor.
- Colocar naturalmente no pulso de uma pessoa um relógio de outra imagem.
- Anúncio de relógio que preserva pose, tipo físico e iluminação originais.
- Prova virtual com cinco referências: modelo, roupa, sapato, bolsa e chapéu.
- Inserir o logotipo de outra imagem em uma foto de produto.
- Trocar somente a embalagem e manter o set de fotografia.
- Recorte de produto com fundo transparente para e-commerce.
- Apresentar o mesmo produto em vários fundos e iluminações.
Destaques: Editing Beast (cerca de 840 votos), exemplos oficiais de múltiplas referências
E. Edição de fundo, iluminação e materiais (41–50)
- Mudar um fundo diurno para noite chuvosa.
- Trocar apenas o fundo preservando a pessoa.
- Transferir ao mesmo tempo iluminação e fundo de uma imagem de referência.
- Substituir uma parede pela textura verde de outra imagem.
- Mudar um ambiente interno para iluminação quente de entardecer.
- Mudar para iluminação nítida de ensaio de alta moda.
- Recalcular a sombra da pessoa de acordo com a luz do fundo.
- Comparar realismo entre ruído normal e ruído Brownian.
- Comparar texturas do sampler Euler e de sampler customizado eta 0.50.
- Conciliar nitidez e naturalidade com sampler em duas etapas.
Destaques: dicas de edição, tópico de testes de configuração (cerca de 80 votos)
F. PNG transparente, recorte e edição local (51–60)
- PNG com fundo transparente de um único personagem.
- Asset de produto com fundo transparente.
- Material de design transparente composto por vários elementos.
- Extrair apenas uma pessoa de uma foto.
- Editar um sujeito em camada transparente.
- Inpainting de forma que inclui limites alfa.
- Alterar simultaneamente forma de fones de ouvido e área transparente.
- Substituir apenas a área de roupa pintada de vermelho.
- Editar apenas um acessório circundado por um círculo.
- Edição local que restaura completamente o exterior da máscara.
Destaques: edição alfa com LanPaint (cerca de 77 votos), review inicial
G. Outpainting e restauração (61–70)
- Expandir o canvas somente à esquerda.
- Expandir o canvas somente à direita.
- Expandir o canvas somente na parte superior.
- Expandir o canvas somente na parte inferior.
- Expandir esquerda, direita e baixo de uma vez.
- Completar as áreas vazias de uma foto inclinada diagonalmente.
- Restaurar fundo perdido por um recorte ruim.
- Completar o entorno de um sujeito parcialmente fora do enquadramento.
- Criar enquadramento amplo preservando o fundo original.
- Comparar granulação e alterações de contraste na restauração de fotos antigas.
Destaques: teste de outpainting (cerca de 62 votos), teste crítico de restauração fotográfica
H. Pôsteres, texto e design gráfico (71–80)
- Pôster de evento com manchete grande.
- Design publicitário que define antes a composição e a hierarquia de informação.
- Comparação para estabilizar letras grandes em 2 a 2,5 MP.
- Comparação para elevar o detalhamento de visuais sem texto perto de 4 MP.
- Design de embalagem com nome de produto.
- Gráfico de televisão vintage exibindo «Qwen».
- Compor naturalmente placas ou logotipos em outra imagem.
- Layout complexo por prompt longo.
- Teste de texto corrompido e inserção de chinês em infográfico em inglês.
- Pôster que compara qualidade de design com modelos de imagem da linha GPT.
Destaques: modelo de prompt para design, review breve e exemplo de TV vintage
I. Transformação de estilo, ilustração e criação de histórias (81–90)
- Transformar foto realista em estilo de quadrinhos.
- Transformar pessoa realista em estilo Simpsons.
- Transferir apenas o estilo visual de uma imagem de referência para outra.
- Mudar tonalidade preservando personagem e fundo.
- Gerar imagem em estilo de foto Polaroid.
- Gerar storyboard em formato de quatro quadros.
- Expandir a mesma pessoa para várias cenas.
- Tomadas de narrativa contínua que preservam animais, carros e pessoas.
- Arte com aparência de screenshot de anime contemporâneo.
- Comparação de falhas de estilo anime puxado para o realismo.
Destaques: experimento Polaroid, comparação de uso para anime com Krea 2, review inicial
J. Fluxo de trabalho, velocidade e comparação de qualidade (91–100)
- Comparar composição, textura e contraste com CFG de 1 a 5.
- Comparar CFG abaixo de 2 com o «excesso de processamento» em CFG 4.
- Geração rápida em 16 passos, 1 MP e INT8.
- Teste de qualidade de edição em 25 passos e 2K.
- Upscale de 2K para 4K após 30 passos.
- Edição que busca cerca de 2× de velocidade com LoRA de 4 passos.
- Geração de pessoa em 8 passos, 1024×1280 e cerca de 45 segundos em RTX 3060.
- Comparação de velocidade de fichas de personagem entre Qwen e FLUX.2 Krea.
- Teste de precisão de pixel em 2K e integração de 10 imagens de referência.
- Comparação para reduzir ruído em detalhes com Fix v2.0 e sampler especializado.
Destaques: tópico de lançamento de modelos para ComfyUI (cerca de 106 votos), LoRA de 4 passos com pouca VRAM (cerca de 44 votos), resultados de experimentos, Fix v2.0
Resumo da avaliação no Reddit
Pontos mais elogiados
- Desempenho de edição: preserva relativamente bem a imagem original mesmo ao mudar cor, fundo, material, pose ou produto.
- Múltiplas referências: forte para combinar pessoas, produtos, itens de moda e acessórios em uma criação.
- Consistência de personagens: promissor como ponto de partida para materiais de definição e tomadas contínuas.
- Imagens transparentes: pode gerar e editar o próprio alfa, não apenas recortar.
- Outpainting: fácil de usar para expandir várias direções de uma só vez.
- Tamanho e velocidade: prático para uma parte geradora de 7B, com muitas opções de quantização e aceleração.
Fraquezas apontadas repetidamente
- Mãos, dedos, braços e estruturas corporais complexas são instáveis.
- Rostos ao fundo e linhas finas tendem a se deteriorar.
- A saída padrão às vezes apresenta aparência ruidosa ou detalhes desorganizados.
- O contraste pode ser forte demais, fechando excessivamente os pretos.
- Na restauração de fotos, pode alterar arbitrariamente a granulação original ou formas sutis.
- Há críticas de que fichas de personagem deixam o corpo atarracado.
- Mais imagens de referência aumentam a chance de cruzamento de atributos e alucinações.
- Alguns estilos de anime são puxados para uma direção realista e cinematográfica.
- Há exemplos fortes de texto, mas letras pequenas e infográficos em inglês são instáveis.
- Configurações, reescrita de prompt e sampler fazem grande diferença no resultado.
O que surge dessa combinação de elogios e críticas é que o Qwen-Image 2.1 não é um «modelo universal perfeito em uma tentativa», mas um modelo de produção centrado em edição que melhora quanto mais cuidadosamente se ajustam configuração e fluxo de trabalho.
Como começar na prática
No ComfyUI, atualize para a versão mais recente e escolha Text-to-Image ou Image Edit nos modelos integrados. Fluxos de trabalho oficialmente compatíveis também são publicados no GitHub. Primeiro, crie uma imagem-base com os 40 passos próximos ao padrão oficial; depois, reduza para 16, 8 e 4 passos para comparar velocidade e qualidade.
Na edição, em vez de escrever vagamente «melhore mais», é mais fácil testar escrevendo na seguinte ordem.
- O que mudar.
- De qual imagem de referência trazer o elemento.
- O que não pode mudar em hipótese alguma.
- Como preservar luz, fundo, tipo físico, pose e composição.
- Quais elementos propensos a falhas incluir em instruções negativas.
Por exemplo, em uma composição de produto, deixe claro o objeto e as condições de preservação: «Preserve a pessoa e a pose da imagem 1 e coloque apenas o relógio da imagem 2 no pulso. Não altere tipo físico, fundo ou iluminação.» Em múltiplas referências, é importante não deixar ambígua a correspondência entre <image1> e <image2>.
Para imagens transparentes, exemplos compartilhados no Reddit indicam explicitamente «RGBA image», «alpha channel» e «background is transparent». Caso queira editar também a borda transparente, use processamento de máscara com suporte a alfa, como LanPaint.
Para quem é indicado
Qwen-Image 2.1 combina bem com os seguintes usos.
- Pessoas que querem produzir localmente com ComfyUI.
- Quem quer alterar apenas partes de pessoas ou produtos.
- Quem quer reunir diversos materiais de referência em um único anúncio ou cenário.
- Quem quer criar materiais de definição de personagens ou imagens de referência para vídeo.
- Quem quer criar PNGs transparentes ou assets para jogos e Web.
- Equipes de pesquisa e desenvolvimento que querem operar APIs de geração e edição de imagens em servidores dedicados.
Em contrapartida, para restauração fotográfica totalmente fiel, identidade rigorosa em obras longas e contínuas, poses complexas em que mãos e dedos são importantes, infográficos densos em letras pequenas ou adoção incondicional visando uso comercial, é indispensável comparar com outros modelos e verificar a licença.
Conclusão
A essência do Qwen-Image 2.1 está em integrar, em uma parte geradora relativamente pequena de 7 bilhões de parâmetros, T2I, edição de imagens, até 10 referências, edição local, RGBA transparente e extração de sujeitos. O que mais desperta entusiasmo no Reddit não é a simples geração de garotas bonitas, mas usos que encurtam etapas de produção: substituição de relógios e latas, fichas de personagem, transferência de fundo e iluminação, outpainting e edição alfa.
Por outro lado, a avaliação dos exemplos depende muito das configurações. CFG, sampler, número de passos, resolução, reescrita de prompt e LoRAs de aceleração podem mudar os resultados a ponto de parecerem modelos diferentes. É mais seguro começar pelas configurações oficiais, comparar uma alteração por vez e, em trabalhos importantes, fazer comparações cegas com outros modelos.
E o maior ponto de atenção é a licença. O fato de os pesos serem públicos não torna o uso comercial automaticamente livre. Tecnicamente o modelo é muito atraente, mas, para adotá-lo no trabalho, decida somente após conferir a licença oficial e as condições mais recentes.
Links principais
- Blog oficial do Qwen-Image 2.1
- Repositório oficial no GitHub
- Documentação do Hugging Face Diffusers
- Modelo para ComfyUI
- Reddit: coleção de exemplos 1girl
- Reddit: Editing Beast
- Reddit: dicas de edição
- Reddit: outpainting
- Reddit: inpainting do canal alfa
- Reddit: Qwen-Image 2.1 Fix v2.0
※Este artigo foi elaborado com base em informações oficiais e publicações públicas da comunidade disponíveis em 4 de outubro de 2026. Os votos no Reddit, as ferramentas ao redor do modelo e as condições de licença podem mudar.