Avaliei o desempenho de RAG de SLMs: comparei 25 modelos de 1B a 9B em croata e inglês
Depois de criar um modelo RAG em croata feito por mim e chegar até à quantização, desta vez quis investigar até que ponto os modelos pequenos (SLM) disponíveis por aí podem ser usados para RAG. Juntei 25 modelos — 10 da classe de 1B, 8 da classe de 3B e 7 da classe de 7B — ao meu modelo próprio de 320 milhões de parâmetros e pus todos a resolver os mesmos problemas em croata e inglês.
Adenda (no mesmo dia): também experimentei três modelos pequenos criados especificamente para RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Os resultados estão na secção posterior do artigo, «Adenda: também experimentei modelos específicos para RAG».
Primeiro, as conclusões.
- Na classe de 3–4B, já estão praticamente ao nível da classe de 8–9B. A taxa global de acerto em croata foi de 90% para Qwen3.5 4B e Gemma 4 E4B, contra 91% para o líder, Qwen3.5 9B
- O que faz a diferença é conseguir recusar quando não há resposta. Phi-4-mini, que está entre os melhores em taxa de acerto, inventou respostas em 64% dos textos longos sem resposta
- Em inglês, há mais modelos que recusam apesar de haver resposta. OLMo 3 7B recusou 47% dos parágrafos em inglês, e MiniCPM5 2B recusou 70%
- Em CPU, a classe de 7B demora mais de 30 segundos por pergunta longa. A classe de 1B demora 4–13 segundos. O meu modelo de 320 milhões demora 2,1 segundos e tem uma precisão semelhante à de Qwen3.5 0.8B
O que fiz
Problemas: perguntas criadas a partir da Wikipédia em croata, iguais às do artigo anterior. Para cada pergunta, forneci quatro tipos de texto.
- Parágrafo: um parágrafo de cerca de 100 tokens que contém a resposta
- Texto longo: um texto de cerca de 3.000 tokens que contém a resposta (incluindo artigos irrelevantes)
- Sem resposta (parágrafo / texto longo): texto que não contém a resposta. Era considerado correto se recusasse com «Não há resposta no texto»
Versão em inglês: traduzi os mesmos problemas para inglês com EuroLLM-9B. Problemas em que a resposta desapareceu na tradução, ou ficou em croata sem ser traduzida, foram excluídos de ambas as línguas, e comparei as mesmas 260 perguntas.
Instrução: em cada língua, dei a instrução «Usa apenas o texto abaixo e responde de forma breve numa frase. Se não houver resposta, responde apenas “Não há resposta no texto”».
Avaliação: pedi ao Qwen3.5 9B para comparar com a resposta-modelo e determinar «correta, incorreta ou recusou». Verifiquei eu próprio 65 casos; a avaliação era um pouco permissiva, considerando corretas respostas parciais, como responder apenas o ano, mas a classificação sobre ter recusado ou não esteve certa em todos os casos.
Taxa global de acerto: soma do número de respostas corretas para parágrafos e textos longos com o número de recusas corretas quando não havia resposta, dividida pelo total de problemas. É um valor que avalia tanto responder corretamente como manter-se em silêncio quando não se sabe.
Como foram executados: medi a precisão com vLLM numa RTX 4090, usando geração que escolhe sempre o token de maior probabilidade. Desativei o «modo de raciocínio», disponível em modelos que pensam antes de responder. Os modelos da classe de 7B foram convertidos para FP8 para caberem na memória da GPU.
Resultados: precisão (croata)
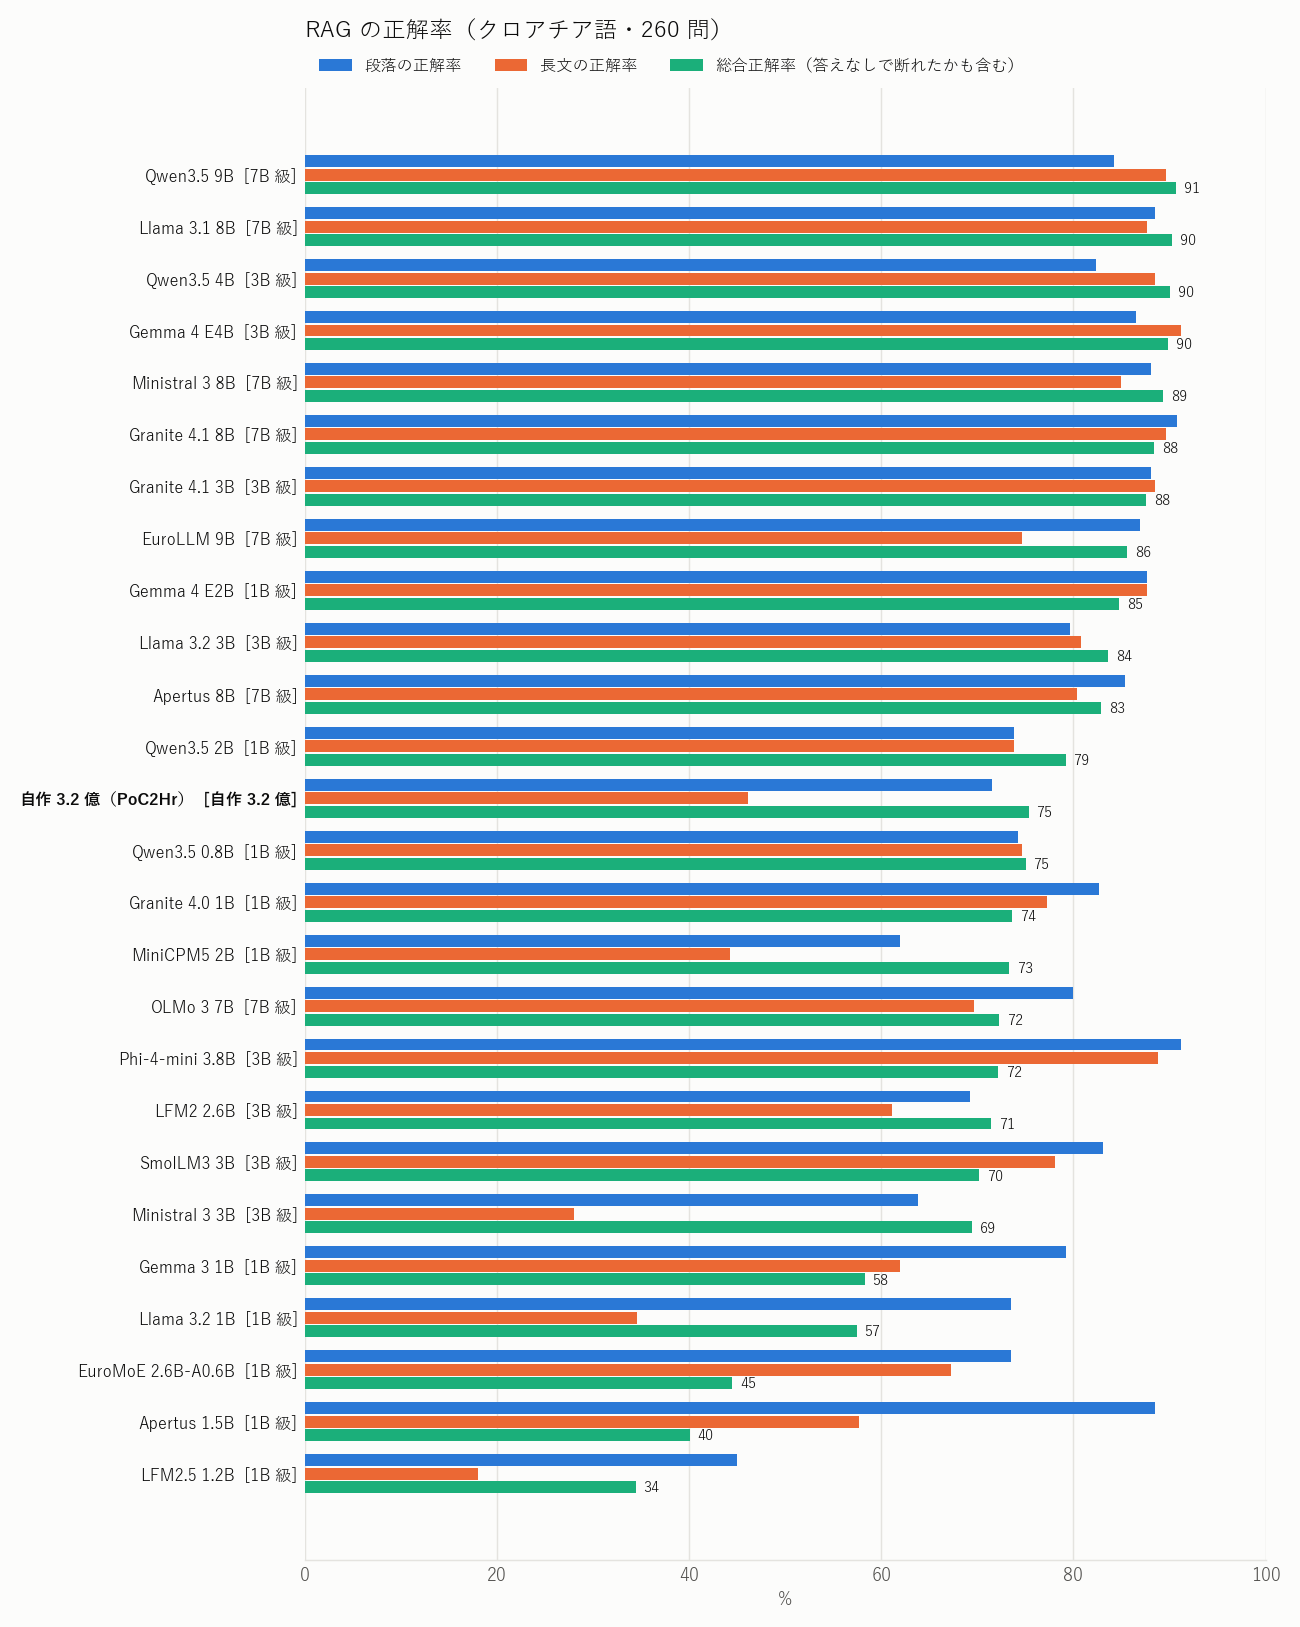
- Os primeiros estão praticamente empatados nos 90%. Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B e Gemma 4 E4B (90%)
- Na classe de 1B, Gemma 4 E2B destaca-se (85%). Apesar do nome indicar 2B, o ficheiro é relativamente grande, com 3,2 GB
- Há modelos com elevada taxa de acerto em parágrafos e textos longos, mas que caem na pontuação global. Phi-4-mini pertence ao grupo de topo, com 91% nos parágrafos e 89% nos textos longos, mas fica nos 72% no total. A razão é a seguinte: «invenções»
- O pior foi LFM2.5 1.2B (34%). Não acertava nos problemas com resposta e inventava respostas nos problemas sem resposta
Resultados: precisão (inglês)
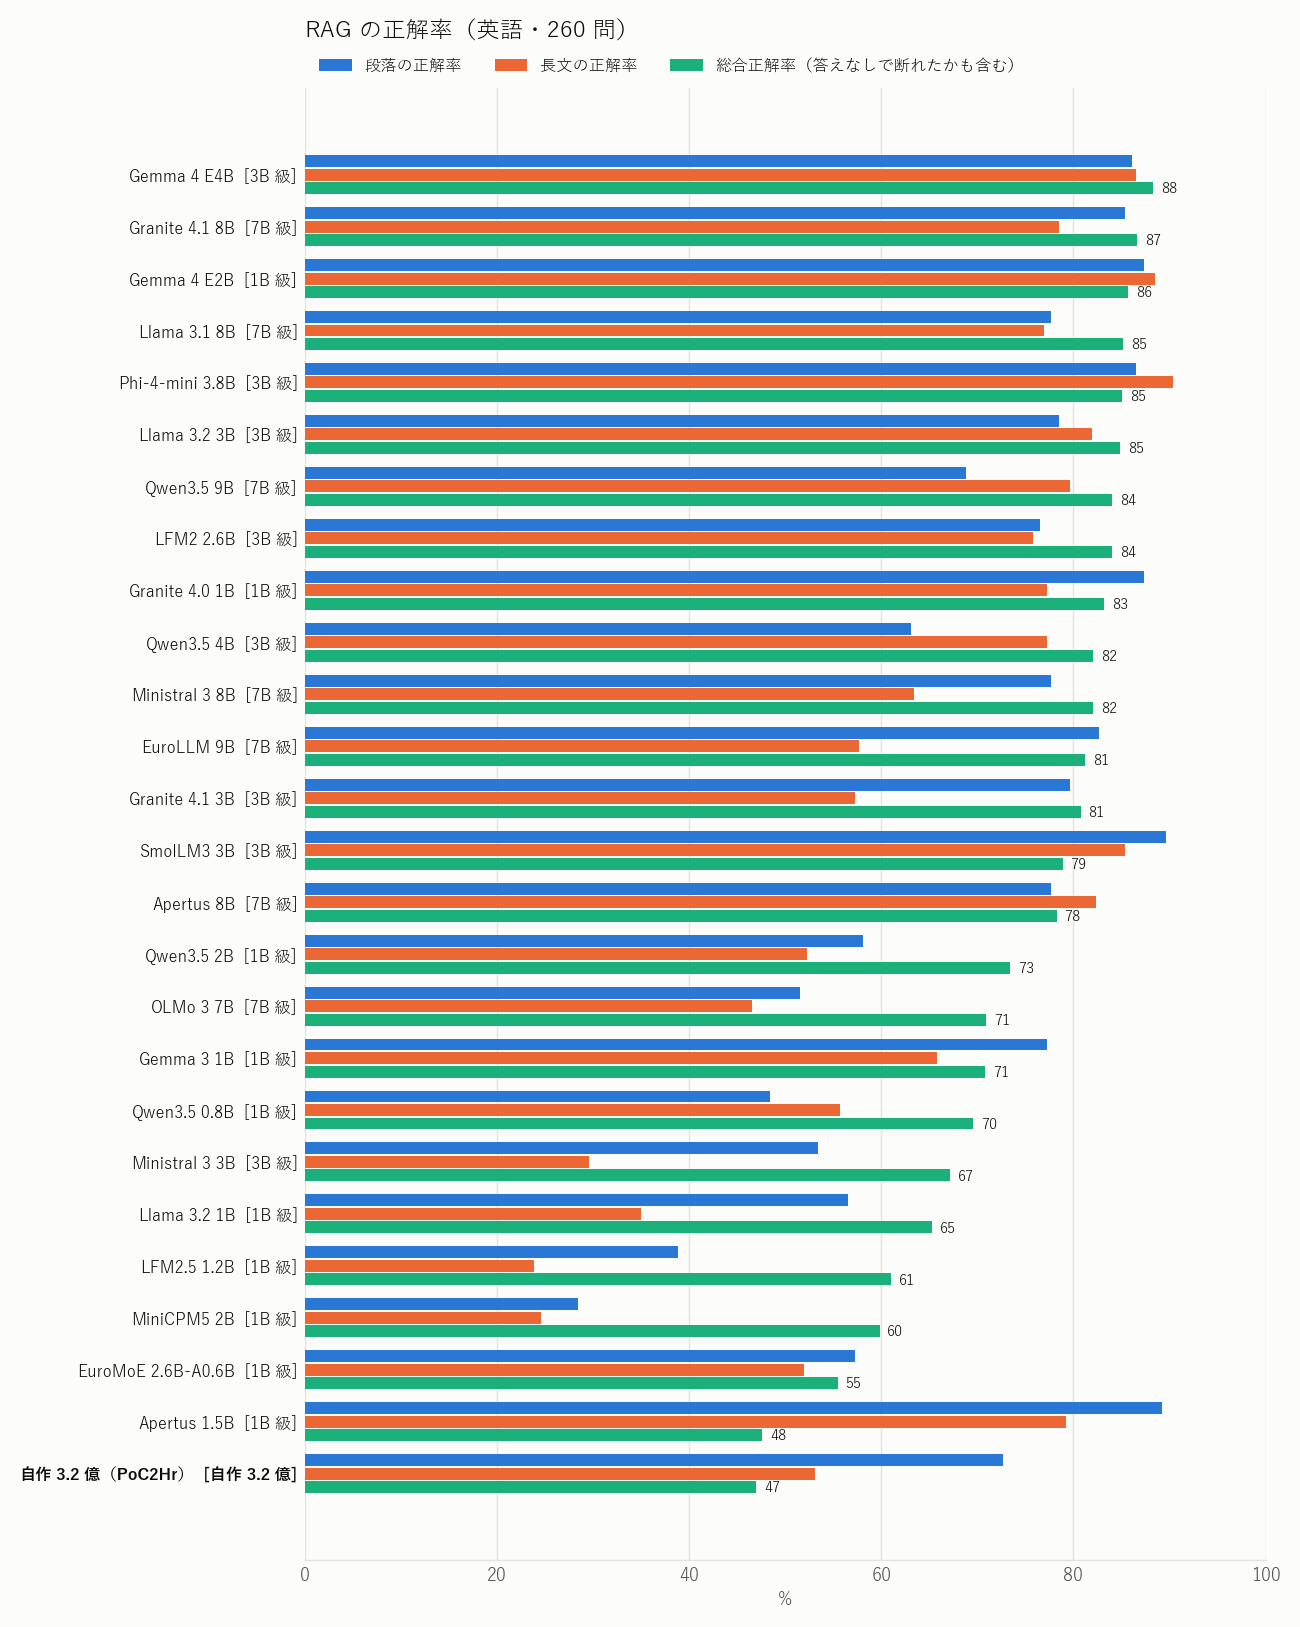
- O melhor foi Gemma 4 E4B (88%). Gemma 4 E2B também alcançou 86%, e Gemma 4 foi estável nas duas línguas
- Há modelos que descem no ranking em inglês. Qwen3.5 4B passa de 90% em croata para 82% em inglês. A causa é recusar apesar de existir resposta (35% dos parágrafos)
O que aprendi 1: o que faz a diferença é «conseguir recusar»
Percentagem de respostas inventadas ao receber um texto longo sem resposta (croata).
| Modelo | Invenções em textos longos sem resposta |
|---|---|
| Qwen3.5 4B | 9% |
| Modelo próprio de 320 milhões | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
Por exemplo, ao perguntar «Quando foi lançado Need for Speed Heat?» e fornecer um texto longo que não continha a resposta, Qwen3.5 9B respondeu «Não há resposta no texto», mas Phi-4-mini respondeu «agosto de 1969». Parece ter apanhado uma data que aparecia algures no texto.
Este é o maior problema em RAG. É perigoso escolher um modelo olhando apenas para a taxa de acerto. Entre as respostas dadas, Qwen3.5 4B e 9B tiveram as maiores proporções de respostas corretas, 91–92%, enquanto Phi-4-mini teve apenas 64%.
O que aprendi 2: em inglês, recusam demasiado
Ao contrário, em inglês havia muitos modelos que recusavam apesar de a resposta estar claramente escrita. Percentagem de recusas ao receber um parágrafo que continha a resposta.
| Modelo | Croata | Inglês |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
Por exemplo: «Quando foi a última vez que Paul Accola subiu ao pódio?». O parágrafo em inglês diz claramente «the last time in 2000», mas Qwen3.5 4B respondeu «Não há resposta no texto». Ao fazer a mesma pergunta em croata, respondeu corretamente «2000».
Ainda não sei a razão. A versão em inglês é tradução automática, por isso talvez a falta de naturalidade do texto tenha influência; ou talvez o modelo reaja fortemente, em inglês, à instrução «se não houver resposta, responde assim».
Resultados: velocidade em CPU
Como o meu caso de uso pressupõe execução em CPU, converti todos os modelos para o mesmo formato do llama.cpp (Q4_K_M) e medi-os num i7-13700K. A geração usou 8 threads e a leitura dos textos usou 16 threads. Apenas Ministral 3 não foi convertido corretamente, por isso usei o Q4_K_M oficial da Mistral.
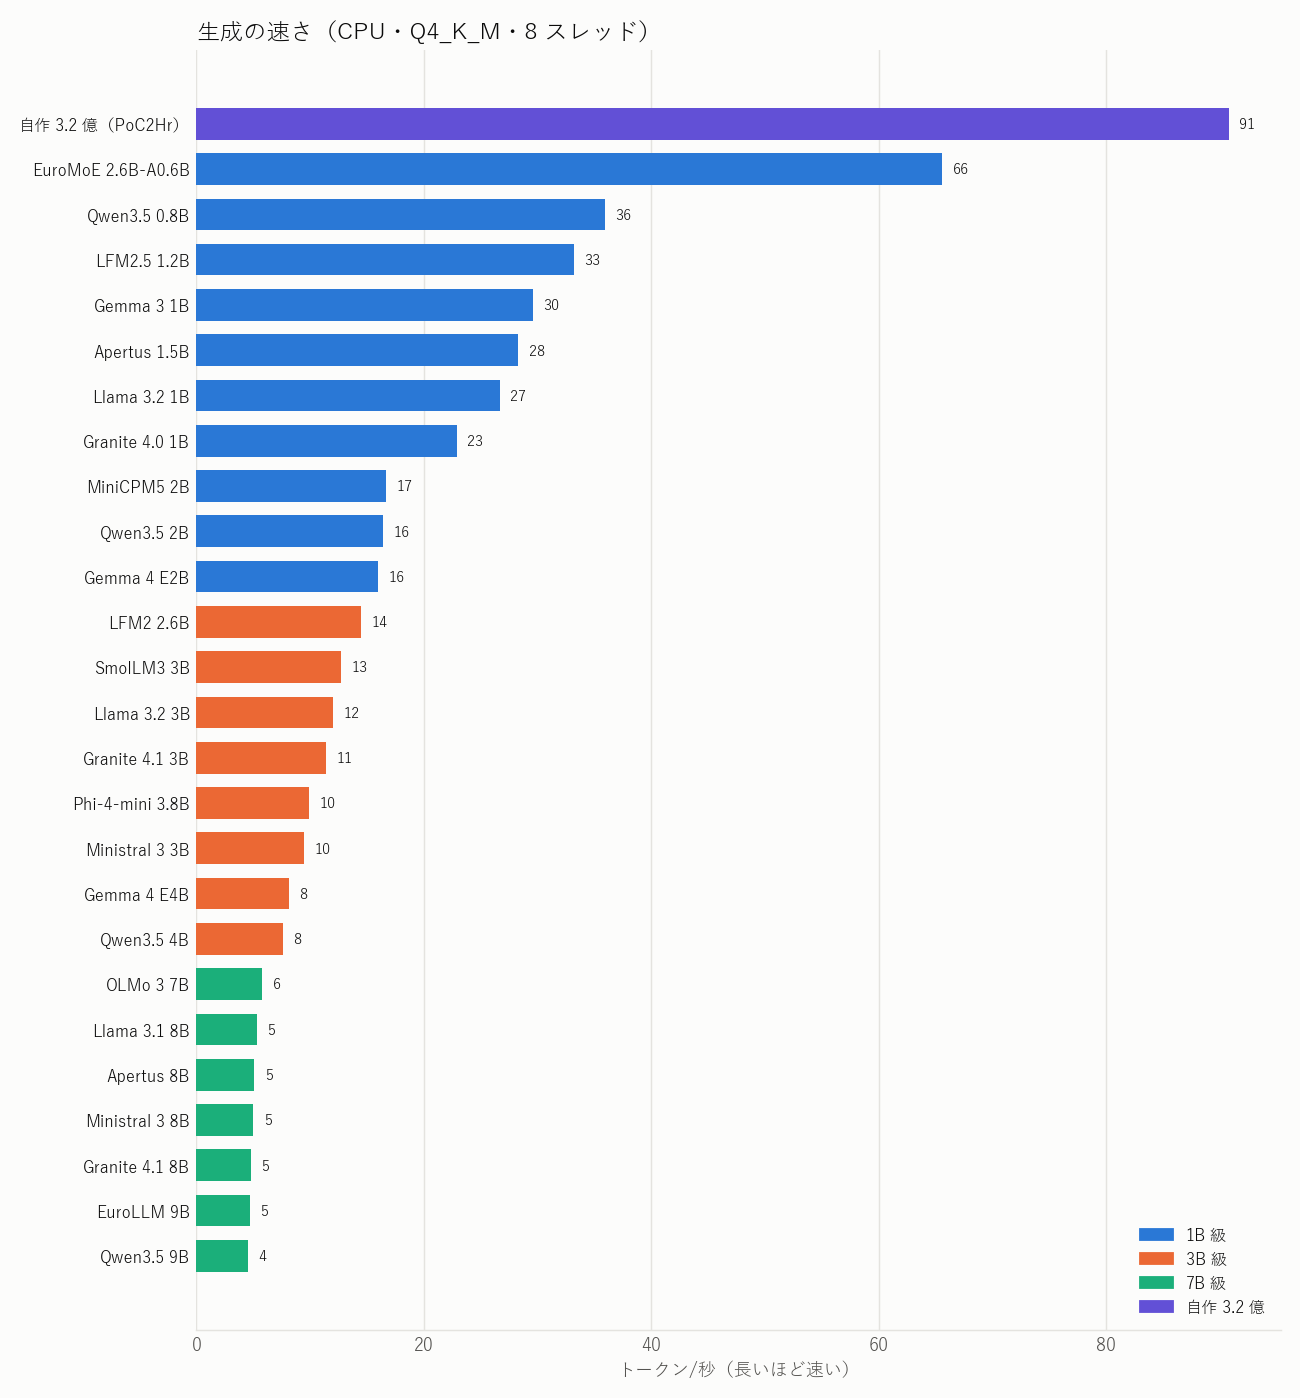
Também estimei o tempo até responder a uma pergunta longa. Para cada modelo, é a soma do tempo de leitura do número de tokens de entrada do texto longo com o tempo de geração do comprimento médio das respostas.
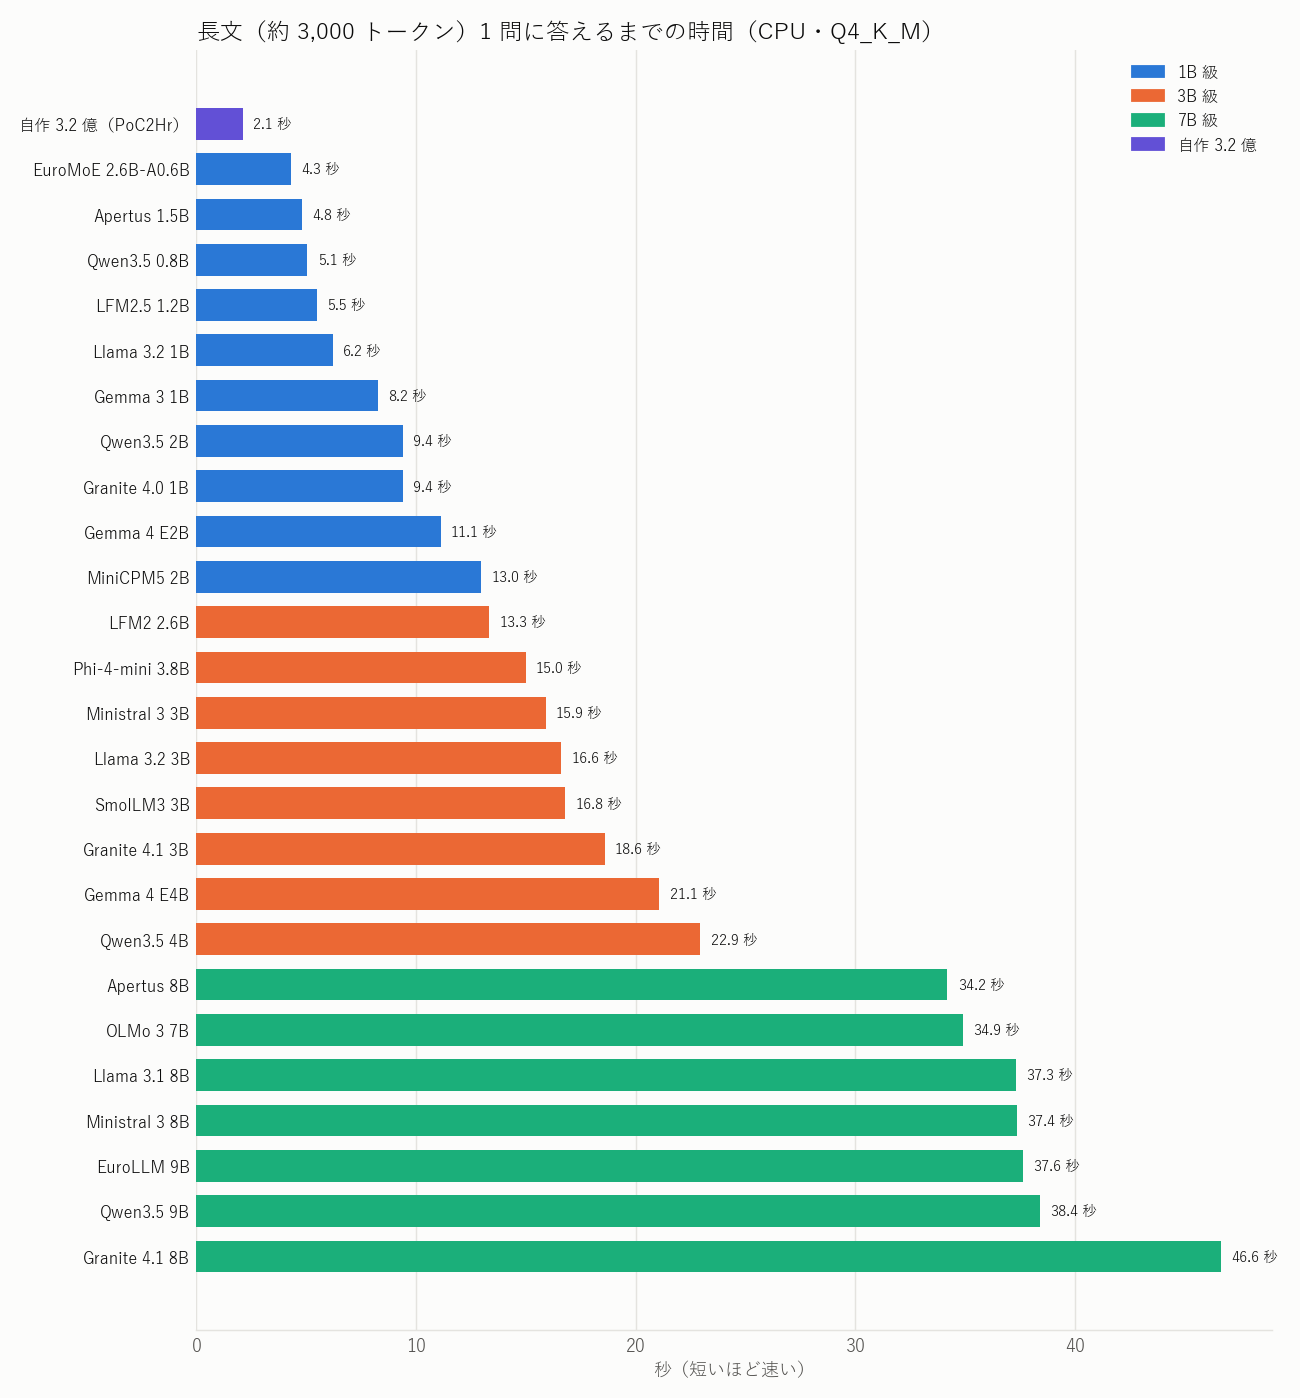
- A velocidade de geração é aproximadamente inversamente proporcional ao tamanho. A classe de 7B produz cerca de 5 tokens por segundo e demora 34–47 segundos por pergunta longa
- A classe de 3B demora 13–23 segundos, e a classe de 1B demora 4–13 segundos
- Mesmo para o mesmo texto longo, o número de tokens de entrada varia entre 2.443 e 3.796 consoante o modelo. Isto depende de quão compactamente o tokenizador consegue representar o croata, e o meu tokenizador criado especificamente para croata é o mais curto
Ao colocar velocidade e precisão lado a lado
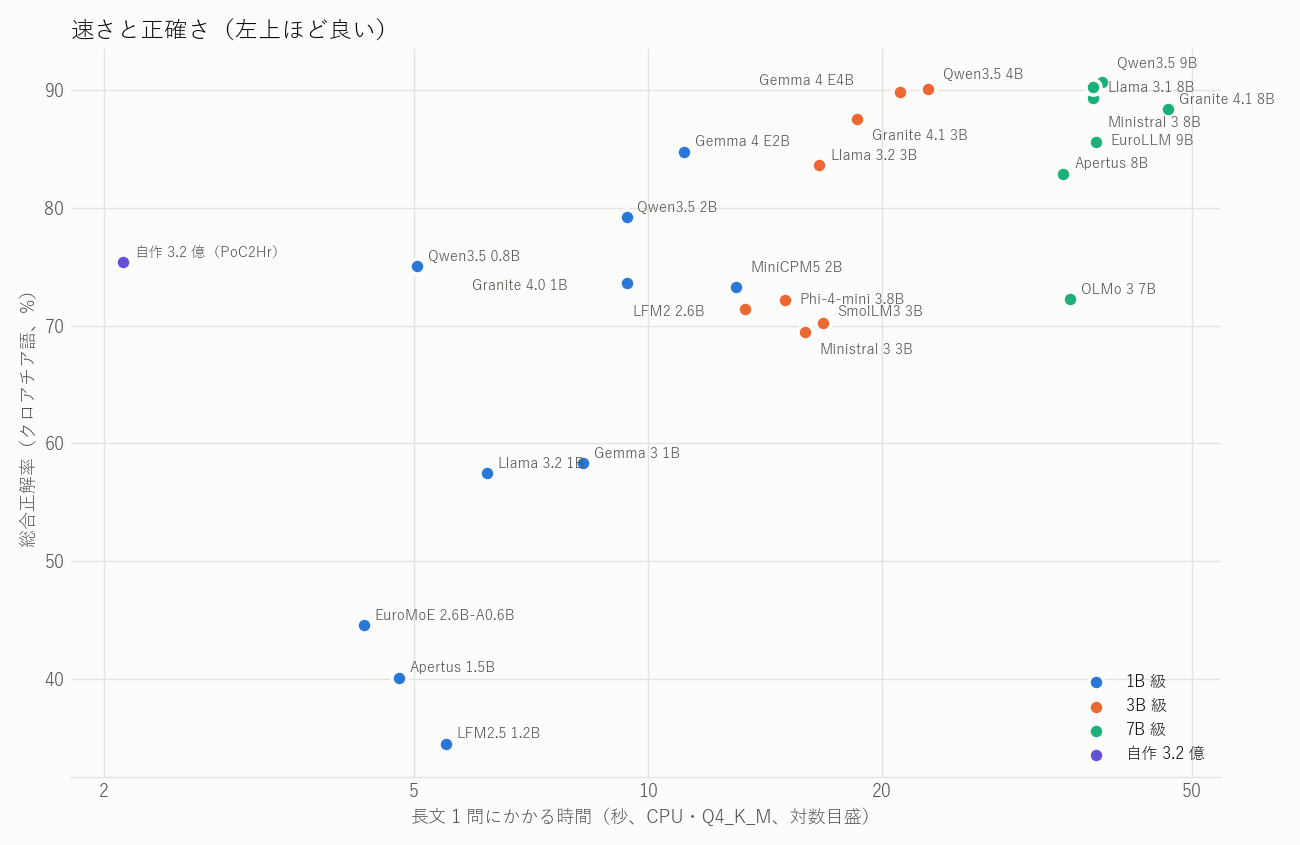
Quanto mais acima e à esquerda, «mais rápido e mais preciso».
- Os mais equilibrados são Gemma 4 E2B (11 segundos, 85%) e Qwen3.5 2B (9 segundos, 79%)
- Se a prioridade for a precisão, Qwen3.5 4B ou Gemma 4 E4B (21–23 segundos, 90%). São mais de 1,5 vezes mais rápidos do que a classe de 7B, com praticamente a mesma precisão
- O meu modelo de 320 milhões está noutro nível em velocidade (2,1 segundos). A taxa global de acerto de 75% é igual à de Qwen3.5 0.8B, e a baixa quantidade de invenções está ao nível dos modelos de topo. Contudo, a taxa de acerto em textos longos é de 46%, claramente inferior à de Qwen3.5 0.8B (75%) e Gemma 4 E2B (88%)
- Como o modelo próprio não foi treinado em inglês, inventou respostas em 91% dos textos longos sem resposta em inglês
Pontos a ter em conta
- A avaliação é feita por um LLM, pelo que não é perfeita. É um pouco permissiva
- A versão em inglês é tradução automática. Tanto as perguntas como a tradução foram criadas pelo EuroLLM-9B, pelo que o EuroLLM pode ter uma ligeira vantagem (o resultado foi 86%, a meio da tabela)
- Apertus 1.5B suporta contextos de apenas até 4.096 tokens, e 23% dos textos longos em croata não couberam. Os casos que não couberam foram contados como incorretos
- A precisão foi medida na GPU (vLLM; FP8 para a classe de 7B) e a velocidade na CPU (Q4_K_M), em ambientes diferentes. A quantização pode alterar ligeiramente a precisão
- A velocidade foi medida num PC que tinha as aplicações que uso normalmente ainda abertas. Todos os modelos foram medidos em sequência nas mesmas condições, pelo que acredito que serve para comparação
Considerações
- Para RAG, 4B já é suficiente. Os melhores modelos da classe de 3–4B são tão precisos quanto os da classe de 7–9B e, em CPU, são 1,5–2 vezes mais rápidos
- Ao escolher um modelo, convém verificar sempre se sabe recusar. Mesmo com taxas de acerto semelhantes, a proporção de invenções em textos sem resposta varia de 1% a 99% conforme o modelo. Em RAG é comum a pesquisa recuperar textos irrelevantes, por isso este é o fator com maior impacto
- O comportamento do mesmo modelo muda conforme a língua. Em inglês, muitos modelos foram demasiado cautelosos e deixaram escapar respostas. Não dá para saber sem testar efetivamente na língua que será usada
- O desafio do meu modelo são os textos longos. A capacidade de recusar e a velocidade já são suficientes; se a taxa de acerto em textos longos melhorar, deverá tornar-se bastante útil como «modelo RAG que corre em CPU». É isto que quero melhorar a seguir
Adenda: também experimentei modelos específicos para RAG
Pensei: «E os modelos afinados especificamente para RAG, como serão?» Por isso acrescentei três modelos pequenos específicos para RAG. As condições foram as mesmas de cima (as mesmas 260 perguntas e a mesma avaliação).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B com treino adicional em mais de um milhão de exemplos de respostas a documentos fornecidos. Suporta 9 línguas, incluindo inglês e japonês, mas não croata
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): modelos treinados em cerca de 3,1 milhões de exemplos sintéticos de RAG. Antes da resposta, escrevem «análise da pergunta → análise das fontes → rascunho» e incluem citações do texto na resposta. Suportam 7 línguas europeias, mas não croata. O contexto suportado vai até 4.096 tokens
- Para comparação, também medi o LFM2-1.2B base, do qual LFM2-1.2B-RAG foi criado
Dei ao LFM2-1.2B-RAG a mesma instrução dos outros modelos. Pleias aceita apenas o seu formato de entrada específico (que separa a pergunta e as fontes com símbolos próprios), por isso usei o mesmo formato da biblioteca oficial e avaliei apenas a parte final da resposta. Assim, não foi possível dar ao Pleias a instrução «se não houver resposta, responde assim».
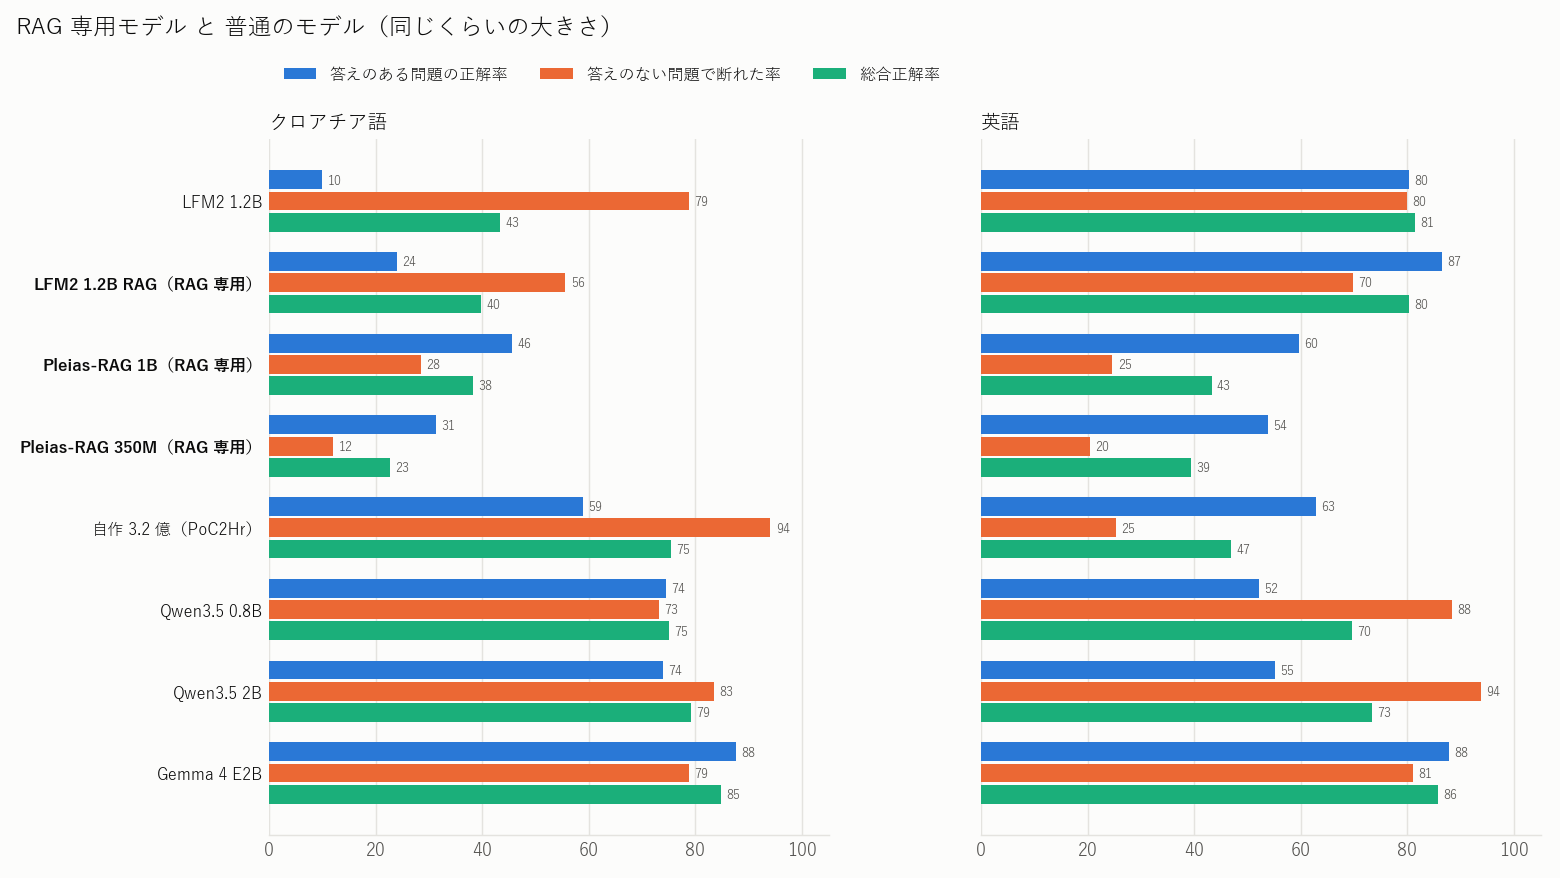
| Modelo | Global (croata) | Global (inglês) | Invenções em textos longos sem resposta (croata / inglês) | Tempo por pergunta longa (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (modelo base) | 43% | 81% | 42% / 36% | 7,8 segundos |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8,1 segundos |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16,9 segundos |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6,0 segundos |
| Referência: modelo próprio de 320 milhões | 75% | 47% | 9% / 91% | 2,1 segundos |
| Referência: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5,1 segundos |
| Referência: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11,1 segundos |
Em resumo, nestes problemas não encontrei nenhuma vantagem dos modelos específicos para RAG sobre os modelos normais.
LFM2-1.2B-RAG: passou a responder mais, mas também aumentou as invenções
Em inglês, comparado com o LFM2-1.2B original, a taxa de acerto em problemas com resposta aumentou (parágrafos: 83% → 87%; textos longos: 78% → 86%). Mas também aumentaram as invenções em textos sem resposta (parágrafos: 4% → 10%; textos longos: 36% → 51%), pelo que o resultado global foi praticamente igual, 81% → 80%. O treino adicional para RAG parece tê-lo deslocado para uma orientação de «responder de qualquer forma».
Em croata, o modelo base já é praticamente inutilizável. O LFM2-1.2B original recusou 93% dos parágrafos que tinham resposta, dizendo «não há resposta», e a versão RAG destacou-se por respostas que devolviam literalmente a instrução, como «Odgovori kratko, jednom rečenicom. (Responde de forma breve, numa frase.)». Como o croata não está entre as línguas suportadas, é compreensível.
Pleias-RAG: inclui citações, mas essas citações não estão no texto
Pleias quase nunca recusou mesmo em textos sem resposta. Em inglês, inventou respostas em 78% dos parágrafos sem resposta e em 73% dos textos longos sem resposta (1B).
Também há dúvidas sobre a sua proposta de «respostas com citações». Contei a proporção de frases citadas que podiam ser encontradas literalmente no texto (é correspondência exata, ignorando apenas diferenças de espaços, por isso citações ligeiramente parafraseadas também entram como «não encontradas»).
| Problemas com resposta | Problemas sem resposta | |
|---|---|---|
| Pleias-RAG 1B (inglês) | 64% | 42% |
| Pleias-RAG 1B (croata) | 57% | 53% |
| Pleias-RAG 350M (inglês) | 66% | 39% |
| Pleias-RAG 350M (croata) | 52% | 40% |
Por exemplo: «Que banda escreveu primeiro a canção “Tourniquet”?» (a resposta é Soul Embraced).
- Ao fornecer um parágrafo que não continha a resposta, o 1B respondeu «foi escrita por Amy Lee» e incluiu como citação uma frase que não existe no texto: «Amy Lee (born Amy Leigh Lee, November 1, 1970) ...»
- Mesmo ao fornecer o parágrafo que continha a resposta, respondeu «foi escrita por Amy Lee». Além disso, a citação acrescentada foi «originally written ... for the Christian death metal band Soul Embraced»: a citação está correta, mas a resposta contradiz a citação
Uma citação faz parecer que a resposta se baseia corretamente no texto, o que pode tornar isto ainda mais perigoso.
Também em velocidade, Pleias escreve uma análise antes da resposta, pelo que as respostas são longas (em média, 381–420 tokens em textos longos). O modelo de 1B demorou 16,9 segundos por pergunta longa, mais do que Gemma 4 E2B (11,1 segundos). Além disso, 25% dos textos longos em croata não couberam no contexto (foram contados como incorretos; como o tempo é a média apenas dos problemas que couberam, na prática demoraria um pouco mais).
Porque aconteceu isto? (hipóteses)
- Língua: o croata não está entre as línguas suportadas pelos três modelos. Mas também perdem para os modelos normais em inglês
- Formato dos problemas: desta vez, os problemas consistiam em «responder brevemente a partir de um único texto / recusar se não houver resposta». Pleias é avaliado em problemas que exigem combinar várias fontes para responder (como HotpotQA), por isso o formato em que é forte pode ser diferente
- Forma de recusar: é possível dizer aos modelos normais «se não houver resposta, responde assim», mas Pleias não tem onde receber essa instrução. O próprio modelo tem um mecanismo para concluir «não consigo responder com estas fontes», mas desta vez quase não funcionou
Resumo da adenda
- É melhor não escolher apenas por ter o nome “específico para RAG”. Nestas condições, modelos normais de instruções, como Gemma 4 E2B e Qwen3.5, foram mais precisos e recusaram quando deviam fazê-lo
- Respostas com citações só têm valor se as próprias citações forem verificadas. Apenas 40–70% das citações do Pleias foram encontradas literalmente no texto
- O meu modelo próprio supera modelos específicos para RAG de tamanho semelhante. Comparado com Pleias-RAG 350M, o resultado global em croata foi 75% contra 23%, e o tempo por pergunta longa foi 2,1 segundos contra 6,0 segundos. Houve valor em criá-lo especificamente para croata
A velocidade dos quatro modelos acrescentados foi medida na noite do mesmo dia, no mesmo PC e nas mesmas condições. Também os acrescentei ao gráfico de velocidade e precisão.
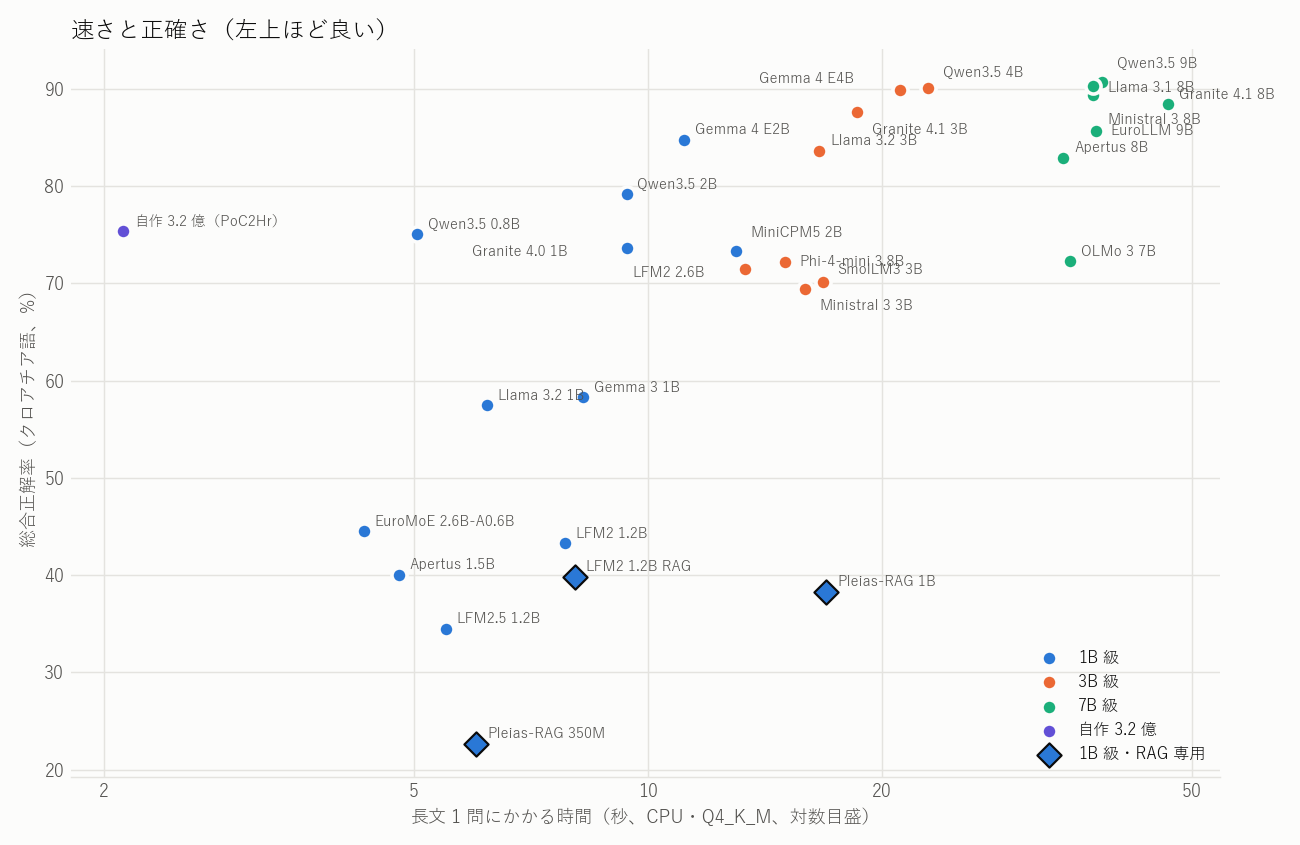
Todos os resultados
Croata
| Modelo | Classe | Parágrafo correto | Texto longo correto | Geral | Invenção quando não há resposta (parágrafo/texto longo) | Proporção de corretas entre as respondidas |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | classe 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | classe 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | classe 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | classe 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | classe 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | classe 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | classe 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | classe 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | classe 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | classe 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | classe 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | classe 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Próprio 320M | próprio | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | classe 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | classe 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | classe 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | classe 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | classe 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | classe 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | classe 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | classe 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | classe 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | classe 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | classe 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | classe 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | classe 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | classe 1B・exclusivo para RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | classe 1B・exclusivo para RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | classe 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | classe 1B・exclusivo para RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Inglês
| Modelo | Classe | Parágrafo correto | Texto longo correto | Geral | Invenção quando não há resposta (parágrafo/texto longo) | Proporção de corretas entre as respondidas |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | classe 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | classe 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | classe 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | classe 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | classe 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | classe 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | classe 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | classe 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | classe 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | classe 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | classe 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | classe 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | classe 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | classe 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | classe 1B・exclusivo para RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | classe 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | classe 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | classe 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | classe 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | classe 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | classe 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | classe 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | classe 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | classe 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | classe 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | classe 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | classe 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Próprio 320M | próprio | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | classe 1B・exclusivo para RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | classe 1B・exclusivo para RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Velocidade na CPU (i7-13700K・llama.cpp Q4_K_M)
| Modelo | Tamanho | Geração (tokens/s) | Leitura (tokens/s) | Número de tokens de entrada do texto longo | Tempo por pergunta de texto longo |
|---|---|---|---|---|---|
| Próprio 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 s |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 s |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 s |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 s |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 s |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 s |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 s |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 s |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 s |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 s |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 s |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 s |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 s |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 s |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 s |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 s |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 s |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 s |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 s |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 s |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 s |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 s |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 s |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 s |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 s |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 s |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 s |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 s |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 s |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 s |
※ Para Apertus 1.5B e Pleias-RAG, a média considera apenas os textos longos que cabiam no contexto de 4.096 tokens.