Quantifiquei meu LLM caseiro de 300 milhões de parâmetros e comparei velocidade e precisão na CPU
O modelo de 320 milhões de parâmetros para RAG em croata que criei no artigo anterior. Como ele foi pensado para rodar na CPU, desta vez fiz a quantização e testei até que ponto ele podia ficar menor e mais rápido, e quanto a precisão cairia.
Primeiro, a conclusão.
- Q6_K é o ponto ideal. Ocupa 1/5 do tamanho (254 MB), gera cerca de 4 vezes mais rápido e tem a mesma precisão do modelo original
- Q2_K quebra. É rápido, mas começa a dizer “não há resposta” até em perguntas que têm resposta
- Surpreendentemente, Q3_K_M foi mais preciso que Q4_K_M
O que fiz
Convertti o modelo feito em PyTorch para um formato que pode ser executado pelo llama.cpp, muito usado para inferência em CPU (GGUF), e o salvei em oito níveis de precisão.
- Exportei o modelo no mesmo formato do Qwen3 e o converti para GGUF
- Como o tokenizador é próprio, o llama.cpp recusou a conversão por ser um “tokenizador desconhecido”. Comparei as regras de separação de palavras e elas eram idênticas, caractere por caractere, às do Qwen2; então o registrei como Qwen2 para prosseguir
- Verifiquei se a conversão estava correta. A tokenização de 160 textos coincidiu integralmente com a versão em PyTorch. Em 20 perguntas, ao gerar sempre escolhendo a palavra com maior probabilidade, as saídas também coincidiram perfeitamente nas 20
- Usei
llama-quantizepara criar as versões de F16 a Q2_K
Portanto, o F32 da tabela contém exatamente o mesmo conteúdo da versão em PyTorch. Ele é a referência da comparação.
Como medi
- A CPU é um i7-13700K. Não usei GPU
- As configurações do llama.cpp foram 8 threads para geração e 16 threads para leitura do texto (foi a combinação mais rápida que encontrei nos testes)
- Para 100 perguntas de avaliação × 4 tipos de contexto, cada modelo respondeu 400 vezes
- Parágrafo: um parágrafo de cerca de 100 tokens que contém a resposta
- Texto longo: um texto de cerca de 3.000 tokens que contém a resposta (também há artigos irrelevantes misturados)
- Sem resposta (parágrafo/texto longo): texto que não contém a resposta. Recusar conta como acerto
- Como o artigo anterior usou 300 perguntas, os números diferem um pouco
Resultados: precisão
| Formato | Tamanho | Acertos em parágrafos | Acertos em textos longos | Recusou em textos longos | Alucinação (sem resposta: parágrafo/texto longo) | Precisão após verificação |
|---|---|---|---|---|---|---|
| F32 (referência) | 1.233MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81,9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81,3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84,4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75,9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80,4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72,2% |
“Precisão após verificação” é a proporção correta entre as respostas dadas após confirmar por programa se a citação do modelo realmente está no texto e, caso não esteja, substituí-la por “sem resposta”.
- F16, Q8_0 e Q6_K são praticamente iguais à referência. A diferença é de apenas uma ou duas perguntas
- A partir de Q5_K_M, aumentam as recusas em vez dos erros. Parece que o comportamento ensinado no artigo anterior — recusar quando não tem confiança — continua presente. As alucinações não aumentaram
- Q4_K_M foi pior que Q3_K_M. Foram 37% contra 48% em textos longos. Há alguma variação com 100 perguntas, mas 11 pontos é bastante. Ainda não investiguei o motivo
- Q2_K recusa 78% dos textos longos. Já é outro modelo
Resultados: velocidade
| Formato | Velocidade de geração | Tempo médio por execução |
|---|---|---|
| PyTorch fp32 (referência) | parágrafo 14,6 · texto longo 6,7 tok/s | — |
| F32 | 18,7 tok/s | 2,76 segundos |
| F16 | 35,9 tok/s | 2,08 segundos |
| Q8_0 | 59,0 tok/s | 1,93 segundos |
| Q6_K | 73,1 tok/s | 1,33 segundos |
| Q5_K_M | 81,2 tok/s | 1,26 segundos |
| Q4_K_M | 89,1 tok/s | 1,10 segundos |
| Q3_K_M | 103,4 tok/s | 1,12 segundos |
| Q2_K | 119,9 tok/s | 1,07 segundos |
Os números do llama.cpp são a média de 400 execuções (reunindo parágrafos, textos longos e casos sem resposta). Os números do PyTorch foram medidos no artigo anterior.
- A velocidade de geração é quase inversamente proporcional ao tamanho. Na CPU, ela depende mais da velocidade de leitura dos pesos da memória do que do cálculo; portanto, quanto menor, mais rápido
- Mesmo em F32, o llama.cpp é mais rápido que o PyTorch
- Porém, abaixo de Q6_K, o tempo por execução quase não diminui. Nesse comprimento, o tempo inicial para ler o texto passa a pesar mais
Vídeo: fiz a CPU responder à mesma pergunta com texto longo
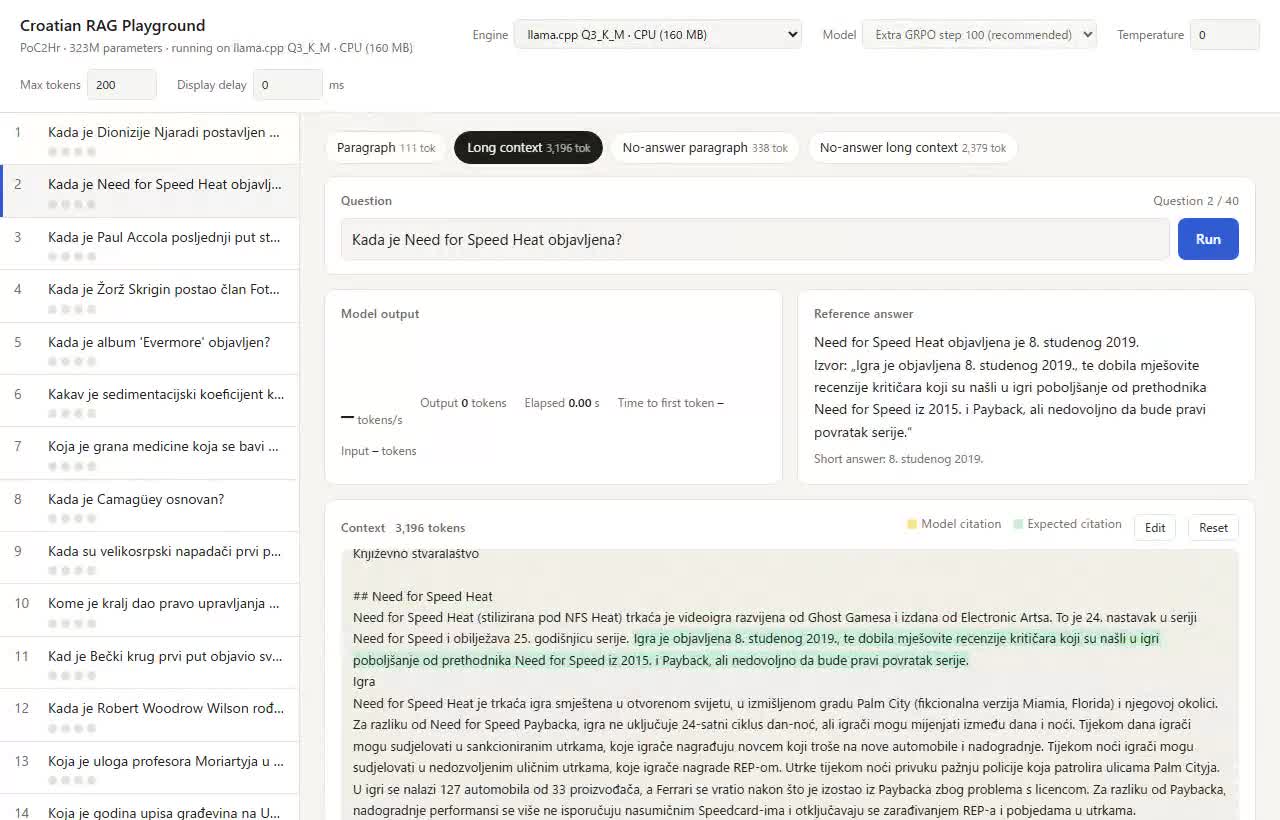
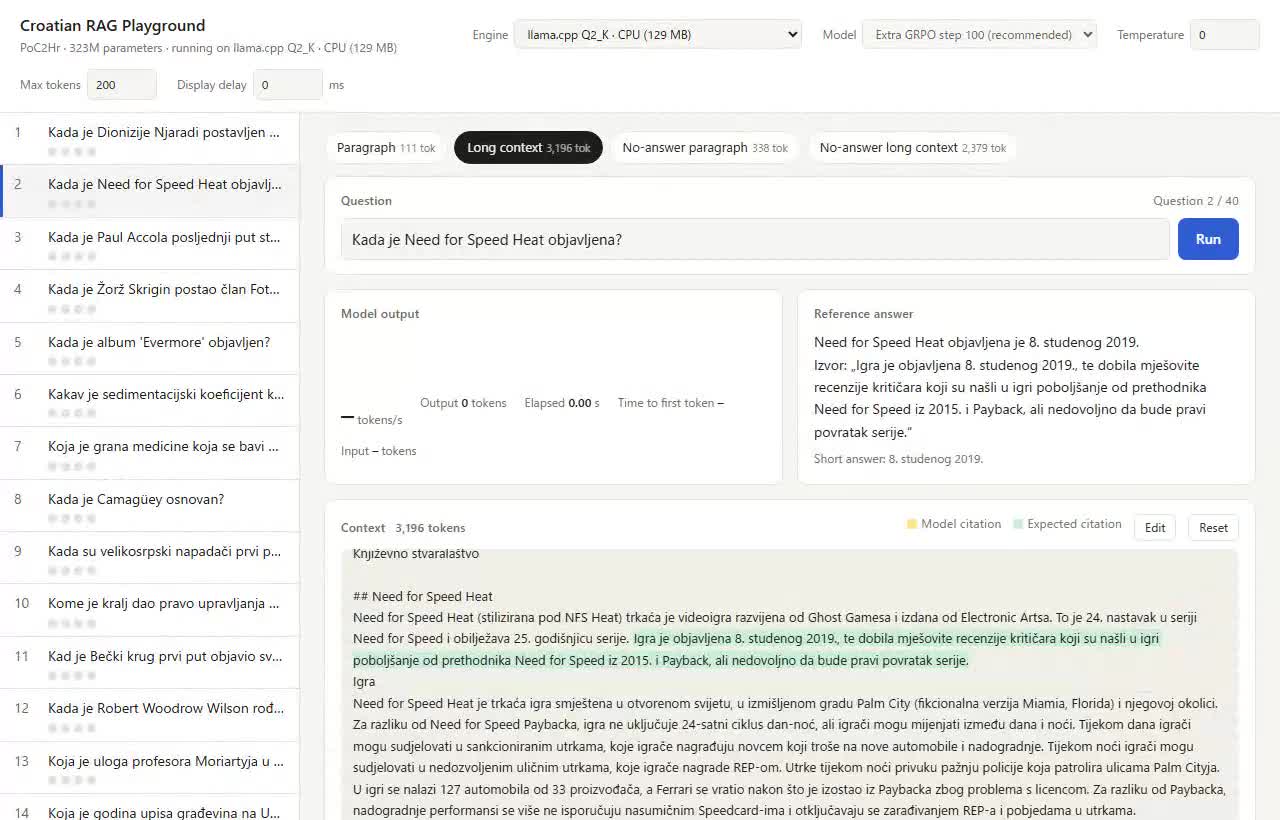
Forneci um texto de cerca de 3.200 tokens e perguntei: “Quando Need for Speed Heat foi lançado?”. A resposta correta é 8 de novembro de 2019.
Como a execução foi gravada e também renderizava a tela no navegador, as velocidades do vídeo são menores que as da tabela acima. Considere-o uma comparação lado a lado.
| Formato | Velocidade de geração no vídeo | Até o primeiro caractere | Total | Resultado |
|---|---|---|---|---|
| PyTorch fp32 | 5,5 tok/s | 4,8 segundos | 18,5 segundos | Correto |
| F32 | 14,2 tok/s | 2,8 segundos | 8,1 segundos | Correto |
| F16 | 25,9 tok/s | 3,5 segundos | 6,4 segundos | Correto |
| Q8_0 | 38,2 tok/s | 4,0 segundos | 5,9 segundos | Correto |
| Q6_K | 41,6 tok/s | 2,6 segundos | 4,4 segundos | Correto |
| Q5_K_M | 46,3 tok/s | 2,6 segundos | 4,3 segundos | Correto |
| Q4_K_M | 47,2 tok/s | 2,3 segundos | 4,7 segundos | Correto (resposta mais longa) |
| Q3_K_M | 56,7 tok/s | 2,5 segundos | 4,5 segundos | Correto (resposta mais longa) |
| Q2_K | 61,3 tok/s | 2,7 segundos | 2,8 segundos | Recusou |
De F32 a Q5_K_M, tanto a resposta quanto a citação foram idênticas, caractere por caractere, à versão em PyTorch. Q4_K_M e Q3_K_M deram respostas mais longas, mas as citações estavam corretas. Mesmo havendo resposta, Q2_K recusou dizendo: “Não há resposta no texto”.
PyTorch fp32 (modelo original)
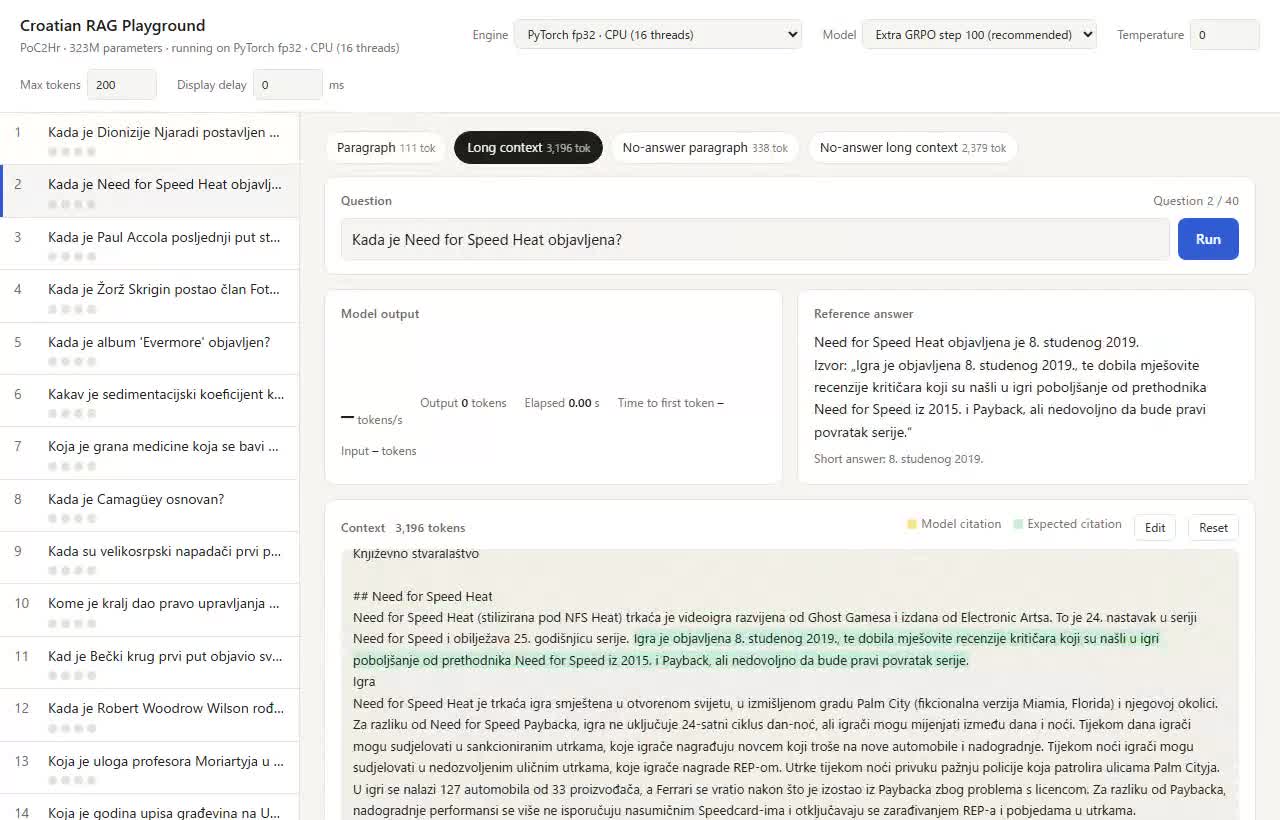
llama.cpp F32 (1.233MB)
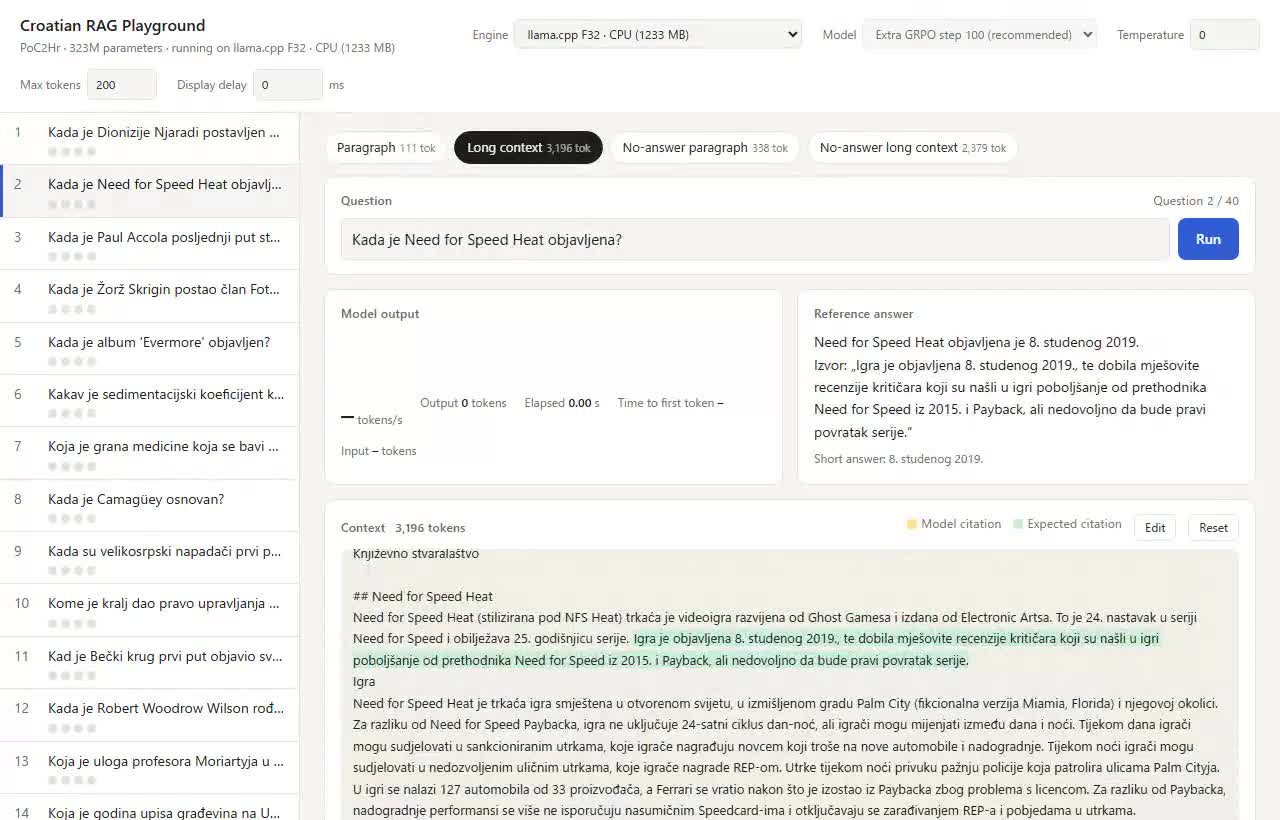
llama.cpp F16 (617MB)
llama.cpp Q8_0 (329MB)
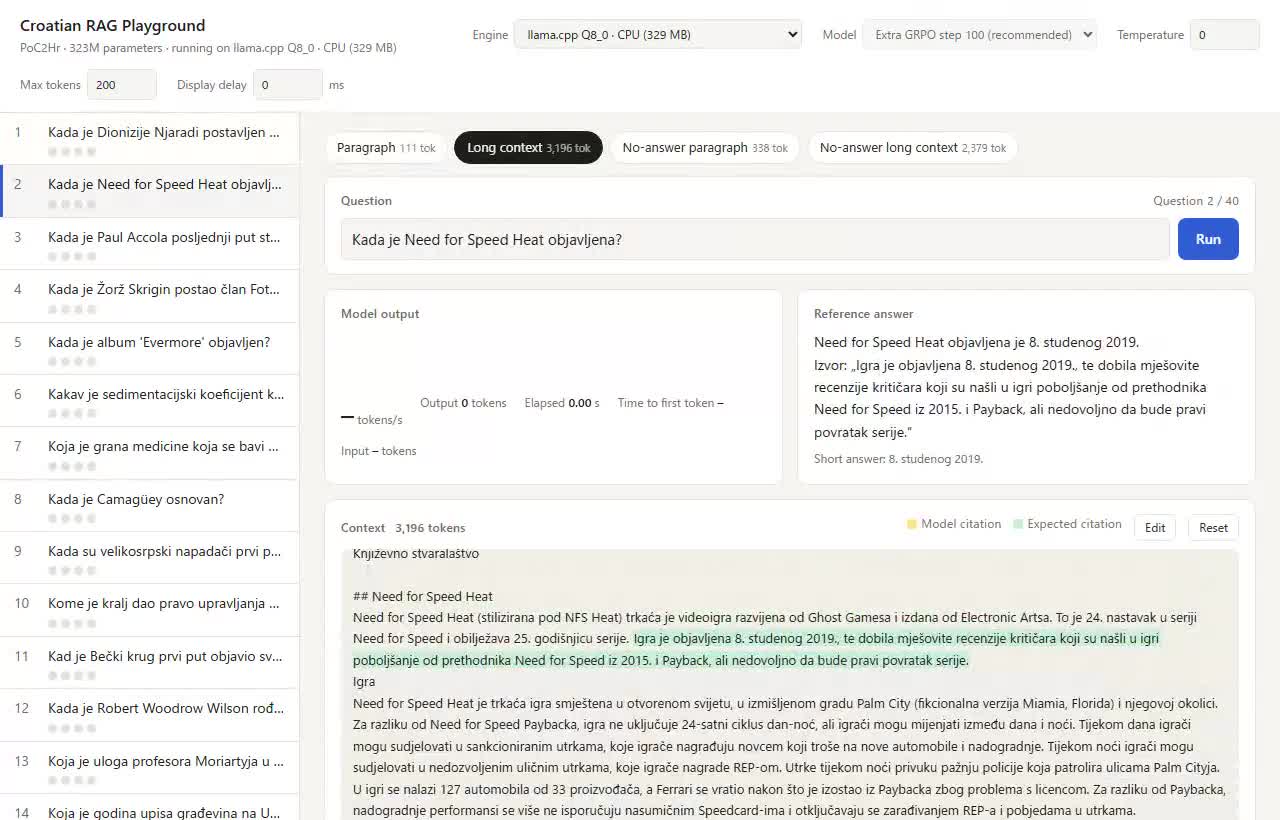
llama.cpp Q6_K (254MB)
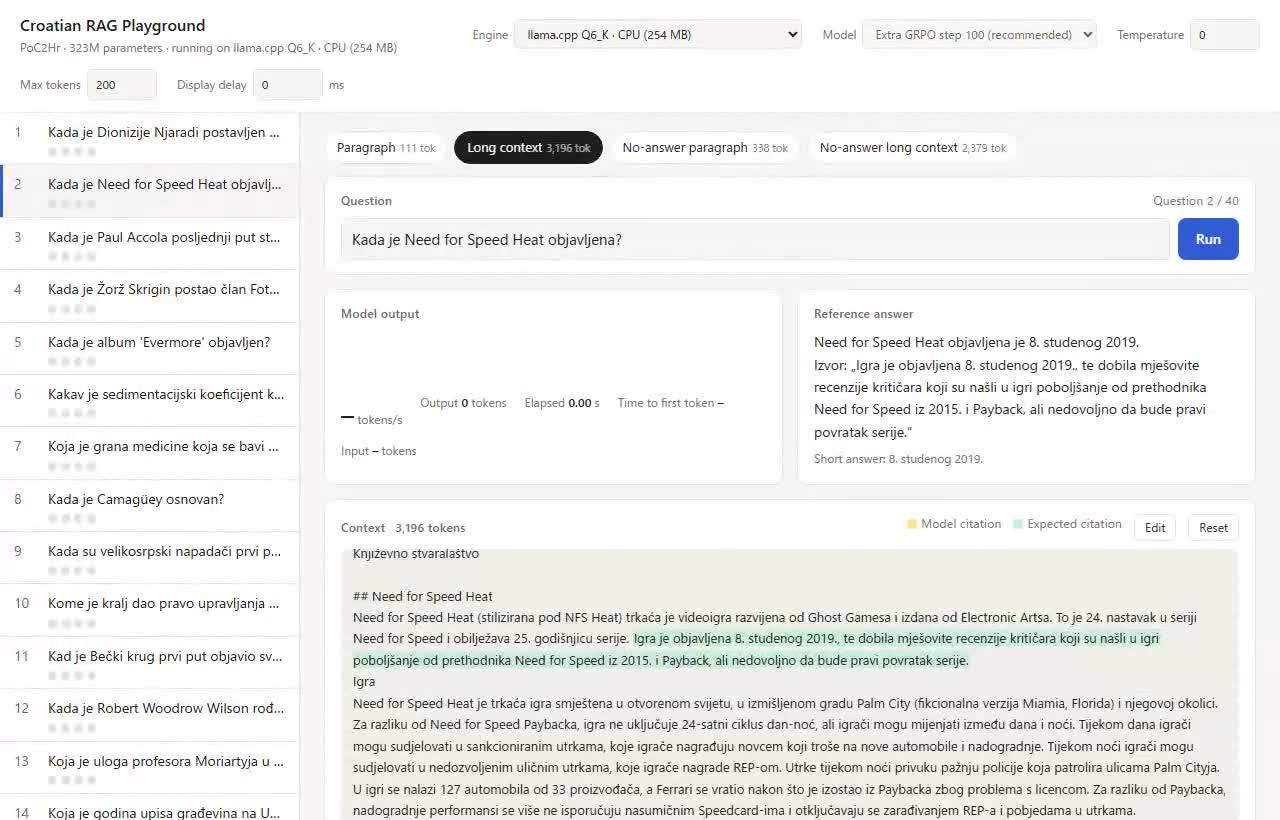
llama.cpp Q5_K_M (223MB)
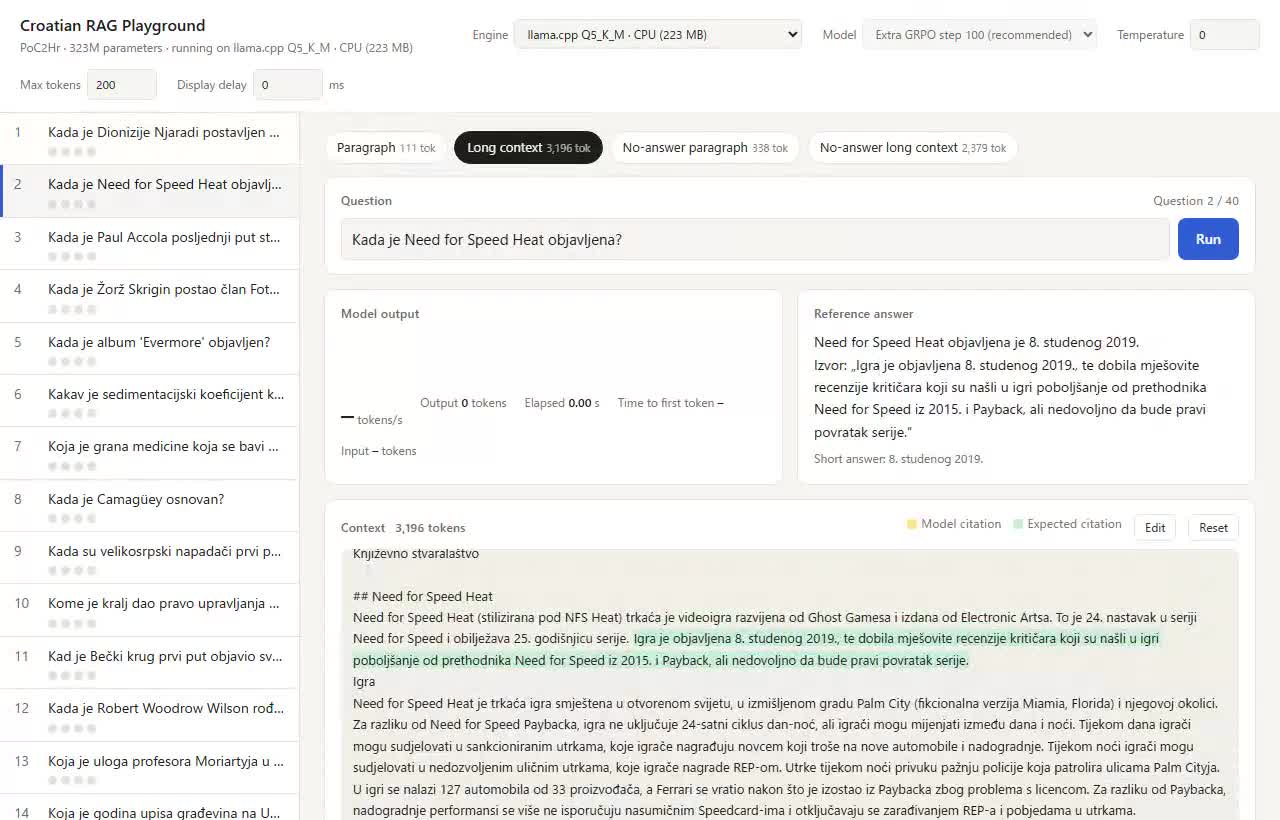
llama.cpp Q4_K_M (193MB)
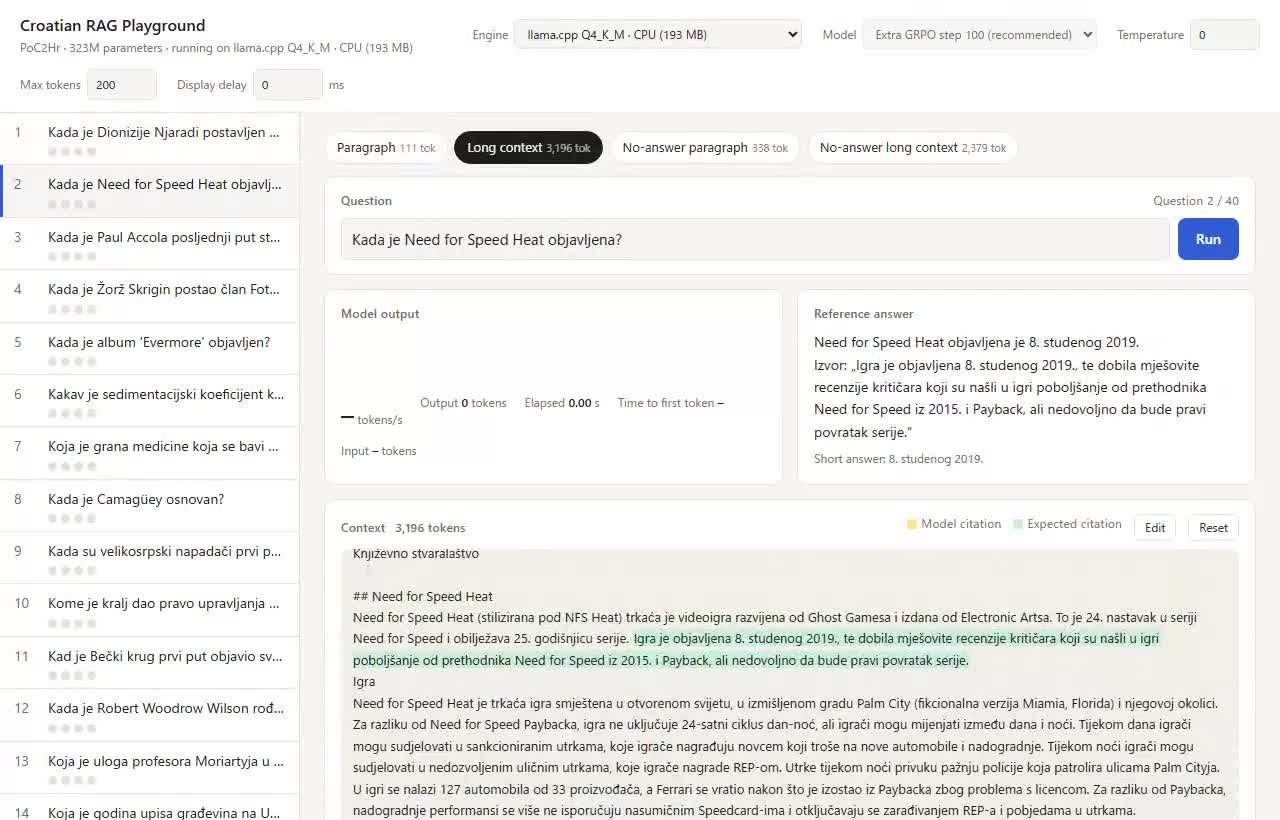
llama.cpp Q3_K_M (160MB)
llama.cpp Q2_K (129MB)
Considerações
- Para rodar este modelo na CPU, escolha Q6_K. Mantém a precisão original, ocupa 1/5 do tamanho e gera cerca de 5 vezes mais rápido que o PyTorch. Não há motivo para hesitar
- Para uma margem extra de segurança, escolha Q8_0. É praticamente igual ao original e tem 329 MB. Ainda é suficientemente pequeno
- Modelos pequenos, de 300 milhões de parâmetros, são frágeis à quantização. Dizem que modelos grandes quase não degradam mesmo em Q4, mas aqui a queda foi visível a partir de Q5. Como o modelo já não tem muita folga, reduzir os pesos faz diferença
- É bom que ele quebre recusando. Para RAG, recusar é mais seguro do que aumentar as alucinações. O efeito de ter ensinado a recusar com aprendizagem por reforço no artigo anterior também aparece aqui
- Nos modelos pequenos, a diferença de velocidade diminui. A partir de Q6_K, mesmo que a geração fique mais rápida, ainda resta o tempo para ler o texto; por isso, a percepção muda pouco. No vídeo, Q6_K a Q3_K_M ficaram todos na faixa dos 4 segundos
- Ainda não sei por que Q4_K_M perdeu para Q3_K_M. Quero investigar aumentando o número de perguntas e examinando quais camadas são quantizadas e como