Criei o GPT-2 do zero com uma única RTX 4090. Em um dia, superei o original e ainda o fiz conversar
Tentei treinar o GPT-2 (124M) do zero usando uma única RTX 4090 em casa. Fiz tudo no meu próprio PC: preparação dos dados, pré-treinamento e ajuste de instruções (SFT) para que ele pudesse conversar.
Para adiantar a conclusão, foi assim:
- O pré-treinamento foi concluído em cerca de 21 horas. Obteve 30,5% no HellaSwag, teste de raciocínio de senso comum — acima dos 29,4% do GPT-2 124M original
- O SFT levou pouco menos de 2 horas. Apenas 5 minutos após o início do treinamento, ele já começou a dar respostas parecidas com uma conversa
- Mas o conteúdo era cheio de alucinações. Dizia tranquilamente coisas como “a população de Paris é de 2,4 bilhões” e “12+7=30”
Foi divertido ver o GPT-2 ficando mais inteligente aos poucos, então resolvi registrar o processo.
Ambiente
- GPU: RTX 4090 (24 GB)
- CPU: i7-13700K / 64 GB de memória
- SO: Windows 11 (sem WSL; rodei diretamente no Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
O código segue a mesma abordagem do nanoGPT/build-nanogpt, do Karpathy. Pedi ao Claude Code para “criar um GPT-2 que desse para fazer em um dia com a GPU deste PC”, e ele me ajudou desde a proposta da estrutura até a criação dos scripts e o monitoramento do treinamento.
Preparação dos dados: 10B tokens prontos em 12 minutos
Os dados de treinamento foram a versão de 10B tokens do FineWeb-Edu (textos em inglês de alta qualidade voltados para educação na Web). São cerca de 27 GB em parquet.
No início, o download puro do Hugging Face ficava em apenas 1,7 MB/s, o que daria mais de 4 horas para baixar tudo. Depois de instalar hf_transfer, passou para 60–70 MB/s, e arquivos de 2 GB chegavam em 30 segundos. O gargalo passou a ser a tokenização e, somando download e tokenização, tudo ficou pronto em cerca de 12 minutos.
Aliás, no começo eu defini HF_HOME, para alterar o local do cache, depois de importar huggingface_hub. Por isso a configuração não teve efeito e os arquivos foram baixados para outro disco. Essa variável de ambiente é lida durante o import, então é preciso defini-la antes do import. É um detalhe fácil de tropeçar.
Configuração do treinamento
| Item | Conteúdo |
|---|---|
| Modelo | GPT-2 small (12 camadas, 768 dimensões, 124 milhões de parâmetros) |
| 1 etapa | Cerca de 520 mil tokens (16×1024, com acumulação de gradiente 32 vezes) |
| Número de etapas | 16.000 (cerca de 8,4B tokens) |
| Velocidade | Cerca de 120 mil tokens/s |
| VRAM | Cerca de 12 GB |
É comum ouvir que, no Windows, torch.compile não funciona e que seria preciso usar WSL, mas nesse ambiente com triton-windows ele funcionou diretamente.
Como usar todos os 10B tokens passaria de 24 horas, reduzi para 8,4B tokens para caber em um dia.
Como um pequeno truque, arredondei o tamanho do vocabulário de 50257 para 50304 (múltiplo de 128). É uma técnica conhecida do Karpathy para acelerar cálculos matriciais na GPU, e ela acabou ajudando de uma forma inesperada mais tarde, ao transformar o modelo em chatbot.
Incidente: o treinamento parou após 2,5 horas
Quando fui verificar o progresso, o treinamento tinha parado. A causa eram os dados de avaliação do HellaSwag. O código no estilo nanoGPT busca os dados no GitHub, em rowanz/hellaswag, mas o repositório passou a retornar “451 Unavailable For Legal Reasons” (indisponível por motivos legais). O erro 404 derrubava tanto a avaliação quanto o treinamento.
Corrigi para ler do Rowan/hellaswag no Hugging Face (as mesmas 10.042 perguntas) e retomei a partir de um checkpoint salvo a cada 500 etapas. Também envolvi a avaliação em try/except, para que uma falha nela não interrompesse o treinamento.
Em treinamentos longos, não deixe uma falha em algo “fora do núcleo”, como avaliação ou logs, derrubar o treinamento. Isso é importante.
Resultado: superei o GPT-2 original
A loss nos dados de validação ficou assim. Ela caiu muito na primeira hora e depois continuou caindo gradualmente.
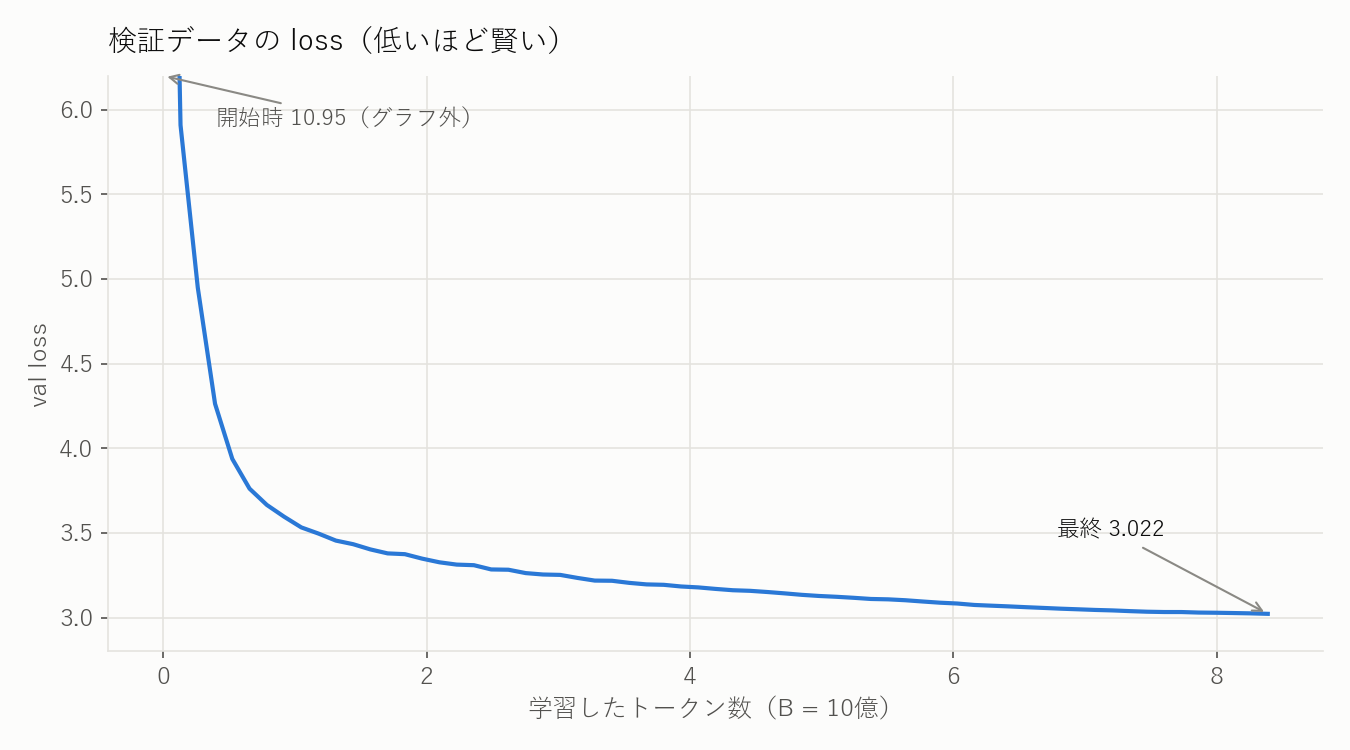
A loss inicial de 10,95 é quase igual a ln(50304)≒10,83. Em outras palavras, o modelo começou escolhendo completamente ao acaso entre 50 mil palavras.
A taxa de acerto no HellaSwag ficou assim.
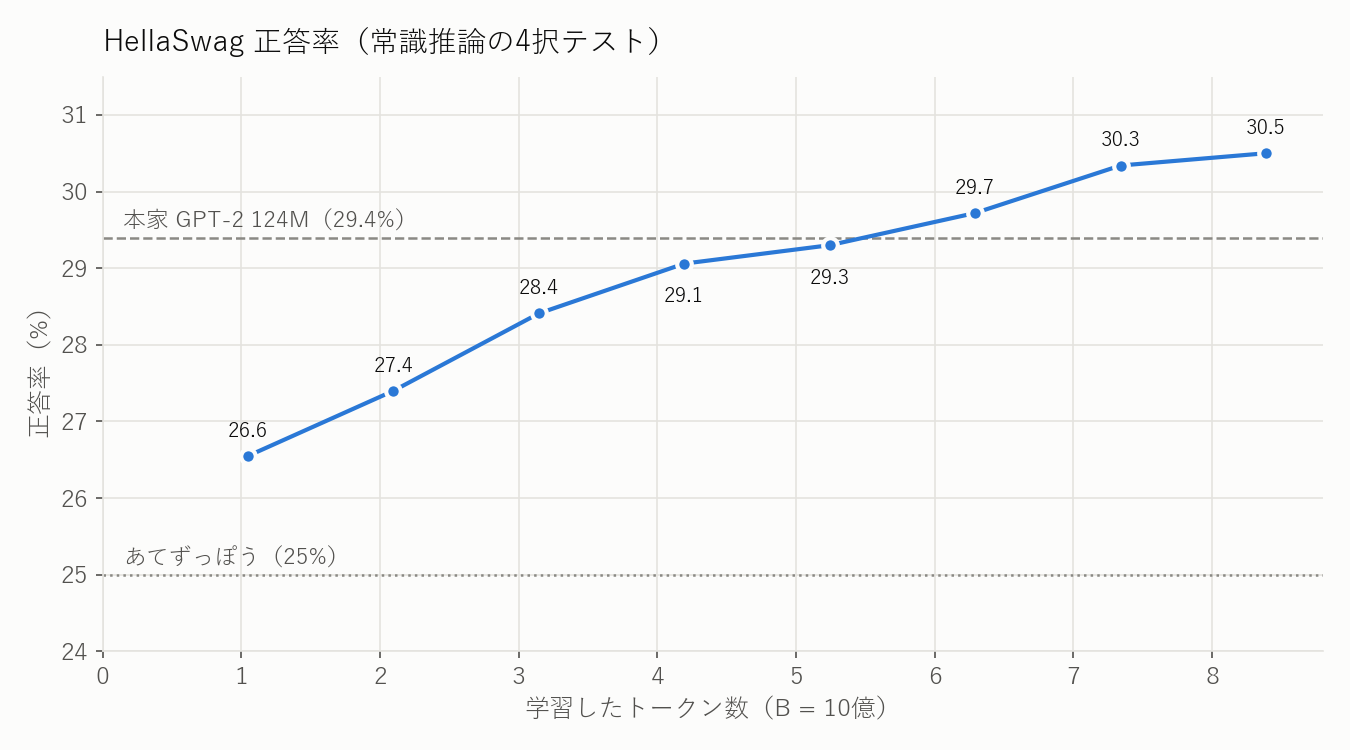
Com cerca de 6,3B tokens (etapa 12.000), ele superou os 29,4% do GPT-2 124M original e terminou em 30,5%. O GPT-2 original foi treinado com WebText. Este usou FineWeb-Edu, e acredito que a qualidade dos dados educacionais tenha feito diferença.
Vendo o modelo ficar mais inteligente aos poucos
Durante o treinamento, gerei e registrei texto com o mesmo prompt a cada hora. Essa foi a parte mais interessante.
Antes do treinamento (estado aleatório)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
As palavras estavam simplesmente dispostas de forma totalmente aleatória.
37 minutos depois (0,26B tokens)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Já tem forma de frase. Ele entende que é “sobre uma capital”, mas diz que a capital da França é a capital da Escócia.
Cerca de 2 horas depois (0,79B tokens)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
A gramática já ficou bastante natural. Em compensação, ele passou a empilhar termos técnicos e contar mentiras plausíveis. Parece o protótipo de uma alucinação.
Cerca de 2,1B tokens
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Finalmente conseguiu dizer Paris! …Mas, logo em seguida, acrescentou a falsa estatística de que “a França produz 50% do aço do mundo”.
Perguntei coisas ao modelo-base concluído
Fiz 10 perguntas no formato Question: ... Answer:.
- What is the capital of France? → Lista as opções de (a) a (i) e começa a criar uma prova
- Who was Albert Einstein? → “Nasceu em 16 de novembro de 1918, em St. Louis, Missouri. Seu pai era mineiro e ele próprio era professor.” Tudo mentira, mas ele consegue escrever no estilo de uma biografia
- What is 12 plus 7? → “12 plus 7 is an arithmetic expression.” Em vez de calcular, começa a explicar a definição
Ele tem algum conhecimento, mas não sabe se comportar como alguém que responde perguntas. O modelo-base é, no fim das contas, uma máquina de “escrever a continuação de um texto”, então isso é esperado.
Usei SFT para fazê-lo conversar
A partir daí, fiz um ajuste de instruções (SFT) para que ele pudesse responder perguntas como o ChatGPT.
- Dados:
smol-smoltalkdo Hugging Face (cerca de 460 mil conversas, 270 milhões de tokens) - Formato de chat: adicionei separadores como
<|user|>,<|assistant|>e<|end|>. Aqui reutilizei os IDs livres que sobraram quando arredondei o vocabulário para 50304. Assim, pude adicionar tokens especiais sem alterar a estrutura do modelo; o pequeno truque de desempenho acabou sendo útil aqui - Treinar apenas a parte da resposta: as perguntas são apenas lidas; o modelo imita somente a resposta do assistente e o
<|end|>final - 2 épocas, cerca de 1 hora e 50 minutos
O ponto importante é treinar até o <|end|>. Com isso, o modelo aprende a parar sozinho quando termina de falar. ChatGPT e outros modelos usam o mesmo mecanismo: a geração para quando o marcador de fim é emitido.
Em apenas 5 minutos, já parecia uma conversa
Antes de iniciar o SFT (etapa 0), ele se confundia com os marcadores desconhecidos e entrava num loop infinito de “jakjakjakjak…”. Mas, em 500 etapas (cerca de 5 minutos), já ficou com cara de conversa.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
E ele realmente termina e para. Aprender o jeito de falar foi instantâneo.
Mas o conhecimento continuou igual. Um modelo intermediário dizia que Paris era a maior cidade do mundo e tinha cerca de 2,4 bilhões de habitantes.
Comparando antes e depois do SFT
Comparei o antes (modelo-base) e o depois do SFT usando as mesmas perguntas.
| Pergunta | Antes do SFT | Depois do SFT |
|---|---|---|
| What is the capital of France? | Começa a listar opções de (a) a (i) | “The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.” |
| Who are you? | “I am the person who has the gift for all that I do.” | “I'm a language learning AI assistant with over 10 years of experience” (uma IA com 10 anos de experiência) |
| Translate "Good morning" into French. | Começa a falar de algo sem relação com a pergunta | “Bonjour!” (correto, mas depois repete “Good morning (modifier)” sem parar) |
| What is 12 plus 7? | “é uma expressão aritmética” | “12 + 7 = 21” → “12 + 7 = 30” → “35 + 7 = 34”: erra cada vez mais, com um método que parece convincente |
| Who was Albert Einstein? | Um professor cujo pai era mineiro | Acerta o geral com “prominent physicist”. Mas “nascido em Viena em 24 de fevereiro de 1905” é mentira |
O tom e o formato são totalmente de assistente. O conteúdo tem muitas mentiras. A capacidade de cálculo foi catastrófica.
Conversando de verdade com ele
Criei um chat.py para conversar pelo terminal e comecei a falar com ele.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Ele consegue seguir a instrução “em uma frase”. Isso era algo que o modelo-base não conseguia fazer.
Em outra conversa, depois de perguntar a capital, perguntei em seguida sobre a população.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Ele entende que “there” significa Japão com base na conversa anterior. Mas, logo depois de dizer que a população é de 50 mil pessoas, afirma que 1,5 bilhão vive no norte do país — um completo caos.
Quando perguntei em japonês “Qual é a capital do Japão?”, ele respondeu assim:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Como ele foi treinado apenas com dados em inglês, aparentemente interpretou o japonês como um texto misterioso que eu queria revisar.
Por fim, pedi para escrever um haiku sobre GPU e ele fez um poema que repetia sem parar “I see the world, the thoughts, the emotions”. Haiku, cadê você?
O que aprendi com isso
- Com uma única 4090 e um dia, dá para criar um modelo melhor que o GPT-2 original. A GPU consumiu cerca de 430 W. O custo de eletricidade, só da GPU, ficou aproximadamente em 300 ienes (estimativa)
- O jeito de falar é aprendido instantaneamente, mas o conhecimento é definido no pré-treinamento. O SFT transformou o modelo em conversacional em 5 minutos, mas quase não mudou a precisão factual
- Um modelo de 124M tem gramática quase perfeita, mas mente o tempo todo. Ficou muito claro, na prática, que fluência e correção são coisas diferentes
- Treinamentos longos falham do lado da infraestrutura. Desta vez, o problema não foi o modelo, mas o desaparecimento do local onde estavam os dados de avaliação
Quando você cria tudo do zero, entende na prática que uma IA como o ChatGPT é uma máquina de prever a continuação de textos à qual foram ensinadas as “boas maneiras” de uma conversa. Da próxima vez, quero tentar criar um modelo um pouco mais voltado para uso prático.