Notícias de IA de Geração de Imagens e Vídeos — 2026-09-18
O lado proprietário está sendo dominado pela geração de imagens Nano Banana do Google, que se consolidou no uso pessoal, enquanto o Sora 2 perde força com o fim da API em 24/9. No código aberto, MiniMax-H3 e Qwen-Image dominam a comunidade ComfyUI.
Resumo das notícias de IA para geração de imagens e vídeos — 2026-09-18
Nossa, esta edição veio recheadíssima🔥 Em resumo: no lado proprietário, a família Nano Banana do Google (geração de imagens do Gemini) é completamente a protagonista, enquanto o Sora 2, com o fim do app e da API (24/9), já começa a passar uma sensação de coisa do passado🤖📉. No código aberto, MiniMax-H3 (geração de vídeo) e Qwen-Image (geração de imagens) formam uma dupla dominante; em especial, a comunidade ComfyUI estava tomada por conversas sobre o MiniMax-H3😳. Outra descoberta importante: temas de ética e direito, como a legalização de gerações sem consentimento e o processo Disney contra Midjourney, estão repercutindo mais do que comparações de desempenho entre ferramentas⚖️🔥. Nesta rodada, o X (antigo Twitter) foi um completo fracasso de coleta, então vou registrar honestamente: “sem dados”🙏
Entre plataformas
Aqui estão apenas os assuntos que puderam ser verificados em múltiplas plataformas📝✨
- 🍌 Nano Banana (geração de imagens do Gemini) está se tornando uma ferramenta cotidiana para criadores individuais. No Bluesky, usuários como dfl e triflingtree publicam diariamente trabalhos feitos com Nano Banana 2 (https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i); no YouTube, o “Ultimate Nano Banana Pro Guide 2026” vem recebendo muitas visualizações em canais com 327 mil inscritos (canais do tipo https://www.youtube.com/watch?v=Q7SiipUCjro). Nano Banana também foi citado como modelo a integrar em uma discussão do Riverside no Reddit (https://www.reddit.com/r/RiversideFM/comments/1wiweik/).
- 🌊 Sora 2 está deixando de ser “o próximo grande passo” para se tornar algo em retrospectiva. No Bluesky, há postagens aconselhando migrar para Runway/Kling/Veo porque o app independente será encerrado (https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l); no YouTube, ele passou a servir mais como referência em vídeos do tipo “State of AI Video” do que como assunto de novidades. O encerramento da API está previsto para 2026-09-24. É exatamente o momento em que a maré está virando😮
- 🧩 No lado proprietário, a estratégia de “plataformas integradas” está virando o padrão. O mesmo movimento apareceu no Reddit — Adobe Firefly Boards e Riverside oferecem vários modelos — e no Pinterest, com muitos infográficos comparando Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut. Em vez de apostar em um único modelo, entramos na era de “deixar o usuário escolher”🛠️
- 🐉 As estrelas do código aberto são MiniMax-H3 e Qwen-Image. Comunidades de ComfyUI no Lemmy ficaram praticamente tomadas, no início e meados de setembro, por ferramentas do ecossistema MiniMax-H3 (ex.: https://github.com/filliptm/ComfyUI-FL-MiniMaxH3 , score 5). Segundo relatos de usuários, ele roda localmente até em máquinas do nível de uma RTX 3090 (comentário com score 12). Qwen-Image foi citado tanto no YouTube — incluindo um vídeo de benchmark com 700 gerações — quanto no Bluesky, na prévia do Qwen3.8-Flash: https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s.
- ⚖️ Temas de ética e direito estão viralizando mais do que tecnologia. Reddit — debate sobre legalizar geração de IA sem consentimento, com quase 900 comentários no total: https://www.reddit.com/r/CriticalState/comments/1wisk2n/ —, Bluesky — novidades no processo Disney contra Midjourney: https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n —, Lemmy — a pivô da Midjourney, de geração de imagens para dispositivos médicos, recebendo comparações com Theranos: https://awful.systems/post/8731127 — e Pinterest — pins sobre o acordo de direitos autorais entre ByteDance e Hollywood. Em quatro plataformas, os tópicos jurídicos e éticos foram os mais quentes.
- 😤 A rejeição ao “AI slop” continua forte de forma consistente. O Reddit, em r/aitubers, reagiu fortemente contra vídeos sem rosto totalmente automatizados a partir de roteiro; e o Lemmy, em r/fuck_ai, teve uma postagem de score 63 dizendo que empresas tornam a IA pior. Não há elogio irrestrito em lugar nenhum.
Plataforma por plataforma
Reddit — Como o termo de busca era único, subreddits especializados em geração de imagens, como r/StableDiffusion, não foram encontrados. Em vez disso, discussões de ética e cultura — uso indevido de imagens de IA pelo DHS e a controvérsia sobre legalização de geração sem consentimento — concentraram o engajamento. As opiniões sobre ferramentas isoladas, como Google Flow, Wan e Minimax, ficaram divididas; não havia clima de “esta é claramente a melhor”😐
X — Aqui, sinceramente, foi um fracasso total🙅♂️. As 40 postagens coletadas eram todas sobre política, apostas esportivas ou criptomoedas; não havia sequer uma sobre IA de geração de imagem ou vídeo. Parece que a consulta capturou tendências do X — Africa, Serbia, Zcash e afins — em vez de temas de IA. Como uma das seis plataformas definidas no briefing simplesmente não funcionou, isso fica registrado como uma lacuna real.
YouTube — No lado proprietário, surgem novidades em ritmo semanal. ChatGPT Images 2.5 da OpenAI, lançado em 8/9, e Nano Banana Pro/2 do Google receberam rapidamente reviews de canais médios, com 30 mil a 330 mil inscritos, e viralizaram. No código aberto, a cobertura está centrada em canais técnicos como SECourses e em explicações japonesas sobre Qwen-Image; as visualizações são cerca de um décimo das do conteúdo proprietário. Também chama atenção que o Seedance 2.0/2.5 da ByteDance tenha sido o modelo de vídeo mais abordado do ano📹
Bluesky — Enquanto criadores individuais publicam diariamente trabalhos com Nano Banana 2, também apareceram, por meio de bots de notícias, LTX-2.5 da Lightricks, LoRAs de FLUX e modelos totalmente abertos lançados em Abu Dhabi. Porém, buscas por expressões como “Stable Diffusion”, “Wan 2.5” e “Qwen Image” receberam repetidamente erro 403 na API, deixando a coleta de relatos diretos sobre geração de vídeo de código aberto mais fraca😑
Lemmy — A melhor plataforma desta rodada🎯. !«メールアドレス» estava tomada por extensões ComfyUI relacionadas ao MiniMax-H3, tornando-se o lugar que mostrou com mais densidade o estado atual da geração de vídeo de código aberto. Já no lado proprietário, chamaram atenção notícias de “desorientação”, como a pivô da Midjourney para dispositivos médicos. O tom geral do Lemmy é bastante cético.
Pinterest — Na pesquisa visual pré-coletada pelo worker, proliferaram infográficos de SEO e afiliados que colocam lado a lado Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut🖼️. Conteúdos de letramento do tipo “distingua o real da IA” também se consolidaram como um gênero próprio. O código aberto teve presença bem menor: Stable Video Diffusion aparece basicamente como um logotipo em listas de ferramentas.
O que observar
- 🔥 Expansão do ecossistema ComfyUI do MiniMax-H3 — Lemmy, https://github.com/filliptm/ComfyUI-FL-MiniMaxH3
- 📉 Fim da API do Sora 2 (previsto para 2026-09-24) e destino dos usuários — Bluesky, https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l
- 🍌 A consolidação do Nano Banana Pro/geração de imagens Gemini entre criadores individuais — Bluesky, https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i
- 🎬 A presença do ByteDance Seedance 2.0/2.5 na geração de vídeo e seu acordo de direitos autorais com Hollywood — YouTube (tutorial de Dan Kieft) e pin ByteDance-MPA no Pinterest
- ⚖️ O rumo do debate sobre legalização da geração de IA sem consentimento — Reddit, https://www.reddit.com/r/CriticalState/comments/1wisk2n/
- 🐦⬛ Crescimento da presença do Qwen-Image entre modelos de pesos abertos — YouTube (vídeos de benchmark com 700 gerações) e postagem Qwen3.8-Flash no Bluesky
Recomendações
- Na próxima coleta do X, buscar novamente com termos diretamente ligados a IA, como Sora, Nano Banana, Kling, Qwen, Flux e ComfyUI; desta vez foram capturadas tendências inteiramente irrelevantes.
- Continuar acompanhando MiniMax-H3 e Qwen-Image como os indicadores mais quentes do momento entre os projetos de código aberto.
- Acompanhar, antes e depois do fim da API do Sora 2 em 24/9, como se movem os destinos de migração dos usuários: Runway, Kling e Veo.
- Dar prioridade maior ao acompanhamento jurídico e ético — processo Disney contra Midjourney e debate sobre legalização de geração sem consentimento — do que às comparações de desempenho entre ferramentas.
- Acrescentar à coleta do Reddit consultas voltadas a subreddits especializados em geração de imagens, como r/StableDiffusion e r/aiArt.
- Como o Pinterest se baseou apenas em inferências a partir de imagens, abrir de fato os artigos vinculados e verificá-los ao vivo na próxima rodada.
Qualidade dos dados
No X (antigo Twitter), todas as 40 postagens coletadas eram irrelevantes para o tema; na prática, não há dados. No Reddit, a busca com um único termo deixou escapar comunidades especializadas em geração de imagens, e 5 das 12 threads coletadas tiveram score 0pt, indicando baixa reação. No YouTube, 401/CAPTCHA impediram verificar cerca de dois terços das informações, e muitas contagens de visualizações de vídeos de código aberto não foram confirmadas. No Bluesky, a API pública recusou repetidamente buscas por frases com 403, impedindo obter dados diretos sobre “Stable Diffusion”, “Wan 2.5” e afins. No Lemmy, foram cobertas apenas postagens indexadas em lemmy.world; outras instâncias, como lemmy.ml, não foram pesquisadas. O Pinterest se baseia exclusivamente em imagens pré-coletadas pelo worker, sem qualquer verificação ao vivo.
Resumo por plataforma
Reddit — Notícias de IA de Geração de Imagens e Vídeos
Onde
Foram coletadas 12 threads em 11 subreddits usando o termo de busca “Image and Video Generation AI News”.
| Subreddit | Número de membros | Threads coletadas |
|---|---|---|
| r/generativeAI | 154,407 | 1 |
| r/CriticalState | 35,134 | 2 |
| r/aifilmmaking | 8,038 | 1 |
| r/aitubers | 28,687 | 1 |
| r/agi | 123,187 | 1 |
| r/AIToolTalks | 6,513 | 1 |
| r/ContentCreators | 88,168 | 1 |
| r/AIContentAutomators | 9,387 | 1 |
| r/AIDangers | 53,842 | 1 |
| r/popculturechat | 6,680,224 | 1 |
| r/RiversideFM | 728 | 1 |
Grandes subreddits especializados em geração de imagens, como r/StableDiffusion e r/aiArt, não apareceram. Esta busca ficou concentrada em subreddits de ferramentas de IA, cultura e debates éticos.
O que as pessoas dizem
- Thread 1(r/generativeAI・13pt・41 comentários・2026-09-16)https://www.reddit.com/r/generativeAI/comments/1whtesl/ — Em resposta a “Quais ferramentas gratuitas de geração de vídeo por IA existem?”, u/RioMetal disse: “Se você consegue rodar localmente, há uma porção de Wan e Minimax”; u/juzellicious respondeu que Wan oferece apenas 3 segundos gratuitos por dia e que o Google Veo 3 ainda oferecia mais. Discute-se a redução das cotas gratuitas na nuvem e um retorno a modelos locais/de código aberto.
- Thread 3(r/aifilmmaking・7pt・7 comentários・2026-09-14)https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — Postagem diz que os créditos gratuitos do Google Flow estão “bem generosos agora”. u/MechanicForward2274 afirma que 50 créditos por dia permitem experimentar bastante sem desperdício. Já u/Sea-Temporary-6995 diz que ele é fraco em física e lógica, e que Minimax é muito melhor; as avaliações se dividem.
- Thread 8(r/ContentCreators・0pt・6 comentários・2026-09-17)https://www.reddit.com/r/ContentCreators/comments/1wj380j/ — Relato de criação de um comercial de beleza para especificações usando Adobe Firefly Boards. A pessoa diz explicitamente que escolheu Firefly Video, e não Veo ou Kling, pela segurança de uso comercial. u/avatar0027 observa que os closes são bonitos, mas a continuidade entre cortes ainda parece IA.
- Thread 12(r/RiversideFM・0pt・1 comentário・2026-09-17)https://www.reddit.com/r/RiversideFM/comments/1wiweik/ — A ferramenta de produção de podcasts Riverside lançou recursos de geração de imagens e vídeos integrando vários modelos, como Seedance 2.5, Veo 3.1 e Nano Banana. Todos os planos pagos receberam 2.000 créditos.
- Thread 4(r/aitubers・0pt・40 comentários・2026-09-14)https://www.reddit.com/r/aitubers/comments/1wg3duk/ — Uma postagem pedindo criação totalmente automática de vídeos sem rosto para YouTube a partir de um roteiro recebeu forte rejeição. u/RobJames007 disse que o YouTube tenta reduzir AI slop e a pessoa está procurando ferramentas para aumentar isso; u/-NearlyThere- afirmou que denunciaria e daria dislike se encontrasse.
- Thread 9(r/AIContentAutomators・0pt・11 comentários・2026-09-11)https://www.reddit.com/r/AIContentAutomators/comments/1wdm1n4/ — Alega-se que créditos gratuitos de US$ 300 para novas contas Google reduziram custos de vídeo com IA e permitiram faturar US$ 5.000 por mês. O comentário mais votado, de u/Truegentlehat, questiona a confiabilidade: uma hora antes, a mesma pessoa teria dito em outra postagem que só começara a lucrar com €120 por mês.
- Threads 2 e 5(r/CriticalState・0pt/1pt・421/475 comentários・2026-09-17)https://www.reddit.com/r/CriticalState/comments/1wisk2n/ , https://www.reddit.com/r/CriticalState/comments/1wiwhm4/ — Duas threads em formato de enquete perguntando se a geração de imagens de IA sem consentimento deveria ser legalizada ou proibida. Em ambas, os comentários mais votados defenderam a proibição. u/AwarenessOk7862 afirmou que isso falsifica a realidade e torna ainda mais difícil distinguir verdade de ficção.
- Thread 11(r/popculturechat・448pt・22 comentários・2026-09-11)https://www.reddit.com/r/popculturechat/comments/1wd49kb/ — O Departamento de Segurança Interna dos EUA (DHS) usou uma imagem de Optimus Prime gerada por IA em propaganda de campanha de deportação, levando a Hasbro a responder. u/Jerkrollatex comentou que Optimus também era um personagem refugiado de guerra e perguntou se os criadores pareciam humanos que acabaram de chegar à Terra.
- Thread 7(r/AIToolTalks・12pt・35 comentários・2026-09-13)https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — Postagem expressa ansiedade sobre IA em geral, incluindo consumo de água e perda de empregos, em um contexto que abrange geração de imagens e vídeos. u/EstablishmentRare276 rebateu dizendo que data centers existem desde os anos 1950 e que um vídeo de duas horas no YouTube equivale a 50 solicitações pesadas de IA.
- Thread 10(r/AIDangers・28pt・31 comentários・2026-09-14)https://www.reddit.com/r/AIDangers/comments/1wg5y17/ — Defende que IA não é uma ferramenta indispensável e que muitas empresas experimentaram piora, não melhora, de desempenho. u/LopsidedSolution observou que a pesquisa aparentemente usava modelos de 2024, como GPT-4o, e pediu uma reavaliação com Astra ou Fable.
Sinais
- Tendência de alta: atenção a modelos locais/de código aberto de geração de vídeo, como Wan e Minimax. A redução de cotas gratuitas na nuvem, vista na thread 1, está levando usuários a executar modelos por conta própria para evitar custos.
- Tendência de alta: ferramentas de fluxo de trabalho que integram múltiplos modelos. Adobe Firefly Boards (thread 8) e Riverside (thread 12) permitem escolher, como modelos parceiros numa única plataforma, entre Veo, Kling, Seedance, Nano Banana e outros.
- Forte rejeição: automação de vídeos sem rosto, do tipo “entregar um roteiro e gerar tudo automaticamente”, é constantemente tratada como “slop” e alvo de denúncias em r/aitubers e r/ContentCreators. Relatos de ganhos, como o da thread 9, também são vistos como propaganda ou exagero.
- Divisões em evidência: as avaliações práticas de Google Flow e de IA em geral estão divididas. Na thread 3, há quem diga que Minimax é melhor; na thread 10, há discordância até sobre ganhos de desempenho empresarial. Comentários de profissionais não se encaixam nem em puro entusiasmo nem em rejeição total.
- Surpresa: discussões éticas e políticas — legalização de geração sem consentimento nas threads 2 e 5, com quase 900 comentários juntas, e o uso indevido de imagem de IA pelo DHS na thread 11, com 448pt — tiveram engajamento muito maior que debates de desempenho técnico. Threads de comparação de ferramentas ficaram em scores baixos, entre 0 e 13pt.
Limites
- Todas as buscas no Reddit desta rodada usaram o único termo “Image and Video Generation AI News”. Não houve consultas separando “open source” e “closed source”, nem buscas por nomes de modelos como Stable Diffusion, ComfyUI ou Flux. Por isso, nenhum subreddit importante especializado em imagens — r/StableDiffusion, r/aiArt e outros — entrou na coleta.
- Cinco das 12 threads coletadas têm score 0pt, incluindo uma quantidade relevante de discussões com pouca reação da comunidade. As vozes de subreddits pequenos, como r/RiversideFM com 728 membros e r/AIToolTalks com 6.513, devem ser vistas como amostras limitadas.
- Por restrições do playbook, este agente não navegou diretamente no Reddit; trabalhou apenas com as 12 threads previamente coletadas pelo worker. Assim, não entram informações fora desse conjunto, como postagens das últimas horas ou threads relacionadas que não correspondiam ao termo de busca.
- O período de coleta cobre aproximadamente uma semana, de 2026-09-11 a 2026-09-17, sem visibilidade sobre a evolução das discussões anteriores.
X
X — Notícias de IA de Geração de Imagens e Vídeos
Contas
As 40 postagens coletadas vêm de 39 contas distintas (output/x.posts.md), e nenhuma está associada a IA de geração de imagens ou vídeos — não aparecem Midjourney, OpenAI/Sora, Runway, Stability AI, Black Forest Labs, ByteDance/Kling, Pika, Luma ou perfis semelhantes. As contas são uma mistura de comentários políticos (@GunterFehlinger, @AntiTrumpCanada, @Rusia_HD), tipsters de apostas esportivas (@BDreamz37398, @thekasik, @TheRealCEOAmber), promoção de cripto/NFT (@Hasan_NFTOX, @0xHeatt, @jubjubcommunity, @patlandcrypto, @AltcoinSherpa) e contas de comentários gerais/memes (@Keegan59992745, @LeeLovesBey, @Captian_Loden_4). Nenhuma publica sobre geração de imagem ou vídeo por IA, e nenhuma é um motor de destaque sobre o tema, pois não houve atividade relevante.
Postagens
Sem resultados: nenhuma das 40 postagens coletadas trata de IA de geração de imagens ou vídeos, proprietária ou aberta. A leitura integral das postagens e seus textos em relação ao briefing encontrou zero itens relevantes. Exemplos representativos fora do tema: #1 (https://x.com/TicTocTick/status/2100319322682134729, 16,936 likes, “Xi of China and Ramaphosa of Africa suffered from ischemic stroke...”), #35 (https://x.com/GunterFehlinger/status/2100099276672040971, 13,824 likes, “Russia is collapsing in Donbas”) e #38 (https://x.com/Keegan59992745/status/2100583905204326909, 159,030 likes, uma piada sobre burrito/Israel) — as três postagens de maior engajamento, todas sem relação com IA.
Sinais
Não há nada a relatar sobre tendências de IA de geração de imagens e vídeos proprietária ou de código aberto no X nesta rodada. O único padrão observável está nos próprios termos de busca: “Africa”, “Serbia”, “Zcash”, “Germany”, “$JubJub”, “Canada”, “Zagreb”, “#CyberSecurity”, “Russia”, “Israel”. Eles parecem ser temas do Trending/Explore do X para a sessão, localizado na Croácia, conforme output/x.posts.md, e não termos relacionados ao briefing. A etapa de coleta pesquisou tendências do X em vez do tema de IA de imagem e vídeo.
Limites
- Os dados coletados não respondem ao briefing desta rodada.
output/x.posts.mdeoutput/x.posts.jsoncontêm 40 postagens encontradas por buscas de “Africa”, “Serbia”, “Zcash”, “Germany”, “$JubJub”, “Canada”, “Zagreb”, “#CyberSecurity”, “Russia” e “Israel”: conteúdo político, de apostas esportivas e cripto, coerente com a lista de tendências Explore geolocalizada na Croácia, e não com o tema “Image and Video Generation AI News”. - Pelo playbook, esta etapa não navega diretamente no X, pois leituras anônimas não retornam conteúdo; trabalha somente com o que o worker já coletou. Nenhum termo corresponde a IA de imagem ou vídeo proprietária ou aberta — Sora, Veo, Midjourney, Runway, Kling, Stable Diffusion, Flux, ComfyUI, LoRA, Nano Banana e similares —, portanto não há como responder ao briefing com este arquivo. É necessária nova coleta com termos do tema real.
- Como não foi usado nenhum termo relevante ao briefing, não é possível afirmar o que o X está ou não dizendo sobre IA de geração de imagens e vídeos nesta rodada.
YouTube
YouTube — Notícias de IA de Geração de Imagens e Vídeos
Canais
- Paul J Lipsky — reviewer geral de ferramentas de IA; cobriu “ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun)” e alcançou 277 mil visualizações em 9 dias (assistir).
- Kevin Stratvert — grande canal mainstream de tutoriais de tecnologia; “ChatGPT Images 2.5 Tutorial for Beginners” alcançou 58 mil visualizações em 1 dia.
- AI Master — 327 mil inscritos; “Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI”, 76.658 visualizações desde 17 de janeiro de 2026.
- JohnnyTube — 30,6 mil inscritos; “Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course)”, 26.162 visualizações desde 6 de março de 2026.
- AffContent — 262 mil inscritos; conteúdo de comparação/afiliados, como “BEST AI Image Generator in 2026 (Don't Choose Wrong!)”, 14.694 visualizações desde 9 de abril de 2026.
- Dan Kieft — 295 mil inscritos, com foco em cinema com IA; “Seedance 2.0 is CRAZY for AI Filmmaking - Full Course”, 179.589 visualizações desde 24 de abril de 2026 — seu upload recente de maior desempenho em relação à faixa habitual, a julgar pelo número de inscritos.
- SECourses — 53,7 mil inscritos, tutoriais densos sobre ComfyUI local/de código aberto; “Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models”, 6.649 visualizações, publicado em 18 de agosto de 2025 — fora da janela de 60 dias, mantido apenas como contexto de um canal técnico de código aberto ativo.
- Canais menores ou de cauda longa que aparecem repetidamente em buscas por Qwen-Image e Wan, somente por título e sem métricas confirmadas: canais japoneses de ferramentas de IA cobrindo “Qwen-Image完全ガイド” e tutoriais de “Qwen-Image-2512”, além de canais em inglês com “ComfyUI Text-to-Image Models Compared (Local): Qwen 2512, Z-Image, FLUX.2 klein, Ovis, LongCat”.
Vídeos
- “ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun)” — Paul J Lipsky, cerca de 9 dias, 277 mil visualizações. https://www.youtube.com/watch?v=Q7SiipUCjro — Reage ao lançamento, em 8 de setembro de 2026, do ChatGPT Images 2.5 da OpenAI, com rascunho para imagem, cerca de 50% menos latência e modelos de API Flare/Sunburst; destaca a consistência de identidade como a principal melhoria.
- “ChatGPT Images 2.5 Tutorial for Beginners” — Kevin Stratvert, cerca de 1 dia, 58 mil visualizações. Mostra a um público mainstream o novo recurso de rascunho e a edição em múltiplas etapas que finalmente preserva o contexto entre edições.
- “Everyone's Lying to You About GPT Image 2.5” — Joseph Martin, cerca de 2 dias, 10 mil visualizações. Visão contrária, argumentando que o “salto” está mais em velocidade/latência do que em qualidade bruta de imagem frente ao GPT-Image-1.
- “Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI” — AI Master, desde 17 de janeiro de 2026, 76.658 visualizações. Guia de estrutura de prompt em seis partes — Assunto+Ação+Ambiente+Estilo artístico+Iluminação+Detalhes — para o Gemini 3 Pro Image do Google, voltado a marcas e fotos de produtos.
- “Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course)” — JohnnyTube, desde 6 de março de 2026, 26.162 visualizações. Apresenta Nano Banana Pro 2 como gerador de imagens e vídeos em uma única ferramenta, comparado informalmente com Midjourney, Flux, Sora 2 e Veo 3.1.
- “BEST AI Image Generator in 2026 (Don't Choose Wrong!)” — AffContent, desde 9 de abril de 2026, 14.694 visualizações. Panorama amplo, em estilo afiliado, comparando geradores proprietários gratuitos e pagos.
- “Seedance 2.0 is CRAZY for AI Filmmaking - Full Course” — Dan Kieft, desde 24 de abril de 2026, 179.589 visualizações. Destaca o Seedance 2.0 da ByteDance pela qualidade de sequências de ação, aderência a prompts e consistência visual, com limitações observadas; é o vídeo Seedance de maior tração encontrado, comparado a vários uploads do mesmo tema por outros criadores naquela semana.
- “State of AI Video in 2026: Sora 2, Veo 3.1, Kling 3.0 & Cinematic Prompting Workflows” — @StarnationsAI, estreou em 20 de março de 2026, 177 visualizações / cerca de 1 mil inscritos. Exemplo de baixa tração, incluído para mostrar que o formato de vídeo comparativo existe até em canais pequenos; a descrição é majoritariamente conteúdo de treinamento corporativo pouco relacionado, preenchido com palavras-chave de vídeo com IA.
- “Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models” — SECourses, 6.649 visualizações, 18 de agosto de 2025 — fora da janela de 60 dias, mas o ponto de dados mais claro encontrado sobre código aberto. Teste de uma semana de configurações predefinidas para Wan 2.2, FLUX e Qwen-Image, incluindo downloads, presets, upscaling e treinamento/fine-tuning.
- Grupo de títulos de código aberto com métricas não verificadas, encontrados na busca, mas não confirmados por acesso às páginas — o YouTube bloqueou repetidas buscas de metadados, veja Limites: “Qwen-Image完全ガイド|ポスター作成から画像編集まで5分で終わらせる方法”, “【徹底解説】最強オープンソース『Qwen-Image-2512』”, “ComfyUI Text-to-Image Models Compared (Local): Qwen 2512, Z-Image, FLUX.2 klein, Ovis, LongCat” e “Qwen Image Dominates Text-to-Image: 700+ Tests Reveal Why It's Better Than FLUX.”
Sinais
- O ritmo do lado proprietário é semanal neste momento. A OpenAI lançou ChatGPT Images 2.5 em 8 de setembro de 2026 e o Google lançou Nano Banana 2, Gemini 3.1 Flash Image com 4K, em 26 de fevereiro de 2026. Cada lançamento provocou uma onda de tutoriais e reações na mesma semana, em canais de 30 mil a 330 mil inscritos, com dezenas de milhares de visualizações em poucos dias.
- Seedance 2.0 da ByteDance, lançado em 10 de fevereiro de 2026, é o modelo de vídeo mais coberto no YouTube neste ano. Uma busca simples pelo título encontrou mais de 10 tutoriais/reviews dedicados entre fevereiro e junho de 2026, mais do que para Sora 2, Veo 3.1 ou Kling 3.0 individualmente. O melhor vídeo encontrado, de Dan Kieft, com 179,6 mil visualizações, supera em cerca de duas vezes os tutoriais líderes de imagens proprietárias.
- A conversa sobre Sora 2 no YouTube é hoje retrospectiva, não prospectiva: os resultados privilegiam comparativos sobre o estado do vídeo por IA, não tutoriais de recursos novos. Isso é coerente com o encerramento confirmado do app de consumo em 26 de abril de 2026 e com a descontinuação da API em 24 de setembro de 2026: Sora 2 está se tornando a linha de base que outros modelos superam, não a ferramenta a aprender.
- A cobertura de código aberto tende a canais técnicos densos, no estilo SECourses, e aprofundamentos japoneses sobre Qwen-Image, em vez do formato de vídeos comparativos amplos que domina o conteúdo proprietário. As visualizações do único vídeo aberto confirmado, 6.649, são uma ordem de grandeza abaixo dos líderes proprietários, sugerindo audiência menor, porém mais técnica.
- Qwen-Image, da Alibaba, é o modelo de pesos abertos que recebe maior atenção em vídeos, tanto em um benchmark em inglês de 700 gerações contra FLUX como em vários vídeos japoneses sobre o checkpoint Qwen-Image-2512, descrito como “impossível distinguir de IA agora”.
Limites
- As páginas de resultados de busca do YouTube (
/results?search_query=...) e a maioria das páginas individuais/watchretornaram repetidamente bloqueios 401/CAPTCHA ao tentar obter metadados estruturados. Esta rodada usou um proxy leitor de HTML, pois a página de busca do YouTube é renderizada em JavaScript e uma requisição simples não enxerga seu conteúdo. Aproximadamente uma em cada três tentativas funcionou; as demais foram descartadas ou relatadas apenas com título/data extraídos de snippets de busca. - Por causa desses bloqueios, vários vídeos relevantes de código aberto — aprofundamentos sobre Qwen-Image-2512, comparação ComfyUI de Ovis/LongCat/Z-Image e Qwen-Image-Edit-Rapid-AIO — não puderam ter suas visualizações, inscritos ou descrições confirmados; estão listados apenas por título, com essa ressalva.
- Não foi possível recuperar comentários principais de nenhum vídeo; os mesmos bloqueios impediram ler a seção de comentários.
- Não foi possível confirmar contagens exatas de visualizações de vídeos comparativos gerais de Sora 2, Veo 3.1 e Kling 3.0 além do exemplo de baixa tração do StarnationsAI. Diversos títulos foram encontrados, como comparativos de Kling 2.6 Pro contra Veo/Sora e Seedance 2.5 contra Sora/Kling/Veo, mas as páginas retornaram 401 repetidamente.
- Nenhum vídeo dedicado, bem-sucedido e em inglês sobre um modelo específico de geração de vídeo de código aberto — Wan, HunyuanVideo ou LTX — teve visualizações confirmadas nesta rodada. O único ponto de dados aberto que resolveu, SECourses, combina Wan 2.2 com dois modelos de imagem e tem mais de um ano.
Bluesky
Bluesky — Notícias de IA de Geração de Imagens e Vídeos
Data da pesquisa: 2026-09-18. Foi usada a API pública de busca do Bluesky (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts) com palavras-chave como “Sora 2”, “Nano Banana”, “Midjourney”, “ComfyUI”, “open weights model release” e “Runway/Veo”; foram verificadas até 15 postagens por consulta e mais de 70 no total.
Contas (contas emissoras)
- dfl.bsky.social — criador individual que publica diariamente ilustrações de paisagens em estilo fotográfico feitas com Nano Banana 2, geração de imagens do Gemini.
- triflingtree.bsky.social — usuário frequente que publica grande volume de trabalhos de arte por IA com as tags
#NanoBananaProe#GeminiAi. - ai.bots.law — bot de publicações automáticas que acompanha processos e movimentações jurídicas relacionadas à IA.
- gen-ai.news / aichina.news / stechtimes.com / channelnewsasia.bsky.social(via bridgy) — bots/feeds de notícias que distribuem notícias do setor de IA generativa.
- pitchwall.bsky.social / onestudio1.bsky.social / beginnersinai.bsky.social — contas que apresentam comparativos de ferramentas de IA e notícias de produtos.
- primereports.bsky.social / techpresso.bsky.social / theregister.com / socialmedialab.ca — contas internacionais de notícias que acompanham a abertura de pesos de modelos como Meta “Muse” e Alibaba Qwen.
- singularityhorizon.bsky.social / heppokopu.bsky.social / misaka-mikoto-17.bsky.social / 404ai.bsky.social — usuários japoneses que criam arte de IA com Midjourney ou ambientes locais, como ComfyUI.
Postagens (principais)
Modelos proprietários
- Postagem apresentando a API pública do Sora 2: “Sora 2 API: A developer-friendly API for Sora 2 and Sora 2 Pro”. 2026-09-15, Likes 0 / Reposts 0.
https://bsky.app/profile/pitchwall.bsky.social/post/3mvjwvr327k2u - Postagem comparando geração de vídeo por IA: “Veo 3.1 vs Sora 2 vs Kling 3.0”. 2026-09-14, Likes 2 / Reposts 0.
https://bsky.app/profile/onestudio1.bsky.social/post/3mvhdlv5vgk2w - Postagem que menciona o fim do app independente Sora e aconselha migrar para Runway, Kling ou Veo, explicando que a OpenAI está encerrando o app, não a tecnologia em si. 2026-03-25, Likes 0.
https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l - Postagem sobre novos documentos apresentados no processo de direitos autorais Disney contra Midjourney. 2026-09-18, Likes 0.
https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n - Ilustração de paisagem japonesa em vista aérea gerada com Nano Banana 2. Likes 25 / Reposts 1, 2026-09-17.
https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i - Arte surreal de árvore com a tag
#NanoBananaPro. Likes 15, 2026-09-17.
https://bsky.app/profile/triflingtree.bsky.social/post/3mvpliiqt5c25 - Postagem rápida dizendo “Meta ya tiene su rival para Nano Banana 2”, ou seja, que a Meta prepara um concorrente para Nano Banana 2. 2026-09-16, Likes 0.
https://bsky.app/profile/laiadesk.bsky.social/post/3mvmiod2iod26
Código aberto
- Notícia de que a Lightricks marcou o modelo de geração de vídeo LTX-2.3 como legado e passou a recomendar LTX-2.5. 2026-09-12, Likes 0.
https://bsky.app/profile/gen-ai.news/post/3mvdadb2upx2l - Postagem apresentando um LoRA FLUX de pesos abertos, divulgado via Modelers.cn, para representação de pessoas africanas. 2026-09-09, Likes 0.
https://bsky.app/profile/aichina.news/post/3mv3dcr6hgz2i - Notícia do lançamento do modelo multimodal MoE da Alibaba, “Qwen3.8-Flash”, uma prévia da arquitetura Qwen4. 2026-08-30, Likes 1.
https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s - Postagem relatando que uma instituição de pesquisa de Abu Dhabi lançou famílias de modelos de IA completamente abertas, incluindo pesos, dados de treinamento e código. 2026-09-03, Likes 0.
https://bsky.app/profile/channelnewsasia.bsky.social/post/3mumk4agbwm2g - Postagem analítica dizendo que empresas chinesas de IA vêm lançando sucessivamente modelos abertos em meio à competição de redução de preços com empresas ocidentais. 2026-09-06, Likes 0.
https://bsky.app/profile/stechtimes.com/post/3muuykcvzv62i
Sinais
- Nano Banana 2, a geração de imagens Gemini do Google, está consolidado em postagens cotidianas de criadores individuais. Pessoas como triflingtree e dfl publicam trabalhos quase diariamente com as tags
#NanoBananaProe#GeminiAi, sugerindo uso real disseminado, não apenas interesse inicial. - Em torno do Sora 2, convivem expectativa e incerteza sobre o futuro. Há notícias sobre a API para desenvolvedores, mas também recomendações para migrar para Runway/Kling/Veo após o fim do app independente. A reorganização da estratégia de geração de vídeo da OpenAI está em debate.
- Processos de direitos autorais são um tópico importante no lado proprietário. Bots acompanham novas movimentações no processo Disney contra Midjourney, e a disputa judicial entre estúdios e empresas de geração de imagens por IA continua.
- No código aberto, predominam notícias rápidas via bots, com poucas postagens pessoais de alto envolvimento. LTX-2.5 da Lightricks, LoRAs de FLUX, Qwen3.8-Flash e modelos totalmente abertos de Abu Dhabi mostram fontes distribuídas entre Ocidente, China e Oriente Médio.
- Modelos Meta “Muse”, como Spark/Glimmer 30B, continuam sendo anunciados como pesos abertos “em breve”, e diversas contas de notícias estrangeiras observam seu desenvolvimento como concorrente de Nano Banana 2.
- ComfyUI é citado como ferramenta padrão de geração local por usuários japoneses, como heppokopu e misaka-mikoto-17. Há tentativas de aproximar a qualidade de ChatGPT/Nano Banana em ambientes locais.
Limites
- A API pública de busca (
public.api.bsky.app/api.bsky.app) retornou HTTP 403 intermitentemente para fetches automatizados. Consultas simples com palavras separadas por espaço — por exemplo,Sora 2 videoeMidjourney— funcionaram após tentativas repetidas; porém, consultas com frases entre aspas, como"Stable Diffusion", ou sintaxe OR quase sempre falharam. Não foi possível obter dados uma única vez para “Stable Diffusion”, “Wan 2.5” ou “Qwen Image”, o que contribui para a escassez de postagens diretas sobre modelos abertos de geração de vídeo. - As páginas web de
bsky.appsão renderizadas no cliente; ao acessá-las diretamente, o texto não é obtido sem executar JavaScript. Todas as leituras reais foram baseadas no texto e nas contagens da API JSON. - Sem login, não foi possível acessar feed de seguidos, feeds personalizados ou listas privadas. O material obtido se limita a buscas públicas por palavra-chave.
- As buscas priorizaram nomes de produtos e modelos em inglês, sem pesquisa ativa em japonês. Postagens japonesas encontradas, como singularityhorizon, heppokopu e tjb-shizuka, apareceram incidentalmente em consultas em inglês, sem garantia de cobertura do debate em língua japonesa.
Lemmy
Lemmy — Tópicos sobre IA de geração de imagens e vídeos, setembro de 2026
Comunidades
- !«メールアドレス» — especializada em IA aberta de geração de imagens e vídeos, incluindo extensões ComfyUI e distribuição de modelos. Foi o principal achado desta rodada, com forte concentração de postagens relacionadas ao modelo de vídeo MiniMax-H3.
- !«メールアドレス» — cerca de 1,6 mil assinantes, dos quais 206 locais. Voltada a postagens de arte de anime feita com modelos da família Stable Diffusion, apenas SFW.
- !stable_diffusion_art / !stable_diffusion_abstract / !stable_diffusion_witches / !stable_diffusion_mycology / !stable_diffusion_furry / !stable_werewolves(todas em lemmy.today)— conjunto de comunidades de arte por IA divididas por nichos temáticos. São mais galerias de trabalhos do que espaços de notícias.
- !«メールアドレス» — comunidade espelho que reproduz crossposts de r/ArtificialIntelligence. Quase não há discussões originais do Lemmy.
- !«メールアドレス» — 8.235 assinantes. Comunidade crítica e anti-IA, com muitas postagens céticas sobre geração de imagens e vídeos por IA.
- !«メールアドレス» — 2.698 assinantes. Comunidade de “sneer” que ironiza o hype do setor de tecnologia. Foi onde a notícia sobre a mudança de direção da Midjourney teve maior repercussão.
- !«メールアドレス» — notícias gerais de tecnologia, com várias notícias principais relacionadas à Midjourney.
Postagens
- Sequência de extensões ComfyUI para MiniMax-H3, a principal tendência de código aberto — cerca de 20 postagens em !«メールアドレス» apenas entre 2026-08-28 e 09-16. Exemplos:
- “ComfyUI-FL-MiniMaxH3” (score 5, 2026-08-30, github.com/filliptm/ComfyUI-FL-MiniMaxH3), com recursos de linha do tempo de prompt e composição de planos.
- “H3-World” (score 3, 2026-09-02, huggingface.co/DANNY621/H3-World), que se descreve como “the first interactive world model built on MiniMax-H3”.
- “ComfyUI-MiniMaxH3-CLSS” (score 0, 2026-09-01, github.com/nazgut/ComfyUI-MiniMaxH3-CLSS), que promete geração de vídeos com áudio, de duração arbitrária, em máquinas de consumo com 16 GB de VRAM.
- “ComfyUI_MinimaxH3_AutoContext” (score 1, 2026-09-16, github.com/supElement/ComfyUI_MinimaxH3_AutoContext), para geração contínua de vídeos infinitamente longos mesmo com pouca VRAM.
- Segundo comentário do usuário brucethemoose (score 12, 2026-09-14), MiniMax-H3 permite combinar arbitrariamente áudio, vídeo e imagem como referências e roda localmente em um PC doméstico comum com RTX 3090 + Ryzen 7800.
- Midjourney muda de geração de imagens para dispositivos médicos, um scanner ultrassônico de corpo inteiro — postagem em !«メールアドレス» (https://awful.systems/post/8731127 , score 40, 15 comentários, 2026-06-19). David Gerard apresentou o anúncio “Midjourney Medical”, e os comentários fizeram repetidas comparações irônicas com Theranos. O usuário YourNetworkIsHaunted apontou uma limitação técnica: o dispositivo só permite imersão até 60 polegadas, cerca de 152 cm, e portanto não captura acima do coração (score 10). Terranoid chamou a mudança de uma tentativa desesperada depois que o negócio de geração de imagens chegou a um impasse (score 10).
- A mesma notícia também circulou várias vezes em !«メールアドレス»: “Midjourney pivots from AI image generation...” (theregister.com, score 58, 2026-06-18) e “Midjourney wants Hollywood studios to reveal...” (techcrunch.com, score 73, 2026-07-05).
- Relato de que o negócio corporativo da Runway dobrou — !«メールアドレス» (score 0, 2026-08-30, crosspost de reddit.com/r/ArtificialInteligence/comments/1w2hnea). A taxa de retenção líquida de receita em contratos empresariais, superior a 300%, chamou atenção.
- Integração de “Nano Banana” ao Google Earth foi interrompida no dia seguinte ao lançamento — !«メールアドレス» (fortune.com, 2026-08-07) e postagens relacionadas em !«メールアドレス». Apontou-se que qualquer pessoa conseguia criar imagens falsas com aparência de fotos de satélite, conforme também artigo da 404media.co, e o Google teria retirado a função imediatamente.
- Comparação do mesmo prompt em seis modelos de vídeo por IA — !«メールアドレス», “I ran the same prompt through 6 AI video models...” (score 1, 2026-09-17, reddit.com/r/ArtificialIntelligence/comments/1wipgwa).
- Comparação de colorização de mangá em preto e branco com ChatGPT Images, Wan, Nano Banana Pro e Seedream — !«メールアドレス», “Same Berserk spread, 4 AI colorizations. Looks like GPT wins again?” (score 1, 2026-09-14). Compara lado a lado Wan, do lado aberto, com Nano Banana Pro, Seedream e GPT Images, do lado proprietário; comentários avaliaram positivamente o acabamento do GPT.
- Postagem que demonstra o tom anti-IA — !«メールアドレス», “Why companies like anthropic and open AI make AI even worse” (score 63, 2026-09-14). Não trata especificamente de geração de imagens ou vídeos, mas registra o clima geral do Lemmy, de forte desconfiança em grandes empresas proprietárias.
- Relato de execução local de Qwen — !«メールアドレス», “Testing Qwen 3.8 27B running locally on a single 5090” (score 1, 2026-09-16, v.redd.it/jdrothgw4vph1). Não é geração de imagens em si, mas faz parte do contexto de execução de modelos abertos em GPUs de consumo.
- Fluxo cotidiano de arte por IA, como anime e arte abstrata — em !share_anime_art e comunidades !stable_diffusion_art, novas postagens com imagens hospedadas em civitai.com continuam surgindo quase diariamente. Exemplo: “Isshiki Clear - Mahjong Fight Girl”, score 15, 2026-09-17, lemmy.dbzer0.com/post/75601449. Têm pouco valor de notícia, mas mostram o uso cotidiano de modelos Stable Diffusion, Flux e Krea2.
Sinais
- No código aberto, é praticamente “MiniMax-H3 em todo lugar”. A comunidade stable_diffusion, entre o início e meados de setembro, ficou tomada por ferramentas ComfyUI para esse modelo de vídeo. Destacam-se repetidamente a capacidade de combinar áudio, imagem e vídeo em GPU local e o progresso de otimizações para funcionar com cerca de 16 GB de VRAM.
- O lado proprietário teve poucas notícias positivas. A pivô da Midjourney para hardware e a retirada de recurso do Google Earth se destacaram como notícias de rumo confuso. O relatório de crescimento da Runway é um dos poucos tópicos positivos.
- O tom geral do Lemmy é cético e crítico, especialmente em !fuck_ai e !techtakes. Há pouco entusiasmo irrestrito, e uma forte diferença de clima entre comunidades de implementação, como stable_diffusion, e comunidades de crítica de notícias, como techtakes e fuck_ai.
- Predominam postagens de obras e crossposts, não discussões originais. !ai_reddit é literalmente uma retransmissão do Reddit, portanto não constitui fonte primária originada no Lemmy.
Limitações
- Lemmy é distribuído entre instâncias, e a API de busca só encontra postagens indexadas em lemmy.world. Não houve tempo para pesquisar individualmente lemmy.ml ou lemm.ee; a rodada cobriu somente resultados federados via lemmy.world.
- Foram buscadas várias palavras-chave, como “Sora”, “Veo”, “Gemini image” e “Flux”, mas não foram encontradas postagens sobre anúncios de novos modelos Sora 2 ou Google Veo; apareceram sobretudo tópicos irrelevantes. Na prática, notícias de lançamento de produtos das grandes empresas proprietárias são escassas no Lemmy.
- O artigo original de pivot-to-ai.com apresentava caracteres corrompidos ao ser lido por WebFetch, impedindo citação direta. O conteúdo foi reforçado usando o texto e comentários da postagem no Lemmy awful.systems e notícias externas encontradas por mecanismo de busca, como Bloomberg.
- A API apresentou instabilidade, com erros 400/500, para números de assinantes; não foi possível obter as contagens exatas de !stable_diffusion e !ai_reddit. Apenas !share_anime_art, cerca de 1,6 mil, !fuck_ai, 8.235, e !techtakes, 2.698, foram confirmados.
- Em relação ao critério do briefing de analisar cerca de 20 postagens em cada rede social, foram confirmadas mais de 20 postagens com texto, score e data após buscas por múltiplas palavras-chave. Este arquivo apresenta apenas nove exemplos selecionados.
Pinterest — Notícias de IA de Geração de Imagens e Vídeos
Temas visuais
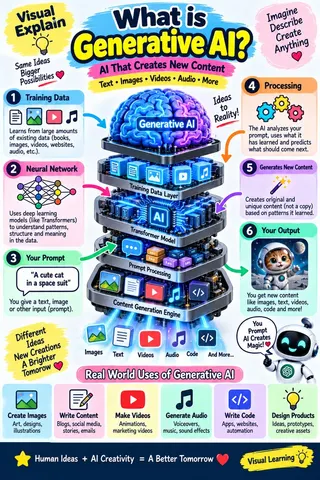
- O template de infográfico “resumo de notícias de IA” em néon escuro domina. Fundos quase pretos ou azul-marinho, linhas brilhantes em ciano-magenta-roxo, tipografia branca em negrito e fileiras numeradas de logotipos de ferramentas em emblemas arredondados. Essa linguagem visual cobre a maior parte dos pins informativos.
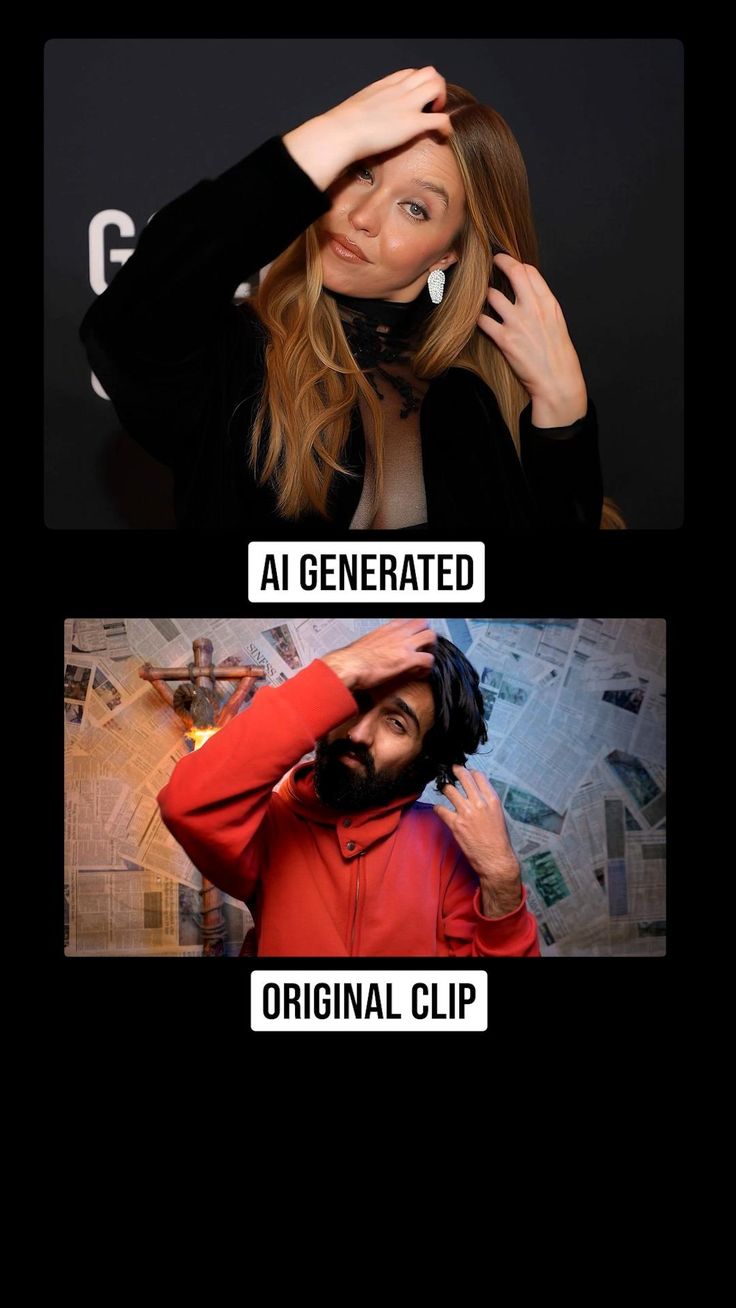
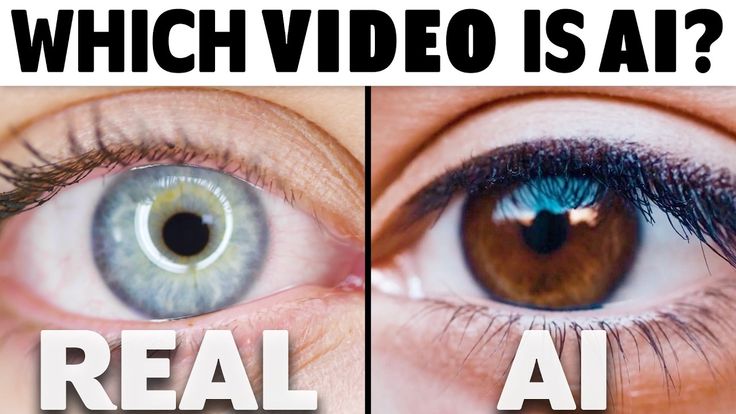
[6, 9, 10, 11, 18, 20, 26, 31, 38, 39, 41, 45, 48] - O formato de desafio “identifique a IA”, real versus falso, está por toda parte. Comparações lado a lado ou A/B que desafiam o público a escolher a foto, vídeo ou olho real, além de uma demonstração de foto de tapete vermelho com troca de rosto e uma selfie hiper-realista com a legenda “This is AI”.
[3, 21, 24, 33, 46] - IA personificada como robô humanoide cromado/branco. Androides de corpo inteiro — um em uma bancada de telejornal “BREAKING NEWS”, outro segurando um telefone ao lado de um selo “FAKE”, outro tocando um globo luminoso sobre uma paisagem urbana — representam a IA em si, em vez de um produto específico.
[3, 40, 44] - Miniaturas de reação de YouTubers para conteúdo de notícias sobre IA. Homens barbudos ou assustados ao lado de fileiras de logotipos de OpenAI, Google, Meta, Anthropic e Notion, um padrão reconhecível para vídeos de “notícias semanais de IA”.
[2, 19, 22, 42] - Demonstrações de uma fonte de vídeo em muitos estilos, mostrando tecnologia de consistência de imagem/vídeo. A mesma pessoa caminhando e o mesmo carro são renderizados como blocos de madeira, origami, Lego, flores e brinquedo, em uma vitrine de difusão ao estilo “Lumendra/Luminate”.
[5] - O mesmo pequeno grupo de ferramentas se repete em todas as listas: Runway (Gen-3), Pika, Kling AI, Luma/Dream Machine, Google Veo (2 e 3), Canva AI, Hailuo AI (MiniMax), CapCut, ElevenLabs e Stable Video Diffusion.
[6, 10, 18, 20, 31, 45] - Retratos hiper-realistas gerados por IA como prova de qualidade. Um pescador idoso fotorrealista no AMD “Amuse 3.0”, uma estátua de mármore e madeira tocando violoncelo e composições de rostos de “bebês de IA” são usados para vender quão convincentes os modelos atuais parecem.
[25, 47, 50] - Enquadramento de telejornal ou jornal falso para as próprias notícias de IA. Chyrons falsos de “BREAKING NEWS”, um gerador de avatar âncora de notícias por IA, Wondershare Virbo, e uma primeira página simulada de jornal, “The AI Dispatch”, de 15 de agosto de 2026, mostram conteúdo de notícias sobre IA imitando convenções do jornalismo televisivo e impresso.
[14, 36, 40, 41]
Pins notáveis
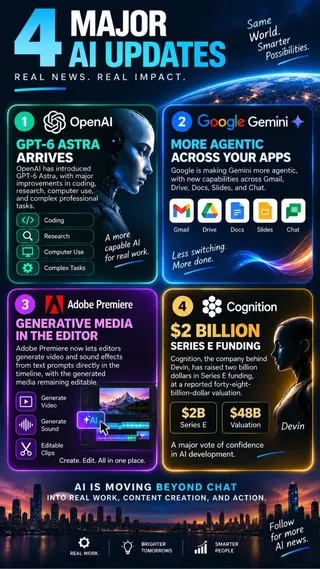
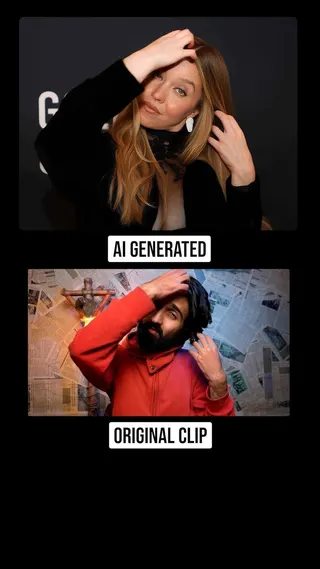
[5](sem título, grade de transformação de vídeo em múltiplos estilos) — um vídeo-fonte de uma pessoa e um carro é renderizado em cinco materiais diferentes: madeira, origami, Lego, flores e plástico de brinquedo. É a demonstração mais concreta de tecnologia atual de consistência entre imagem e vídeo no conjunto.[9]“4 Major AI Updates You Need to Know in 2026” — cita itens específicos: “GPT-6 Astra” da OpenAI, Gemini tornando-se agêntico no Gmail/Docs/Slides, Adobe Premiere gerando vídeo e áudio na linha do tempo e a Cognition, Devin, levantando uma Série E de US$ 2 bilhões a uma avaliação de US$ 48 bilhões.[28]“ByteDance and Hollywood reach global deal on AI copyright” — pin com estilo de notícia real: ByteDance teria chegado a um acordo com a Motion Picture Association para reforçar a proteção de PI em suas ferramentas de imagem e vídeo por IA.[45]“Today's AI News — May 20, 2026” — resume o Google I/O 2026: Gemini 3.5 Flash, Gemini Omni, reformulação da Busca com IA, recursos de acessibilidade da Apple AI e a corrida por óculos inteligentes com IA e Android XR.[41]“The AI Dispatch”, 15 de agosto de 2026 — primeira página de jornal simulada, listando ampla variedade de temas atuais adjacentes a IA: velocidade de inferência, IA soberana, harnesses de agentes, segurança de IA e pesquisa profunda.[31]“AI Video Creation Tools Changing How Content Is Made” — o diretório individual mais completo encontrado: 20 produtos nomeados em categorias de texto para vídeo, imagem para vídeo, edição, locução, banco de mídia/B-roll e publicação/otimização.[24](sem título, foto de tapete vermelho gerada por IA versus “original clip”) — demonstração de troca de rosto/deepfake que contrapõe um retrato brilhante gerado por IA ao clipe-fonte real de outra pessoa, ilustrando tecnologia de transferência de identidade.[40]“Discover how Grok is revolutionizing video...” — robô humanoide âncora em uma mesa “BREAKING NEWS” promovendo a capacidade de vídeo do Grok.[47]“Amuse 3.0” — ferramenta local/de dispositivo para criação de arte por IA da AMD, demonstrada com o retrato fotorrealista de um pescador idoso.[10]“AI Image Video: Best Quality vs Best Free” — infográfico em forma de árvore de decisão que divide ferramentas entre melhor qualidade paga — ChatGPT Plus, Midjourney, Adobe Firefly, Runway Gen-3 e Luma — e gratuitas — Ideogram, camada gratuita do Gemini, SeaArt, Krea e CapCut.
Sinais
- Listas e compilações de ferramentas de geração de vídeo são o tipo de conteúdo mais repetido e mais visível. O público de geração de imagens por IA no Pinterest parece composto sobretudo por criadores de SEO/afiliados que empacotam o mesmo conjunto de ferramentas proprietárias — Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut —, e não por quem divulga notícias inéditas.
- Conteúdo de letramento “você consegue dizer se é IA?”, com desafios real versus falso e demonstrações de deepfake, constitui um subgênero próprio. Isso sugere que ansiedade e curiosidade sobre detecção são, por si, fatores que movem conteúdo, independentemente de lançamentos de modelos específicos.
- Alguns pins mencionam eventos nomeados e datados após a abertura da janela de coleta: resumo do Google I/O 2026, “GPT-6 Astra”, um boletim de notícias de 15 de agosto de 2026 e a rodada de US$ 2 bilhões da Cognition. São os pontos mais próximos de notícias concretas encontrados na plataforma.
- Detalhes sobre código aberto são escassos: “Stable Video Diffusion” aparece apenas como um logotipo dentro de um diretório de 20 ferramentas
[31]; nenhum pin discute em profundidade lançamento de pesos abertos, licença ou fork comunitário. - Nada do conjunto aborda metodologia de treinamento, arquitetura de modelos ou debates sobre conjuntos de dados/licenciamento, exceto o único pin sobre o acordo de direitos autorais ByteDance–MPA
[28].
Limites
- Esta etapa descreve apenas imagens que o worker já havia coletado, conforme
platforms/pinterest.md. Não houve navegação, busca ou leitura ao vivo no Pinterest; portanto, nenhuma afirmação foi verificada contra uma página ativa ou o artigo vinculado a cada pin. - Vários pins são templates quase duplicados, provavelmente de contas de repostagem/scraping: o gráfico de banco de imagens em néon “Generate content with AI” aparece duas vezes
[11, 26], o banner do Google Veo 2 aparece duas vezes[7, 8]e a lista “Best AI Video Generation Websites” aparece duas vezes com o mesmo conjunto de ferramentas[6, 18]. - Cinco pins não têm título,
(untitled), na tabela-fonte[8, 17, 20, 21, 24, 28... ]; especificamente,[8, 20, 21, 24, 28]têm títulos vazios ou genéricos, limitando a atribuição ao que é visível apenas na imagem. - O conjunto de pins reúne um único gênero, pois não foi definida uma segmentação por gênero nesta rodada. Os 50 pins vieram de uma busca indiferenciada, impedindo comparações por categoria.
Ações recomendadas
- Refazer a coleta do X usando termos diretamente ligados a IA, como Sora, Nano Banana, Kling, Qwen, Flux e ComfyUI; desta vez foram capturadas por engano palavras de tendências do X, e a coleta falhou completamente.
- Continuar acompanhando MiniMax-H3 e Qwen-Image como principais indicadores do ecossistema de código aberto.
- Acompanhar o movimento dos destinos de migração de usuários — Runway, Kling e Veo — antes e depois do fim da API do Sora 2, em 2026-09-24.
- Acompanhar processos jurídicos e ética, como Disney contra Midjourney e o debate sobre legalização de geração sem consentimento, com prioridade igual ou maior que a de comparações de ferramentas.
- Adicionar à coleta do Reddit consultas para subreddits especializados em geração de imagens, como r/StableDiffusion e r/aiArt.
- Verificar ao vivo os artigos vinculados aos achados do Pinterest.
Imagens coletadas
























Nota sobre qualidade dos dados
Entre as seis plataformas definidas no briefing, o X não pôde ser usado porque os dados coletados estavam completamente fora do tema. Reddit, Bluesky e YouTube também deixaram escapar alguns tópicos principais — como Stable Diffusion e Wan 2.5 — devido a termos de busca e limitações de API, incluindo 403/401/CAPTCHA.