Notícias de IA de Geração de Imagem e Vídeo — 2026-09-20
O código aberto (sobretudo modelos chineses como Qwen, Wan e MiniMax-H3) está ganhando presença rapidamente como alternativa para usuários que esgotaram as cotas gratuitas de soluções fechadas. Por outro lado, a etapa do X não trouxe dados por usar termos de busca irrelevantes, deixando a fundamentação desta edição limitada, na prática, a cinco plataformas.
Resumo de notícias de IA para geração de imagem e vídeo — código fechado vs. código aberto — 2026-09-20
E aí! Desta vez, conferimos rapidamente seis plataformas — Reddit, X, YouTube, Bluesky, Lemmy e Pinterest 🔥🔥 Em resumo: o grupo de código fechado (Google Veo/Nano Banana, Sora 2, Midjourney, Kling, Seedance e afins) continua no centro das notícias, e a sincronização de áudio está virando de verdade um recurso padrão. Mas o grupo de código aberto, especialmente os modelos chineses Qwen, Wan e MiniMax-H3, está alcançando em velocidade impressionante e se consolidando como refúgio para quem esgotou as cotas gratuitas 🚀 Um ponto importante, ainda que discreto: a reação negativa contra conteúdo gerado por IA está mais forte em espaços frequentados pelo público geral do que nas comunidades de entusiastas de IA 😤. Sendo totalmente sincero, porém, a etapa do X foi um fracasso completo; por isso, a base deste relatório corresponde, na prática, a cinco plataformas 🙏
Entre plataformas
- O impulso do código aberto não para: há forte consistência entre Reddit (Wan, MiniMax H3 e Krea2 aparecem em várias discussões como refúgio após o fim das cotas gratuitas de soluções fechadas), Lemmy (mais de 15 publicações de ferramentas ComfyUI para MiniMax-H3 somente em setembro na comunidade
!stable_diffusion) e YouTube (Qwen-Image → Qwen-Image-2512 → Z-Image; Wan 2.5 → 2.6 → 2.7, em atualizações quase mensais). A ideia de que “código aberto = alta qualidade sem custo” está se tornando padrão de fato 💪 - A geração fechada de vídeo está tornando o áudio obrigatório: o mesmo movimento aparece no Bluesky (áudio sincronizado do Kling 3.0 anunciado pela Replicate e integração de áudio e vídeo no Seedance 2.0) e no YouTube (Grok Imagine 1.5 apresentado como capaz de gerar falas e sons ambiente simultaneamente) 🎬🔊
- A linha Veo/Nano Banana do Google virou o “rosto” do ecossistema fechado: isso foi confirmado em três frentes — Pinterest (vídeos quentes em estilo Pixar do Veo repetidamente usados em imagens virais), YouTube (Theo - t3.gg afirmando que “o Google venceu a geração de imagens”) e Reddit (expansão das cotas gratuitas do Google Flow) 👀
- A rejeição a conteúdo gerado por IA está explodindo fora dos círculos de fãs de IA: Reddit (354 pontos de indignação pela aceitação de obras de IA pelo ArtPrize e 63 pontos de reclamações sobre metas de produção em massa de imagens de IA no trabalho), Lemmy (a comunidade anti-IA
!fuck_aitem 9.179 usuários ativos mensais, uma das maiores do Lemmy) e Pinterest (quiz “Real vs. IA” se consolidou como gênero próprio) transmitem a mesma atmosfera 😨 - Informações primárias chegam mais por indivíduos do que por empresas: no Bluesky, contas corporativas oficiais estão quase silenciosas, e pesquisadores individuais como Simon Willison, além de serviços de hospedagem como a Replicate, viraram fontes. No YouTube, resumos semanais de canais pessoais como AIPOD-CAST e Lev Selector também funcionam como fontes de notícias. A escassez de canais com comunicação primária oficial de empresas parece uma tendência comum 📢
Plataforma por plataforma
Reddit: foram reunidas 12 discussões de nove subreddits, abaixo da meta de 20. A ideia de que ferramentas abertas (Wan, MiniMax H3, Krea2) servem de escape quando as cotas gratuitas de soluções fechadas acabam apareceu repetidamente. Já as avaliações do GPT Image 2.5 Flare ficaram divididas entre quem o considera “incrível” e quem diz que “é igual ao Krea2” 😂 O ponto surpreendente foi que os maiores debates vieram de comunidades gerais (reação ao ArtPrize: 354 pontos) e profissionais (desabafo de designers: 63 pontos), mais do que de subreddits técnicos de IA.
X: sinceramente, aqui ocorreu um acidente completo 🙈 As 40 publicações coletadas só buscaram tendências genéricas como “Greenland”, “#Bitcoin” e “Chelsea”, relacionadas ao local de conexão, aparentemente na região da Croácia. Não houve nenhuma publicação sobre IA de geração de imagem ou vídeo. Portanto, não foi possível extrair do X nenhum insight sobre soluções fechadas ou abertas nesta edição. Trata-se de uma lacuna clara em uma plataforma explicitamente prevista pelo briefing 🕳️
YouTube: foram analisados 12 vídeos. Os grupos de código fechado (Theo, Astrovah, Woollyfern, especializado em atualizações mensais do Midjourney, e FixNode) e de código aberto (Bijan Bowen, HitPaw, MaxonShire e Promptus AI) ficaram bem separados. O lado aberto enfatiza “ComfyUI”, “execução local” e “gratuito”, enquanto o fechado enfatiza qualidade e recursos. O problema é que a página de resultados depende tanto de JavaScript que quase não foi possível obter números de visualizações ou inscritos 😅
Bluesky: como a API oficial de busca foi bloqueada com 403 repetidamente, a coleta passou a seguir publicações de pesquisadores individuais (Simon Willison, Max Woolf e Ethan Mollick) e da Replicate. Quase tudo o que foi encontrado era código fechado: GPT Image 2, Runway Gen-4.5, Kling 3.0, Seedance 2.0 e Vidu Q3. Não foram encontradas contas ativas de comunidade de código aberto; a única conta semelhante cessou a atividade em fevereiro de 2025. Também foi curioso notar que a imagem de um pelicano andando de bicicleta se tornou uma piada recorrente para comparar modelos 🐦🚲
Lemmy: foi a plataforma com melhor equilíbrio e separação mais clara entre aberto e fechado. No lado aberto, houve uma enxurrada de MiniMax-H3 em !stable_diffusion e o novo modelo Boogu-Image-0.1 (Apache-2.0, 10 bilhões de parâmetros). No fechado, apareceram Nano Banana 2 Lite, da Google, MAI-Image-2.5, da Microsoft, experimentos de histórias longas no Sora 2 e a surpreendente notícia de que o Midjourney estaria migrando para spas médicos 😲 A presença da comunidade anti-IA !fuck_ai (8.252 membros) também foi uma descoberta característica do Lemmy.
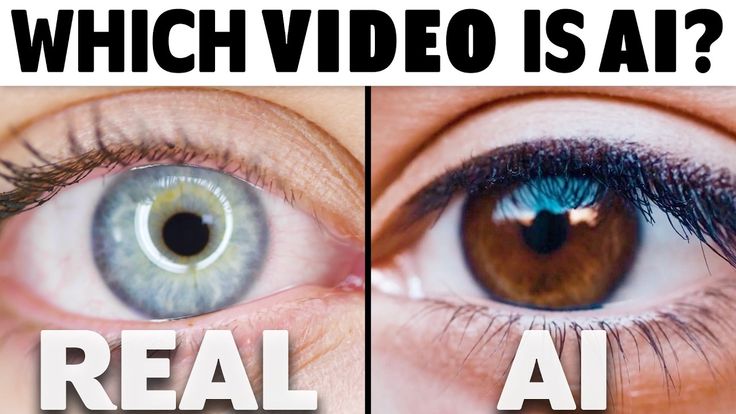
Pinterest: foram verificadas, com imagens, 30 das 50 pins pré-coletadas. Enquanto listas de ferramentas fechadas e miniaturas reutilizadas de “AI NEWS” são produzidas em massa, o código aberto quase não aparece — apenas uma ocorrência do Amuse 3.0, ferramenta local. Chamou atenção o uso excessivamente repetido de vídeos do Veo, do Google, e a consolidação de quizzes de autenticidade do tipo “Isso é IA? É real?” como gênero 🎨
O que observar
- Crescimento acelerado de ferramentas ComfyUI para MiniMax-H3 (Lemmy
!stable_diffusion, exemplo: https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS) — possível novo protagonista da geração aberta de vídeo 🔥 - O problema de “production memory” do Sora 2 (Lemmy via Reddit, https://lemmy.durstig.online/post/59922) — manter consistência em produções longas parece ser a próxima barreira, mais do que gerar clipes isolados
- A tese de domínio do Google Nano Banana Pro (YouTube, Theo - t3.gg, https://www.youtube.com/watch?v=UV9GqinedQ8) — será mesmo nível “não precisa de Photoshop”? Aguardando novos desdobramentos
- A disputa GPT Image 2.5 Flare vs. Krea2 aberto (Reddit, https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/) — a própria vantagem das versões pagas começa a ser questionada
- A aceitação de obras de IA pelo ArtPrize (Reddit r/grandrapids, https://www.reddit.com/r/grandrapids/comments/1wi4ub0/) — pode se tornar um indicador do limite de aceitação na sociedade em geral
- A guinada do Midjourney para spas médicos e as exigências de divulgação a Hollywood (Lemmy, https://lemmy.zip/post/66397234 、https://lemmy.today/post/56011946) — surgem riscos para a credibilidade da empresa
Recomendações
- Refazer a etapa do X usando termos diretamente ligados ao tema, como "Sora 2" "Midjourney" "Stable Diffusion" "Runway Gen" "Kling AI" "open source image generation".
- Incluir a frequência de lançamentos de projetos chineses abertos como MiniMax-H3, Qwen, Wan e Z-Image na lista de monitoramento de toda edição.
- Continuar acompanhando reações em comunidades gerais e profissionais, não apenas em comunidades especializadas em IA, pois os sinais de reação negativa são fortes.
- Testar alternativas para contornar o problema 403 da API oficial de busca do Bluesky antes da próxima edição.
- Acompanhar na próxima rodada os desdobramentos do problema de “production memory” do Sora 2 e da mudança do Midjourney para spas médicos.
- Coletar dados do Pinterest com etiquetas de gênero, permitindo separar mecanicamente conteúdo aberto e fechado.
Qualidade dos dados
A etapa do X usou termos de busca não relacionados ao tema — geopolítica, criptomoedas e futebol, entre outros — e, das 40 publicações coletadas, zero eram relevantes; portanto, não havia dados úteis na prática. Reddit (12 itens) e Bluesky (cerca de 12 itens extraídos por contas pessoais devido ao bloqueio da API de busca) não atingiram o critério de conclusão do briefing de aproximadamente 20 itens por plataforma. Pinterest e YouTube também tiveram limitações parciais: no Pinterest, não havia etiquetas de gênero nem navegação ao vivo; no YouTube, visualizações e inscritos não puderam ser obtidos por dependerem de JavaScript. Ainda assim, foi possível coletar informações suficientes para a síntese. Lemmy e YouTube foram relativamente consistentes e forneceram insights concretos para ambos os lados, aberto e fechado.
Resumo por plataforma
Reddit — Notícias de IA de geração de imagem e vídeo
Onde
As 12 discussões coletadas vieram de nove subreddits.
| Subreddit | Número de membros | Discussões coletadas |
|---|---|---|
| r/generativeAI | 154,961 | 4 |
| r/graphic_design | 2,929,382 | 1 |
| r/GeminiAI | 375,783 | 1 |
| r/grandrapids | 161,719 | 1 |
| r/aitubers | 28,785 | 1 |
| r/ImagineAiArt | 19,335 | 1 |
| r/AIToolTalks | 6,757 | 1 |
| r/aifilmmaking | 8,200 | 1 |
| r/aivideomaking | 7,267 | 1 |
r/generativeAI é o principal hub sobre geração de imagens e vídeos por IA propriamente dita (quatro itens). r/GeminiAI e r/ImagineAiArt reúnem relatos de experiência com modelos fechados; r/aifilmmaking e r/aivideomaking abordam a produção de vídeo sob uma ótica profissional; r/grandrapids e r/graphic_design mostram reações quando conteúdo gerado por IA entra no mundo real, em competições de arte e no trabalho; r/AIToolTalks funciona como espaço para ansiedades sobre IA em geral.
O que as pessoas dizem
- Discussão 1: “Qual gerador de vídeo por IA ainda pode ser usado gratuitamente?” (r/generativeAI · 18 pt · 57 comentários · 2026-09-16) https://www.reddit.com/r/generativeAI/comments/1whtesl/ — a geração aberta/local (Wan, MiniMax) está servindo como rota de fuga depois que as cotas gratuitas de ferramentas fechadas se esgotam. u/RioMetal: “Se você puder rodar localmente, terá muitas opções, como Wan ou MiniMax”.
- Discussão 2: “GPT Image 2.5 Flare — este é realmente o melhor modelo de geração de imagens por IA atualmente?” (r/ImagineAiArt · 84 pt · 60 comentários · 2026-09-16) https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/ — opiniões completamente divididas. u/oldboi777 chamou de “atualização incrível”, enquanto u/SeaworthinessFresh16 apontou que “o resultado no ComfyUI com Krea2 parece o mesmo”.
- Discussão 12: “Preciso de uma boa IA de geração de vídeo para transformar imagens de pessoas em vídeo” (r/generativeAI · 0 pt · 22 comentários · 2026-09-15) https://www.reddit.com/r/generativeAI/comments/1wh1y9d/ — o foco da publicação é a insatisfação com filtros de censura em ferramentas fechadas (Google Flow / Nano Banana Pro). u/f5alcon diz que “MiniMax H3 é o melhor gerador local”; u/jworm0624 recomenda “Krea 2 turbo para imagens, minimax h3 para vídeos. Tudo no comfyui”, apontando o código aberto como alternativa.
- Discussão 7: “O Google Flow está oferecendo aos criadores uma quantidade surpreendentemente generosa de geração gratuita de vídeo por IA agora” (r/aifilmmaking · 8 pt · 7 comentários · 2026-09-14) https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — Google Flow/Veo, de código fechado, expandiu créditos gratuitos e evolui de simples geração texto-vídeo para um espaço de produção com construção de cenas, controle de câmera e referência de materiais. Porém, u/MrBoondoggles comentou com frieza: “Não me surpreende que o Google esteja distribuindo Veo agora... tentando manter algum interesse no produto”.
- Discussão 8: “Alguém notou uma queda repentina na qualidade da geração de imagens? De 2 MB para 500 KB” (r/GeminiAI · 10 pt · 25 comentários · 2026-09-17) https://www.reddit.com/r/GeminiAI/comments/1wj02p4/ — usuários relatam degradação de qualidade no Gemini fechado, de PNG para JPEG e de 8 MB para 2 MB e depois 500 KB, incluindo reclamações de usuários pagos. u/Well_HellooF: “não há diferença de qualidade entre a versão gratuita e a paga. que droga”.
- Discussão 5: “ArtPrize permite IA generativa” (r/grandrapids · 354 pt · 176 comentários · 2026-09-16) https://www.reddit.com/r/grandrapids/comments/1wi4ub0/ — forte reação à aceitação de obras geradas por IA em uma competição de arte. u/Chirotera (319 pt): “Absolutamente nojento. Não é ‘arte’ de IA, é roubo”. A indignação em uma comunidade geral é maior do que em subreddits técnicos.
- Discussão 10: “A empresa espera que geremos 500 imagens de IA POR SEMANA. Isso é realista?” (r/graphic_design · 63 pt · 133 comentários · 2026-09-17) https://www.reddit.com/r/graphic_design/comments/1wieke2/ — designers em atividade reclamam de metas de produção em massa com ferramenta fechada, ChatGPT. u/Diligent-Educator409 (123 pt): “500 imagens de IA? Sim. 500 boas imagens de IA? Não. Uma boa imagem de IA? Também não.”
- Discussão 9: “melhores apps para gerar vídeos por IA” (r/aitubers · 0 pt · 46 comentários · 2026-09-14) https://www.reddit.com/r/aitubers/comments/1wg3duk/ — há demanda por ferramentas fechadas que automatizam vídeos a partir de roteiros, como InVideo AI e Steve AI, mas a reação da comunidade é fria. u/RobJames007 (15 pt): “O YouTube está tentando reduzir lixo de IA, não permitir que mais dele entre na plataforma”.
- Discussão 3: “Por favor, ajudem-me a gerar vídeo de IA grátis sem assinatura” (r/aivideomaking · 0 pt · 20 comentários · 2026-09-15) https://www.reddit.com/r/aivideomaking/comments/1wh80z3/ — u/Chance-Business observa que “no google flow você recebe 50 créditos grátis por dia, cada vídeo custa 6–12 créditos”, enquanto u/Bastisheen92 afirma que “geração local é grátis se você já possui o hardware”, reproduzindo o contraste clássico entre cotas gratuitas de sistemas fechados e execução local de código aberto.
- Discussão 11: “Todos vocês também estão ansiosos com as notícias recentes sobre IA?” (r/AIToolTalks · 12 pt · 36 comentários · 2026-09-13) https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — não é especificamente sobre geração de imagem ou vídeo: debate consumo de água, perda de empregos e regulamentação da IA em geral. Os comentários se dividem frontalmente, com u/Big-Pops78 relativizando preocupações hídricas e u/UnburyingBeetle respondendo com ironia ao termo “eficiência de custos”.
Sinais
- Tendência de alta: nomes de modelos abertos/locais como Wan, MiniMax H3, LTX Video e Krea2 surgem repetidamente em várias discussões independentes (1, 2 e 12), no mesmo contexto: alternativas depois que as cotas gratuitas de soluções fechadas acabam. A geração local está se tornando sinônimo de “alta qualidade sem custo”.
- Desdém e cinismo: há forte ironia contra serviços de geração de vídeo que se anunciam como “gratuitos”. Em várias discussões (1, 4, 6 e 12), a conta bot u/Jenna_AI publicou longos comentários sarcásticos, com a mesma mensagem central: prometem ser gratuitos, mas acabam cobrando. Isso simboliza o clima cínico da comunidade.
- Ponto surpreendente: comunidades gerais (r/grandrapids, 354 pt e 176 comentários) e profissionais (r/graphic_design, 63 pt e 133 comentários) têm engajamento e pontuação maiores do que subreddits técnicos de IA, como r/generativeAI, que em geral ficam entre um dígito e algumas dezenas de pontos. A reação e o debate crescem quando o conteúdo de IA se choca com a vida cotidiana e o trabalho.
- Conflito de opiniões: o GPT Image 2.5 Flare, na discussão 2, recebeu avaliações opostas: “atualização incrível”, de u/oldboi777, e “o mesmo resultado do Krea2”, de u/SeaworthinessFresh16. Na discussão 7, há tanto elogios aos créditos generosos do Google Flow/Veo quanto críticas como “é fraco em física e lógica. Até o MiniMax é muito melhor”, de u/Sea-Temporary-6995.
Limites
- Foram coletadas 12 discussões, abaixo do critério de conclusão do briefing de aproximadamente 20 publicações analisadas por plataforma. Essas 12 discussões são todos os dados disponíveis para Reddit; nesta etapa não é possível buscar ou navegar mais no Reddit, conforme instruções do playbook.
- Aparentemente, foi usada somente a busca em inglês “Image and Video Generation AI News”; não há sinal de consultas em japonês ou de termos orientados por perspectiva, como “código aberto” e “código fechado”.
- Alguns subreddits, como r/aitubers, r/aivideomaking e r/AIToolTalks, tiveram somente uma discussão coletada; não é possível inferir a força de tendências internas nessas comunidades.
X
X — Notícias de IA de geração de imagem e vídeo (fechado/aberto)
Contas
As 39 contas e 40 publicações reunidas em output/x.posts.md são todas irrelevantes para IA de geração de imagem/vídeo. Os termos de busca foram “Greenland”, “Denmark”, “#Bitcoin”, “NATO”, “Christ”, “Jubjub”, “Charles”, “Bosnia”, “Chelsea” e “Belgrade”. Eles correspondem a tendências gerais do Explore do X, aparentemente geolocalizadas a partir do local de conexão do servidor, na região da Croácia, e não incluem nenhum termo ligado ao briefing de pesquisa.
Por isso, não há nenhuma conta nos dados desta edição que permita responder quem está conduzindo o tema no X. Apenas para registrar o que foi coletado:
- Grupo de política/geopolítica: @RapidResponse47 (30.291 curtidas, relacionado à Groenlândia), @AJENews, @Rusia_HD, @Globalsurv, @NepCorres e outros, com publicações de notícias e opiniões sobre Groenlândia, Dinamarca e OTAN.
- Grupo de criptomoedas: @aacryptoverse, @Bitcoin_Pirate_, @StackandRun, @bitcr_org e outros, com publicações usando #Bitcoin, em geral de alcance pequeno, entre uma unidade e algumas dezenas de curtidas.
- Grupo de fofocas da realeza: @barristerlawusa, @hernandez_64876, @thebluestshade, @Rimmesfk, ligados ao tema “Charles”, relacionado a um livro de revelações sobre Charles Spencer.
- Grupo de futebol: @icunga_, @john322226, @Cfc_Kemboi, @Pats_Aura, em que “Chelsea” se refere a resultados do Chelsea FC.
- Grupo de memes/conversas casuais: @SardineKing_O, @isellbeforeyou, @0xHeatt, sobre a memecoin “$jubjub”, e @MarquiseDeBelgr, com duas publicações casuais em sérvio.
Nenhuma conta teve sequência excepcional de posts, com uma ou duas publicações por conta. A publicação de @RapidResponse47, com 30 mil curtidas e cerca de 6,8 milhões de visualizações, se destaca no conjunto, mas trata da questão de soberania da Groenlândia e não tem relação com o tema.
Publicações
Houve zero publicações, entre as 40 coletadas, que mencionassem IA de geração de imagem ou vídeo — aberta ou fechada. Assim, não há uma publicação representativa a apresentar. Como referência, segue apenas a publicação de maior engajamento, explicitamente fora do tema:
- @RapidResponse47 (fora do tema; apenas referência) — 30.291 curtidas · 5.022 repostagens · 1.164 respostas · cerca de 6.800.000 visualizações · 2026-09-18. https://x.com/RapidResponse47/status/2101059494587285834 — encontrada pela busca “Greenland”. É uma publicação política sobre a soberania da Groenlândia e não tem relação com imagens ou vídeos gerados por IA.
Sinais
- Nesta etapa do X, não foi encontrada nenhuma menção, discussão ou notícia sobre IA de geração de imagens ou vídeos — Midjourney, Sora, Runway, Stable Diffusion, Flux, Wan, Kling e similares. Não há material sequer para avaliar se algo está ou não em evidência.
- Os termos usados na coleta — Greenland, Denmark, #Bitcoin, NATO, Christ, Jubjub, Charles, Bosnia, Chelsea e Belgrade — coincidem exatamente com os títulos da lista “X's own Explore list” no início de
output/x.posts.md. Tudo indica que apenas tendências gerais do X na região do ponto de conexão foram pesquisadas, sem jamais usar termos do tema como geração de imagem por IA, geração de vídeo por IA, Sora, Midjourney, Stable Diffusion ou IA de código aberto. - Portanto, não é possível extrair desta etapa qualquer insight sobre tendências de código fechado ou aberto.
Limites
- A própria coleta não corresponde ao tema. Os dez termos usados por
output/x.posts.mdnão se relacionam a IA de geração de imagem ou vídeo; eles reproduzem tendências de geopolítica, fofocas da realeza, futebol e memes de criptomoedas. Como o worker não executou uma única busca ligada ao briefing, o critério de conclusão da etapa do X — analisar cerca de 20 publicações — não foi atendido no sentido de publicações relevantes. - Foram analisadas 40 publicações, mas zero mencionavam IA de geração de imagem ou vídeo.
output/x.posts.jsoncontém os mesmos dados e não forneceu pistas adicionais.- A única conclusão possível nesta etapa é que, a partir dos termos e publicações coletados, não se pode relatar nenhum desenvolvimento de código fechado ou aberto sobre IA de geração de imagem e vídeo no X. É necessária uma nova coleta com consultas como “Sora 2”, “Midjourney”, “Stable Diffusion”, “Runway Gen”, “Kling AI”, “Flux” e “open source image generation”.
YouTube
YouTube — tendências recentes em IA de geração de imagem e vídeo (código fechado/código aberto)
Canais
Mais voltados a código fechado
- Theo - t3.gg (@t3dotgg) — explicação técnica sobre Google Nano Banana Pro
- Astrovah (@astrovah) — análises e casos de uso do Sora 2
- Woollyfern (@woollyferncreative) — canal especializado em atualizações mensais do Midjourney
- FixNode (@Fixnode1) — tutoriais de Runway Gen-4.5
- Higher E-Learning (@higherelearning) — análise de modelos integrados ao Adobe Firefly
- AIPOD-CAST (@AIPOD-CAST) — resumo semanal de notícias de IA, na faixa do episódio 220
- Lev Selector (@lev-selector) — resumo semanal de atualizações de IA
Mais voltados a código aberto
- Bijan Bowen (@Bijanbowen) — testes locais de Qwen Image
- HitPaw Edimakor (@HitPawEdimakorOfficial) — análises e guias da série Wan
- MaxonShire (@MaxonShire) — comparações de modelos abertos de vídeo
- Promptus AI (@promptusai) — guias de instalação local de novos modelos, como Z-Image
- 黎黎原上啃 / SweetValberry (@SweetValberry) — explicações em chinês sobre FLUX.1 Kontext e outros
Os números de inscritos não puderam ser obtidos nas páginas dos canais, conforme os limites descritos abaixo, portanto a escala de cada canal não pôde ser confirmada.
Vídeos
-
“O Google venceu a geração de imagens (nem chega perto) — ANÁLISE DO NANO BANANA PRO” — Theo - t3.gg / data de publicação desconhecida (o próprio Nano Banana Pro foi anunciado em 20 de novembro de 2025; o vídeo é posterior) / visualizações desconhecidas
https://www.youtube.com/watch?v=UV9GqinedQ8
Afirma que a qualidade de geração de imagem do Nano Banana Pro, baseado no Gemini 3 Pro, está em nível de “não precisar de Photoshop” e se destaca entre os sistemas fechados. -
“Sora 2 — uma análise honesta e 20 casos criativos para experimentar” — Astrovah / 7 de outubro de 2025 / visualizações desconhecidas
https://www.youtube.com/watch?v=pJHWIgri5vk
Avalia o Sora 2 como “o vídeo de IA mais realista até agora” e apresenta 20 formas de utilizá-lo profissionalmente. -
“Atualização do Midjourney | julho de 2026: V8.2 CHEGOU! Personalização, criador de estilos NIJI e mais!” — Woollyfern / julho de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=dvfH5HzCARY
Explica que o Midjourney V8.2 adicionou personalização e um criador de estilos para NIJI. É a edição mais recente de uma série mensal. -
“Testei todos os modelos de vídeo por IA no Adobe Firefly para você não precisar fazer isso (julho de 2026)” — Higher E-Learning / julho de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=nOSYufWVdq8
Testa lado a lado todos os modelos após a integração de Veo 3.1, Kling 3.0, Runway Gen-4.5 e Sora 2 ao Adobe Firefly. -
“Tutorial definitivo de Runway Gen 4.5 para novos usuários em 2026” — FixNode / 29 de março de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=IUge3u4ZrqQ
Explica a geração imagem-para-vídeo do Runway Gen-4.5 em formato de tutorial, enfatizando visual cinematográfico. -
“Episódio 222: resumo semanal de notícias de IA — 6 de setembro de 2026” — AIPOD-CAST / 6 de setembro de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=8f34nSLdNtk
Resumo semanal de modelos, agentes e tendências de negócios que também aborda notícias de IA de geração de imagem e vídeo. -
“Atualizações empolgantes de IA da semana — 18 de setembro de 2026” — Lev Selector / 18 de setembro de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=Utu4zIcqPtM
Canal pessoal que resume de forma ágil as atualizações de IA da semana. É a publicação mais recente do escopo desta pesquisa. -
“Primeiro teste do Qwen Image-2512 — o MELHOR modelo aberto de geração de imagens!” — Bijan Bowen / data de publicação desconhecida (o modelo é da versão de dezembro de 2025) / visualizações desconhecidas
https://www.youtube.com/watch?v=SBaK616nP6Q
Testa localmente o Qwen-Image-2512, da Alibaba, com 20 bilhões de parâmetros, e o avalia como “o modelo aberto de imagens mais forte atualmente”. -
“Análise do Wan 2.6 | Como usar o Wan 2.6 de graça | Tutorial do novo gerador de vídeo por IA” — HitPaw Edimakor / data de publicação desconhecida (modelo lançado em dezembro de 2025) / visualizações desconhecidas
https://www.youtube.com/watch?v=6FMisTHYYgA
Analisa o Alibaba Wan 2.6 e mostra como usá-lo gratuitamente. Menciona diversos modos, como T2V, I2V e R2V. -
“Comparação HunyuanVideo 1.5 vs. Wan 2.7: qual é o melhor modelo local gratuito de geração de vídeo por IA?” — MaxonShire / 25 de junho de 2026 / visualizações desconhecidas
https://www.youtube.com/watch?v=4GNT4-QYekg
Compara diretamente HunyuanVideo 1.5, da Tencent, e Wan 2.7, da Alibaba, lançado em 22 de abril de 2026, dois grandes modelos locais e gratuitos de vídeo. -
“Gerador de imagens aberto Z-Image: gratuito online e configuração local” — Promptus AI / 2026, mês desconhecido / visualizações desconhecidas
https://www.youtube.com/watch?v=JF4Q5hXh-_Q
Apresenta o Z-Image, da Alibaba, com 6 bilhões de parâmetros e arquitetura S3-DiT, como modelo leve que supera Flux 2 e Qwen Image em qualidade, além de explicar sua integração com ComfyUI. -
“FLUX.1 Kontext [dev] é código aberto! Experimente edição local de imagens no ComfyUI” — 黎黎原上啃 / 2025, após o lançamento do Flux Kontext Dev / visualizações desconhecidas
https://www.youtube.com/watch?v=v4pp3TdbWNw
Demonstra edição local de imagens no ComfyUI após a publicação dos pesos do Flux Kontext Dev, da Black Forest Labs. É um vídeo mais antigo, mas foi incluído como contexto para a trajetória da edição de imagens de código aberto.
Sinais
- As soluções fechadas estão transformando atualizações mensais em rotina: a série “Update” do Midjourney, de Woollyfern, publica vídeos mensais e avançou regularmente de V8 para V8.1 e V8.2 em 2026. Canais técnicos também revisam rapidamente grandes atualizações de Runway e Adobe Firefly a cada poucos meses.
- A sincronização de áudio está se tornando recurso padrão de vídeo fechado: Kling 3.0, com diálogo nativo em cinco idiomas; Seedance 2.0, que integra áudio e vídeo e reproduz até reverberação; e Grok Imagine 1.5, que gera falas e sons ambiente ao mesmo tempo, enfatizam o mesmo projeto. O eixo da competição está migrando de gerar imagens em movimento isoladas para produzir curtas com áudio.
- A velocidade de lançamento do código aberto, especialmente chinês, rivaliza ou supera a do código fechado: apenas a linha Alibaba passou rapidamente de Qwen-Image para Qwen-Image-2512 e Z-Image, e de Wan 2.5 para 2.6 e 2.7. Tencent HunyuanVideo 1.5 e LTX-2 → 2.3 → 2.5, da Lightricks, também evoluem em ritmo mensal ou trimestral. Títulos de vídeos usam repetidamente chamadas como “o melhor código aberto” e “derrotar X”, sinalizando alto interesse do público.
- A maioria dos vídeos sobre sistemas abertos enfatiza “ComfyUI”, “execução local” e “gratuito”: canais como HitPaw Edimakor, Promptus AI e MaxonShire destacam como usar sem pagar e rodar em GPU local, em contraste com canais de soluções fechadas, como Theo, Astrovah e Woollyfern, mais voltados a avaliações de qualidade e recursos.
- Canais de notícias semanais de IA, como AIPOD-CAST e Lev Selector, já tratam a geração de imagem e vídeo como segmento recorrente, e não como notícia pontual.
Limites
- A página de resultados do YouTube (
https://www.youtube.com/results?search_query=…) é renderizada dinamicamente em JavaScript. Quando obtida por WebFetch, devolve apenas links de navegação do rodapé; assim, o método previsto pelo playbook de ler título, canal, visualizações e data na página HTML não funcionou. - Como alternativa, vídeos foram encontrados por busca comum na web com consultas
site:youtube.com, e seus títulos e nomes de canal foram confirmados pelo endpointoembeddo YouTube. Esse método não permite obter visualizações nem inscritos, por isso todos os itens foram marcados como desconhecidos, sem estimativas inventadas. - Pelo mesmo motivo, alguns vídeos não têm data precisa confirmada: análise do Nano Banana Pro, teste do Qwen Image-2512, análise do Wan 2.6 e apresentação do Z-Image. Foram registradas somente datas aproximadas a partir de trechos de busca e datas de lançamento dos modelos.
- Descrições e comentários principais também não puderam ser lidos diretamente devido à dependência de JavaScript.
- Foram priorizadas publicações dos últimos 60 dias, a partir de 22 de julho de 2026, mas um ou dois vídeos fora desse período — como Flux Kontext e o tutorial Runway Gen-4.5 — foram incluídos por sua importância contextual para as trajetórias aberta e fechada.
Bluesky
Bluesky — tendências recentes em IA de geração de imagem e vídeo
Contas
- Simon Willison (@simonwillison.net) — pesquisador independente de IA. Sempre que surge um novo modelo multimodal, testa suas capacidades de imagem com seu benchmark de “um pelicano andando de bicicleta”. Cerca de 50 mil seguidores e alta frequência de publicações.
- Max Woolf (@minimaxir.bsky.social) — ex-cientista de dados do BuzzFeed. Tem conhecimento em ética e P&D de geração de conteúdo por IA e publica com frequência sobre lançamentos de modelos de imagem.
- Ethan Mollick (@emollick.bsky.social) — professor da Wharton. Ao abordar tendências de IA em geral, também comenta as mudanças de qualidade na geração de vídeo.
- Replicate (@replicate.com) — conta oficial do serviço de hospedagem de modelos. Anuncia novos modelos fechados de imagem e vídeo quando entram em sua plataforma.
- Stability AI (@stabilityai.bsky.social) — conta oficial da criadora do Stable Diffusion. Porém, as publicações recentes focam em Stable Audio e APIs corporativas de edição de imagens; não há postagens desde 19 de novembro de 2025.
- Stable Diffusion online AI (@stablediffusion.bsky.social) — conta de compartilhamento de prompts e curadoria de arte de IA ligada a SDXL/ComfyUI, com cerca de 1.800 seguidores. Está inativa desde 24 de fevereiro de 2025.
- AI Art News (@ai-art-news.bsky.social) — conta de curadoria de notícias sobre arte de IA. Não publica desde 18 de setembro de 2025.
Publicações
-
Simon Willison (2026-09-19) — em uma sequência que pediu ao GPT-6 Astra e ao Claude Fable 5.1 que criassem modelos 3D para Blender com dados de mapas, apresenta um fluxo de trabalho de geração de imagem para conversão em 3D. 57 curtidas · 5 repostagens.
https://bsky.app/profile/simonwillison.net/post/3mv4su6pfzk24 -
Simon Willison (2026-09-05) — teste em que pediu ao GPT-6 Astra para renderizar no Blender uma cena de um pelicano andando de bicicleta. 405 curtidas · 30 repostagens.
https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s -
Simon Willison (2026-09-04) — grade comparativa do benchmark “pelicano andando de bicicleta”, colocando lado a lado GPT-6 Astra e GPT-5.6 Sol/Terra/Luna. 206 curtidas · 9 repostagens.
https://bsky.app/profile/simonwillison.net/post/3mupxubgrls2c -
Simon Willison (2026-09-02) — gerou com Claude Fable 5.1, no nível Max de raciocínio e a US$ 3,30 por execução, uma imagem SVG de pelicano com a melhor qualidade até então e depois a animou. 362 curtidas · 22 repostagens.
https://bsky.app/profile/simonwillison.net/post/3muimzxo2sk2g -
Max Woolf (2026-09-19) — observou que, ao pedir uma imagem vetorial de “pelicano andando de bicicleta” a uma IA de geração de imagens, ela não entendia a relação entre pernas e pedais. 1 curtida.
https://bsky.app/profile/minimaxir.bsky.social/post/3mvtt3uxdrk2c -
Max Woolf (2026-09-08) — após o anúncio de um novo modelo de imagem da OpenAI, comentou que foi bom ter adiado seu artigo sobre ChatGPT Images 2.0, pois este lançamento parecia mais importante, referindo-se ao ChatGPT Images 2.5. 4 curtidas.
https://bsky.app/profile/minimaxir.bsky.social/post/3muzq6mcadk2n -
Ethan Mollick (2026-09-19) — observa que, em meio à inundação de “slop”, conteúdo barato e massificado de baixa qualidade, começam a aparecer obras realmente interessantes de vídeo por IA. 58 curtidas · 7 repostagens.
https://bsky.app/profile/emollick.bsky.social/post/3mvuss476oc2b -
Replicate (2026-04-21) — anunciou a inclusão do GPT Image 2, da OpenAI, na Replicate, destacando fotorrealismo, renderização de texto e aderência a layout. 5 curtidas.
https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Replicate (2026-04-09) — anunciou que o modelo de vídeo Seedance 2.0, da ByteDance, ficou disponível a todos os usuários. Integra texto, imagem, vídeo e áudio, com áudio estéreo sincronizado e física realista. 2 curtidas · 1 repostagem.
https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Replicate (2026-02-18) — anunciou o lançamento do Gen-4.5, da Runway, modelo de geração de vídeo cinematográfico com precisão física e realismo. 2 curtidas.
https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Replicate (2026-02-17) — anunciou a inclusão de Kling 3.0 e Kling o3, da Kuaishou, com geração 4K multishot, áudio sincronizado, edição de vídeo e transferência de estilo. 2 curtidas.
https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
Replicate (2026-03-11) — anunciou a inclusão do Vidu Q3, da Shengshu, com geração de vídeo de até 16 segundos e 1080p a partir de texto, imagem ou quadros inicial e final, com áudio sincronizado. 1 curtida.
https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w
Sinais
- Predomínio de código fechado: as publicações efetivamente encontradas no Bluesky sobre o tema tratam quase todas de grandes modelos fechados: OpenAI, GPT Image 2 / ChatGPT Images 2.5, Runway Gen-4.5, Kling 3.0, Seedance 2.0 e Vidu Q3. Não são posts orgânicos virais, mas anúncios de novos modelos feitos por hospedadores como a Replicate ou testes de pesquisadores independentes como Simon Willison e Max Woolf.
- Quase não há sinal de código aberto: não foram encontradas contas ativas publicando sobre Flux, Stable Diffusion, Qwen-Image, Wan ou fluxos de trabalho ComfyUI. A única conta comunitária semelhante, stablediffusion.bsky.social, está inativa desde fevereiro de 2025. A conta oficial da Stability AI também está silenciosa desde novembro de 2025, e suas últimas publicações focaram em Stable Audio e APIs corporativas, não em Stable Diffusion de imagem.
- “Pelicano andando de bicicleta” tornou-se benchmark de fato: quando surgem modelos multimodais como GPT-6 Astra e Claude Fable 5.1, diversos observadores independentes usam esse mesmo desafio para comparar qualidade de imagem. É uma tendência interna particular do Bluesky, funcionando como métrica comum informal.
- Ausência de contas corporativas oficiais: identificadores esperados de OpenAI, Midjourney, Runway ML, Black Forest Labs, Hugging Face, Civitai e ComfyUI não existem, estão inativos ou têm zero publicações. Assim, Bluesky não funciona como canal de anúncio primário dessas empresas; as notícias circulam por pesquisadores individuais e plataformas intermediárias como a Replicate.
- Mudança de avaliação sobre geração de vídeo: como sugere Ethan Mollick, cresce a percepção de que, entre o grande volume de vídeo automatizado de baixa qualidade, estão começando a aparecer obras realmente boas. Ainda assim, trata-se de uma observação geral, não ligada a um modelo aberto específico.
Limites
- A API oficial de busca do Bluesky (
https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts) retornou HTTP 403 Forbidden para todas as consultas, mesmo variando palavras-chave e usando dois proxies CORS. A interface web emhttps://bsky.app/search?q=...também é uma SPA renderizada no cliente, cujo conteúdo não pôde ser extraído por WebFetch. - Como alternativa, foram usados os endpoints sem autenticação
app.bsky.actor.getProfileeapp.bsky.feed.getAuthorFeed, recuperando feeds das contas descobertas por busca web ou inferência. Portanto, o resultado não equivale a uma busca transversal por palavras-chave em todo o Bluesky, mas somente às publicações das contas encontradas. - Contas de marcas importantes, como OpenAI, Midjourney, Runway ML, Black Forest Labs, Hugging Face, Civitai, ComfyUI e parte das contas da Stability AI, estavam inativas ou silenciosas, impossibilitando obter notícias diretamente delas.
- Dadas as limitações de busca, não foi possível atingir o critério do briefing de aproximadamente 20 publicações explicitamente relacionadas ao tema. Foram lidas mais de 100 publicações de sete contas e selecionadas as 12 diretamente relevantes.
- As imagens e vídeos em si não foram exibidos ou verificados; a única fonte de informação foram as descrições textuais das publicações.
Lemmy
Lemmy — tendências recentes em IA de geração de imagem e vídeo (fechado/aberto)
Comunidades
- !«メールアドレス» — 5.712 inscritos, sendo 893 locais; 1.407 publicações e 1.927 comentários. Trata de modelos abertos de geração de imagem e vídeo em geral. Tem apenas 10 usuários ativos diários e 66 mensais, mas é atualizada com frequência.
- !«メールアドレス» — 2.362 inscritos; 24 ativos diários, 114 semanais e 344 mensais. Espaço para obras criadas com modelos abertos da linha Stable Diffusion; predominam links diretos para imagens no civitai.
- !«メールアドレス» — 1.598 inscritos, sendo 206 locais. Comunidade de ilustrações de anime criadas por IA baseada em Stable Diffusion, limitada a conteúdo seguro para o trabalho.
- !«メールアドレス» — 8.252 inscritos, sendo 3.027 locais, e 9.179 ativos mensais; a maior comunidade observada. Apresenta-se como “um lugar para todos que detestam IA” e concentra críticas e sarcasmo sobre IA em geral, mais do que sobre geração de imagem ou vídeo especificamente.
- !«メールアドレス» — apenas 52 inscritos, mas replica via RSS discussões do Reddit, como r/ArtificialInteligence, e recebe frequentemente pautas sobre geração de imagem e vídeo. Tem 725 ativos semestrais.
- !«メールアドレス» · !«メールアドレス» · !«メールアドレス» — comunidades gerais de tecnologia. Grandes notícias ligadas ao Midjourney circularam nesses espaços.
Publicações
- Ferramentas ComfyUI para MiniMax-H3 cresceram rapidamente em setembro (código aberto) — em
!«メールアドレス», foram observadas pelo menos 15 publicações de ferramentas para MiniMax-H3, modelo de vídeo, entre 2026-09-01 e 2026-09-16. Exemplos:- “ComfyUI-MiniMaxH3-CLSS” — geração de vídeo com áudio de duração arbitrária em VRAM de 16 GB voltada ao consumidor (pontuação 0, 2026-09-01) https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS
- “H3-World” — afirma ser o “primeiro modelo de mundo interativo do mundo”, baseado em MiniMax-H3 (pontuação 3, 2026-09-02) https://huggingface.co/DANNY621/H3-World
- “ComfyUI-VDN-H3-24GB” — implementação de atenção híbrida para GPUs de 24 GB (pontuação 6, 2026-09-12) https://github.com/Speach1sdef178/ComfyUI-VDN-H3-24GB
- “MiniMax-H3-Image-Training-Adapter” — da Circlestone Labs, pontuação 5, 2026-09-12 https://huggingface.co/circlestone-labs/MiniMax-H3-Image-Training-Adapter
- Boogu-Image-0.1 — novo modelo-base aberto de imagem de laboratório ligado à Huawei (código aberto) —
!«メールアドレス», pontuação 5, 2026-06-17. Licença Apache-2.0, 10 bilhões de parâmetros e cinco variantes: Base, Turbo de 3–4 etapas, FP8 e edições. Destaca renderização de texto bilíngue em chinês e inglês. https://boogu.org/ - Artigo de validação técnica do Seedream 5.0 Pro, modelo fechado ligado à ByteDance (código fechado) — via
!«メールアドレス», pontuação 1, 2026-07-10. Publicação intitulada “uma comparação honesta e análise técnica”. https://www.reddit.com/gallery/1usc03q - Anúncio do Google “Nano Banana 2 Lite” (código fechado) — espelho do Hacker News, pontuação 1, 2026-06-30, com link para a página oficial da DeepMind. Uma publicação de mídia tecnológica suíça em alemão também circulou paralelamente, pontuação 0, em 2026-07-02. https://deepmind.google/models/gemini-image/flash-lite/
- MAI-Image-2.5, da Microsoft, se aproxima do Nano Banana 2 em benchmarks (código fechado) —
!«メールアドレス», pontuação 1, 2026-05-28. Publicação sobre a competição entre modelos de geração de imagem da Google e da Microsoft. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/ - Relato de experimento criando uma história longa com Sora 2 (código fechado) —
!«メールアドレス», pontuação 1, 2026-09-13. O autor começou a usar o modelo aproximadamente um mês após seu lançamento e produziu sete vídeos de uma hora. O principal aprendizado: “não é difícil criar um clipe isolado bonito; o que é realmente difícil é ‘production memory’, manter a consistência”. https://lemmy.durstig.online/post/59922 (Reddit original: https://www.reddit.com/r/ArtificialInteligence/comments/1wfabp9/) - Notícia real de uma grande guinada do Midjourney, de geração de imagens para spa médico (código fechado / movimento corporativo) —
!«メールアドレス», artigo do The Register e crosspost na versão lemmy.zip, pontuação 58–66, 2026-06-18. A empresa teria mudado para o negócio de spa “Golden Light”, com escaneamento corporal inteiro, e a infraestrutura técnica seria emprestada de parceiros; os comentários fizeram comparações sarcásticas com Theranos. https://lemmy.zip/post/66397234 - Midjourney exige que estúdios de Hollywood divulguem uso de IA (código fechado) —
!«メールアドレス», pontuação 73, 2026-07-05. Movimento noticiado no contexto de litígios de direitos autorais. https://lemmy.today/post/56011946 - Apresentação do artigo InterleaveThinker (código aberto / pesquisa) —
!«メールアドレス», pontuação 0, 2026-06-12. Link para o artigo do arXiv “Reinforcing Agentic Interleaved Generation”. https://arxiv.org/abs/2606.13679 - Clima de reação negativa contra conteúdo gerado por IA (sinal social) —
!«メールアドレス», pontuação 923, 2026-09-13. Não trata diretamente de geração de imagem ou vídeo, mas de óculos inteligentes Ray-Ban Meta com IA. Ainda assim, a escala da comunidade, com 9.179 ativos mensais, e a intensidade da reação são evidência indireta do ambiente contrário às IAs de imagem e vídeo. https://lemmy.world/post/51874921
Sinais
- O lado aberto está dominado por MiniMax-H3. Na comunidade
!stable_diffusionde lemmy.dbzer0.com, publicações de nós ComfyUI, LoRAs, quantização e aceleração de VAE para MiniMax-H3 aparecem diariamente na primeira metade de setembro. Nomes de modelos de gerações anteriores, como Wan, Flux e HunyuanVideo, praticamente desapareceram das buscas. O fato de os autores primários serem desenvolvedores individuais, em numerosas contas pessoais no GitHub, também retrata um ecossistema de base centrado em Hugging Face e civitai. - No lado fechado, Google, Microsoft, ByteDance, OpenAI e Midjourney avançam em paralelo, respectivamente com Nano Banana, MAI-Image, Seedream, Sora 2 e Midjourney. No entanto, o volume de menções no Lemmy é pequeno, com pontuações quase sempre de um dígito, e a pauta principal circula via espelhos do Reddit em
!ai_reddit. As menções primárias originadas no Lemmy se concentram em notícias corporativas, como a mudança do Midjourney para spas médicos. - Publicações de obras com links diretos para civitai, em stable_diffusion_art e share_anime_art, são ativas, mas raramente incluem detalhes de modelos ou prompts, permanecendo no nível de material em vez de notícia.
- A comunidade anti-IA
!fuck_aié uma das maiores de todo o Lemmy; quando publicações sobre IA de imagem ou vídeo chegam ali, comentários de oposição tendem a superar conversas equilibradas.
Limites
- O Lemmy tem uma base pequena, e sua API de busca devolve muitos posts antigos, como HunyuanVideo-I2V de março de 2025, e resultados irrelevantes, como matérias sobre a startup de combustível nuclear Fluxnium, pois uma busca por “Flux” traz muito ruído. Foi necessário filtrar manualmente por palavra-chave.
- Foram feitas buscas individuais por
Runway Gen,Kling AIeWan 2.5, mas não foram encontradas publicações diretamente relevantes: Kling retornou zero, Runway retornou zero e Wan trouxe somente material irrelevante. Não foi possível confirmar engajamento próprio do Lemmy para esses modelos. !«メールアドレス»é um bot de republicação RSS do Reddit, não uma discussão original do Lemmy. Este relatório identifica a fonte e utiliza somente insights próprios, evitando repetir a etapa do Reddit.- As notícias sobre a mudança do Midjourney para spa médico e sua exigência de divulgação a Hollywood foram publicadas em 2026-06-18 e 2026-07-05, respectivamente; não são acontecimentos da última semana. Não foram encontrados desdobramentos mais recentes no Lemmy.
- Cerca de 20 publicações foram examinadas, mas apenas a notícia da mudança do Midjourney para spa médico e o post de óculos inteligentes em
!fuck_aitiveram pontuação acima de dois dígitos. Não foi observado grande viralização de tópicos exclusivos de geração de imagem/vídeo no Lemmy.
Pinterest — Notícias de IA de geração de imagem e vídeo
30 das 50 pins coletadas foram abertas e lidas diretamente, todas com imagens incluídas, para redigir este resumo. As 20 restantes — em sua maioria listagens genéricas de fotos de banco sobre “conceito de criação de conteúdo com IA” e gráficos duplicados de listas de ferramentas — não foram abertas porque seus títulos já correspondiam aos temas confirmados abaixo.
Temas visuais
- O template de miniatura do YouTube “AI news” domina: fundo preto ou azul-marinho, rosto humano reagindo, com sobrancelhas erguidas ou rindo, texto branco/vermelho grande “AI NEWS” e uma fileira de logotipos luminosos de marcas como OpenAI, Google, Anthropic, Meta, Microsoft e Notion. Ele aparece repetidamente em temas sem relação entre si, às vezes com título que não corresponde ao conteúdo da imagem: é um template reutilizável de canal, não uma arte feita para cada publicação.
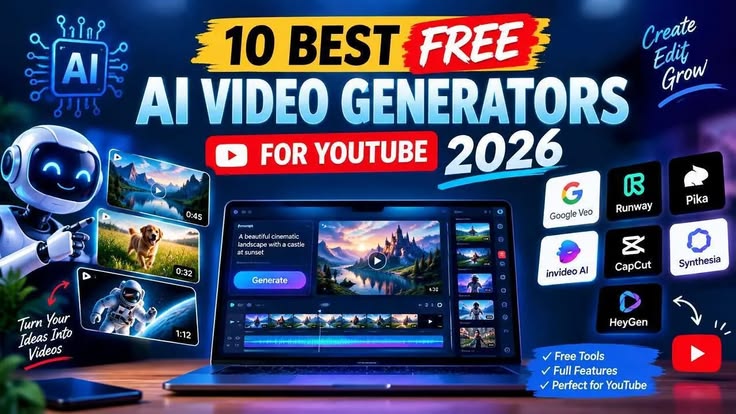
[6, 14, 41, 43, 47] - Listas de ferramentas usam a mesma linguagem de infográfico escuro e neon: emblemas numerados em roxo, laranja e verde-azulado, mockup de notebook com interface de geração e grade de logos concorrentes — Runway, Pika, Kling AI, Luma/Dream Machine, Canva, Hailuo, invideo AI, CapCut, Synthesia e HeyGen. Todas as ferramentas citadas são SaaS de código fechado.
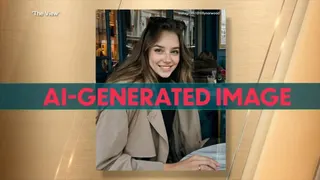
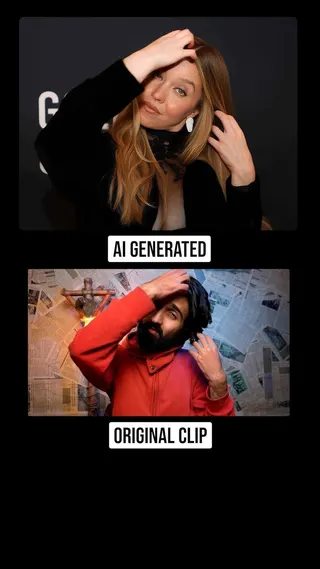
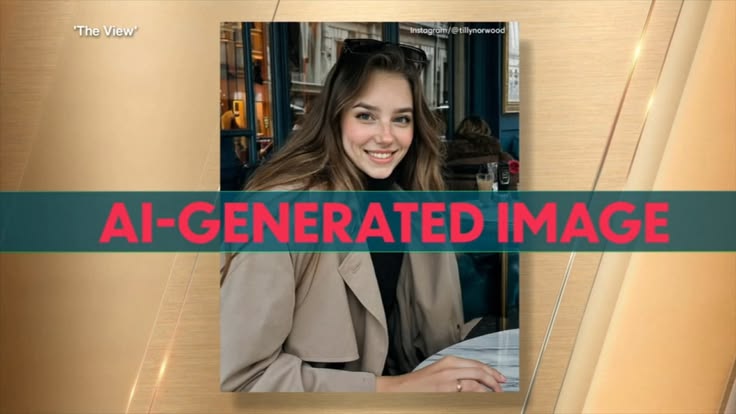
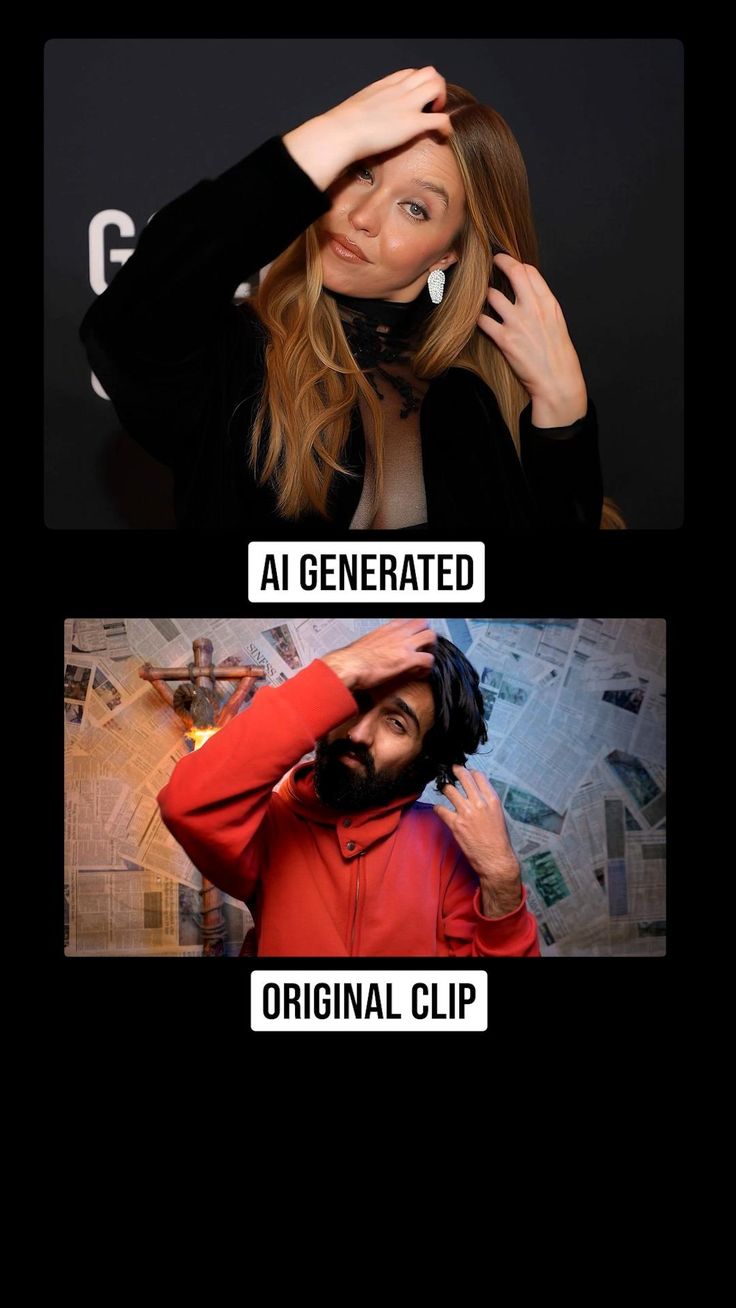
[2, 29] - A ansiedade de autenticidade em “Real vs. IA” é um formato recorrente distinto: quizzes lado a lado do tipo “Qual é IA?”, selos vermelhos “AI-GENERATED” sobre uma foto e comparações em meme de “AI GENERATED / ORIGINAL CLIP”. É um gênero tão comum quanto as próprias miniaturas de notícias.
[3, 21, 32] - O Veo do Google fornece o vocabulário visual padrão para “vídeo de IA cinematográfico”: os mesmos quadros quentes em estilo Pixar — uma garota em uma cozinha, flamingos, uma dançarina sob as estrelas, uma nadadora, uma cientista diante de um microscópio — reaparecem em diversas pins separadas, junto de uma demonstração distinta de imagem-para-vídeo com um monstro de pelúcia para Veo 3. Nenhum concorrente teve sua demonstração repetida tanto.
[8, 9, 13, 27] - Retratos hiper-realistas de IA são usados como imagem-isca genérica, sem relação com o assunto do artigo: rosto enrugado de pescador para anúncio de ferramenta, perfil de mulher com pele brilhante para cartão de resumo de notícias, tríptico de transformação facial para app de novidade. Poros de pele, reflexos nos olhos e profundidade de campo rasa indicam que também são gerados por IA.
[33, 45, 48, 20] - Imagens genéricas de ficção científica e placas de circuito preenchem lacunas onde não há captura de tela real do produto: cérebros de arame brilhante, robô humanoide cromado e executivo diante de painel holográfico de IA. Não carregam valor noticioso, apenas clima.
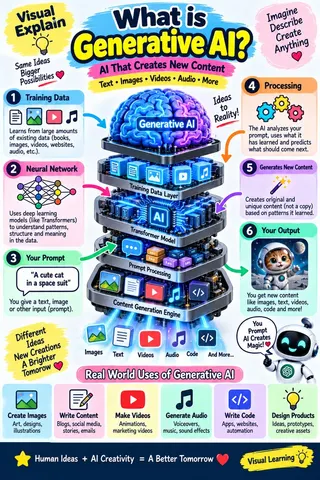
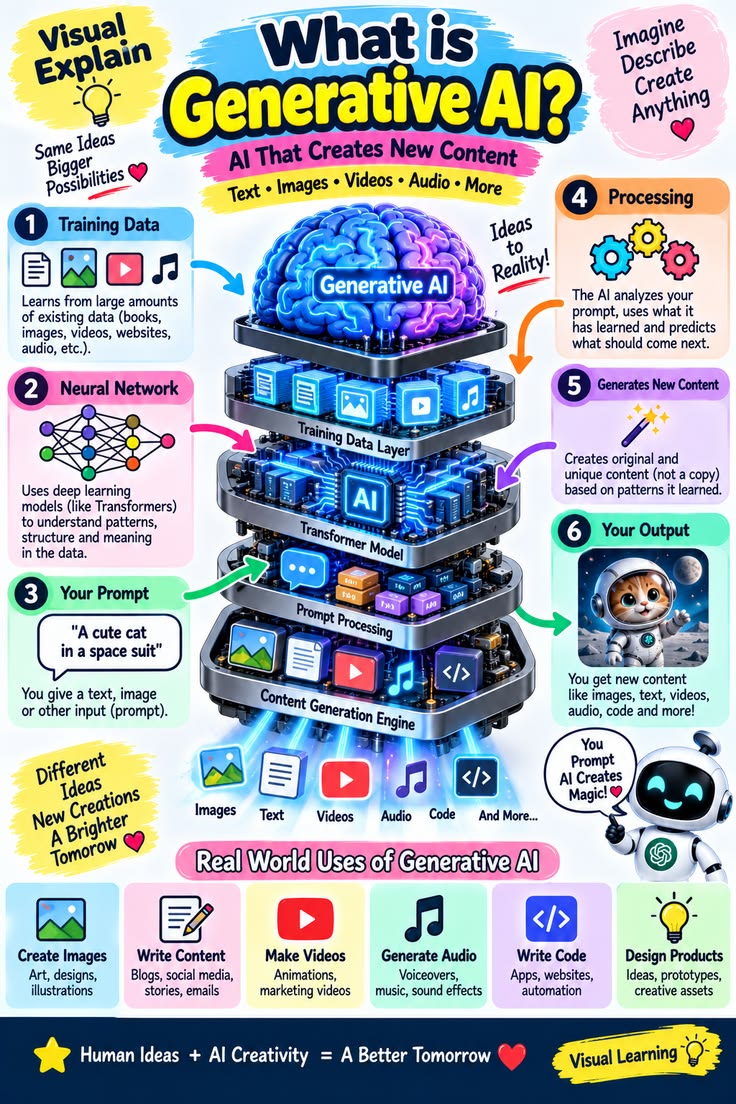
[1, 37, 50] - Infográficos educacionais para iniciantes usam um registro pastel e cartunesco — amarelo e rosa, mascote robô sorridente e setas desenhadas à mão —, em estilo muito mais suave que o das miniaturas de notícias e voltado a quem ainda não sabe o que significa “IA generativa”.
[7] - Diagramas técnicos genuínos são raros: somente uma pin da amostra mostrou uma figura de arquitetura de modelo, de embedding de texto a difusão e upscaling, e mesmo essa foi apresentada como gráfico brilhante de revista, não como ilustração de pesquisa.
[34]
Pins relevantes
- #48 — “Amuse 3.0”, ferramenta de criação de arte com IA (pin) — gerador de imagens da AMD executado localmente, mostrado com retrato hiper-realista; a única ferramenta claramente local ou próxima do aberto encontrada na amostra, em meio a listas de SaaS fechados.
- #27 — Google anuncia IA de geração de vídeo “Veo 3” (pin) — mostra uma imagem de entrada de um monstro de pelúcia e três vídeos gerados em cenas diferentes, apresentando a consistência imagem-para-vídeo do Veo 3 como principal argumento de venda.
- #46 — ByteDance e Hollywood fazem acordo global sobre direitos autorais de IA (pin) — cartão de notícias em estilo Cointelegraph sobre um acordo de propriedade intelectual entre ByteDance e MPA que abrange suas ferramentas de imagem e vídeo, ilustrado com menino gerado em estilo Pixar.
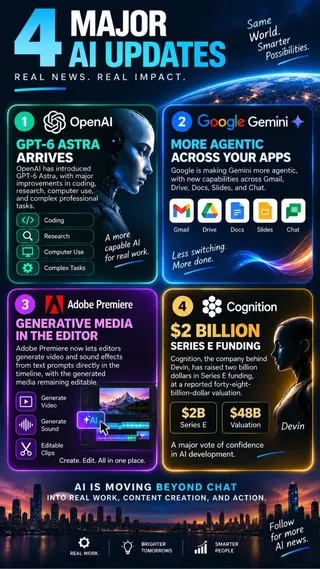
- #10 — “4 grandes atualizações de IA” (pin) — cita GPT-6 Astra, um Gemini mais agentivo, mídia generativa dentro do Adobe Premiere e a Série E de US$ 2 bilhões da Cognition, avaliada em US$ 48 bilhões, em um infográfico.
- #49 — “Notícias de IA de hoje, 20 de maio de 2026” (pin) — resumo do Google I/O: Gemini 3.5 Flash, Gemini Omni, Gemini Spark e impulso para óculos inteligentes com IA.
- #3 — Hollywood Reporter entrevista a primeira atriz de IA (pin) — legenda de TV sobre “Tilly Norwood”, atriz gerada por IA, com o próprio quadro marcado “AI-GENERATED IMAGE”.
- #41 — “Mais de 20% do YouTube agora é gerado por IA” (pin) — pin com chamada estatística sem gráfico de apoio, apresentada como fato.
- #29 — “10 melhores geradores gratuitos de vídeo por IA para YouTube em 2026” (pin) — a lista mais ampla de ferramentas da amostra: Google Veo, Runway, Pika, invideo AI, CapCut, Synthesia e HeyGen, todos apresentados como gratuitos e adequados para YouTube.
- #34 — Ferramenta secreta de geração de imagens da OpenAI será lançada em breve (pin) — chamada sobre uma ferramenta fechada ainda não lançada, ilustrada com um diagrama real, embora estilizado como revista, de pipeline de difusão, e não com imagem de produto.
- #32 — meme comparando “AI GENERATED” e “ORIGINAL CLIP” (pin) — rosto e gesto recriados por IA ao lado do clipe real de origem, parte do gênero contínuo de identificação de autenticidade da plataforma.
Sinais
- Atual: Google Veo, versões 2 e 3, é o modelo de vídeo visualmente mais repetido no painel, mais do que qualquer ferramenta nomeada. “A IA está indo além do chat para o trabalho real” é uma moldura explícita em mais de uma pin, incluindo timelines generativas no Adobe Premiere, financiamento da Devin da Cognition e Gemini mais agentivo em Gmail, Drive e Docs. Acordos de propriedade intelectual e direitos autorais, como ByteDance × MPA, já são pauta de notícias convencionais, não só jurídica especializada. O formato “identifique a IA” e os rótulos de autenticidade constituem um gênero próprio, sinalizando ansiedade real do público sobre imagens falsas e atrizes como Tilly Norwood. Miniaturas genéricas reutilizadas, com o mesmo template de rosto e logos sob manchetes diferentes, sugerem que muito desse “conteúdo noticioso” vem de fábricas de conteúdo de baixo esforço, não de jornalismo original.
- Ausente: a cultura de modelos abertos é quase invisível. Não apareceram Stable Diffusion, Flux, ComfyUI, LoRA nem capturas de tela de repositórios GitHub; Amuse 3.0, a pin #48, foi a única ferramenta local/próxima do aberto na amostra e ainda foi apresentada como app de consumo polido, não projeto aberto. Não surgiram pins em idiomas não ingleses. Nada na amostra reproduz vídeo; tudo são miniaturas estáticas, portanto não é possível avaliar a qualidade real dos resultados, somente as alegações.
Limites
- Conforme o playbook, o Pinterest não foi navegado diretamente. Este resumo foi construído exclusivamente com a tabela pré-coletada do worker em
output/pinterest.pins.mde comimages/pinterest/manifest.json/imagens, todos provenientes de uma única consulta não identificada, “Image and Video Generation AI News”, sem divisão por gênero. O campogenreestá vazio em todas as pins, portanto não foi possível fazer comparação por gênero. - Foram abertas 30 das 50 pins; as outras 20 foram ignoradas porque seus títulos duplicavam formatos já abordados, como listagens genéricas de fotos de banco sobre criação de conteúdo com IA e gráficos repetidos de ferramentas. Trata-se de uma amostragem, não cobertura total do conjunto.
- Vários títulos de pins estão vazios, “(untitled)”, na tabela de origem. Nesses casos, a descrição se baseia no texto visível na própria imagem.
- Em algumas pins, o conteúdo visual não corresponde literalmente ao título, como na #47, cuja imagem é um cartão genérico de canal “AI NEWS”, não algo específico sobre Grok 5. Isso sustenta a conclusão sobre miniaturas genéricas reutilizadas, mas significa que títulos devem ser lidos como indicativos, não como reportagem confirmada.
- Nenhuma pin mostrava data de publicação; a atualidade de alegações noticiosas, como a estatística de que 20% do YouTube seria gerado por IA, não pôde ser verificada apenas pela imagem.
Ações recomendadas
- Refazer a coleta do X com termos diretamente ligados ao tema, como ‘Sora 2’, ‘Midjourney’, ‘Stable Diffusion’, ‘Runway Gen’, ‘Kling AI’ e ‘open source image generation’.
- Monitorar continuamente a frequência de lançamento de projetos chineses abertos, como MiniMax-H3, Qwen, Wan e Z-Image.
- Acompanhar reações em comunidades gerais e profissionais, não apenas em comunidades especializadas em IA, para monitorar a ampliação da reação negativa contra conteúdo gerado por IA.
- Testar meios alternativos de acesso para resolver o problema 403 da API oficial de busca do Bluesky.
- Acompanhar, na próxima rodada, os desdobramentos do problema de “production memory” do Sora 2 e da mudança do Midjourney para spas médicos.
- Adicionar etiquetas de gênero à coleta do Pinterest, permitindo separar mecanicamente aberto e fechado.
Imagens coletadas























Nota sobre a qualidade dos dados
Como os termos de busca do X não tinham relação com o tema, nenhuma das 40 publicações coletadas foi utilizável. Reddit, com 12 itens, e Bluesky, com aproximadamente 12 itens obtidos via contas pessoais devido ao bloqueio da API de busca, também não chegaram à meta de cerca de 20. Pinterest se baseou em dados pré-coletados sem etiquetas de gênero, e YouTube não forneceu visualizações nem números de inscritos.