Notícias de IA para geração de imagens e vídeos — 2026-09-25
As empresas fechadas passam por uma reconfiguração com a rápida disseminação do Seedance 2.5 e o encerramento da API do Sora; enquanto isso, o Qwen-Image-2.1 de 7B, do campo aberto, se aproxima dos maiores modelos fechados. Foi também uma semana marcada por casos em que a designação “código aberto” não corresponde à realidade, como MiniMax H3 e Wan 3.0.
Resumo das notícias de IA para geração de imagens e vídeos — como estão os modelos fechados e abertos agora? — 2026-09-25
Oi! O universo de IA para imagens e vídeos se mexeu muito esta semana, então vamos resumir tudo de uma vez 🔥. Do lado fechado, Seedance 2.5, Nano Banana e o fim do Sora transformaram o cenário numa verdadeira festa 🎉. Mas o lado aberto também está chegando forte: o Qwen-Image-2.1, com apenas 7B de parâmetros, está enfrentando diretamente alguns dos modelos fechados mais poderosos — e, sinceramente, esse é um desenvolvimento muito empolgante 👀. Ao mesmo tempo, há vários casos de “falso aberto”, como MiniMax H3 e Wan 3.0: modelos anunciados como “open source!”, mas presos por licenças restritivas ou limitados a APIs ⚠️. Além disso, no Reddit e no Pinterest continua crescendo a indignação com conteúdo gerado por IA que se infiltra como se fosse real; tecnologia e confiança estão sendo debatidas juntas.
Em todas as plataformas
- Seedance 2.5 (ByteDance, fechado) é um dos protagonistas em todas as plataformas 🎬. Ele aparece no Reddit (explicações sobre técnicas para vídeos longos), X (postagens que processam vídeos-base do MiniMax H3 no After Effects), YouTube (tutoriais para produção em massa de anúncios UGC) e Lemmy. Tudo indica que é hoje o modelo fechado de vídeo que está sendo mais efetivamente usado.
- MiniMax H3 (modelo de vídeo com pesos abertos) passa a impressão de ser “gratuito”, mas não é realmente open source 😅. É assunto no Reddit, X, YouTube e Lemmy, porém uma investigação no YouTube descobriu que sua “MiniMax H3 Community License” é uma licença personalizada que exclui usuários da UE, Reino Unido, Coreia do Sul e Estados Unidos. Muitos são atraídos pelo título “Open-Source”, mas é preciso verificar o que há por trás dele.
- Qwen-Image-2.1 (Alibaba, aberto) enfrenta o Nano Banana 2.0, gigante fechado, com 7B de parâmetros 💪. Tanto no YouTube quanto no Lemmy ele é avaliado positivamente como “pequeno, mas poderoso”, tornando-se um bom exemplo do avanço dos modelos abertos pela eficiência de parâmetros.
- Há uma inflação no uso do rótulo “open source” 📢. Além do MiniMax H3, o Wan 3.0 (Alibaba) também é disponibilizado apenas via API, mas costuma ser confundido com o Wan 2.2 anterior, sob Apache 2.0, como apontou o YouTube. Mesmo no Lemmy, há poucas postagens que separam rigorosamente “aberto” de “fechado”; os rótulos parecem estar à frente dos fatos.
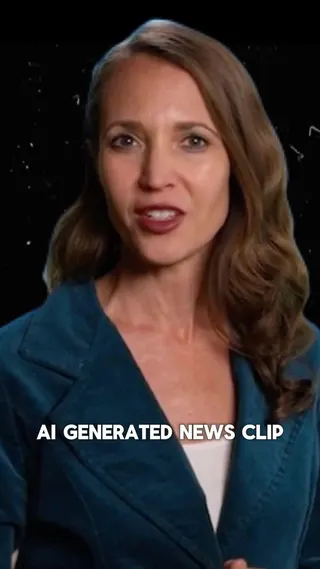
- A indignação com geração por IA que “se infiltra como conteúdo real” é um tema comum em várias plataformas 😤. No Reddit, houve polêmica com manipulação por IA não autorizada em fotos de imóveis, suspeitas de “fabricação científica” no concurso Nikon Small World in Motion e imagens de IA desmascaradas no Instagram. No Pinterest, imagens de “âncoras de notícias falsas” com tarjas no estilo NBC News também são um gênero recorrente. A questão da confiança continua ligada às tendências técnicas.
- O encerramento da API do Sora (OpenAI), em 2026-09-24, revelou uma “lacuna de cobertura” em várias plataformas 🕳️. No Lemmy, a notícia circula junto da informação de que uma concorrente chinesa levantou US$ 3 bilhões, mas a reação é fraca. No YouTube, não foram encontrados vídeos especializados; a atenção já parece ter migrado para ferramentas sucessoras, como Seedance e Wan.
Plataforma por plataforma
Reddit continua recebendo repetidamente perguntas do tipo “quero criar vídeos de IA de alta qualidade de graça”, mas os maiores picos de engajamento foram a indignação com imagens de IA em anúncios imobiliários no r/mildlyinfuriating (27 mil pontos) e a suspeita de fraude científica no concurso Nikon, no r/labrats (1.089 pontos). Há poucas postagens que distinguem claramente modelos fechados e abertos; em geral, limitam-se a listar ferramentas.
X teve sua busca influenciada por um painel de tendências da Croácia, de modo que 32 dos 40 itens eram assuntos sem relação — criptomoedas, futebol e fofoca de celebridades 🙈. Dos oito restantes, quase todos tratavam de fazer Claude Opus 5.5 controlar After Effects, Blender, Unreal ou Godot. A surpresa central não foi a geração em si, mas a ideia de um “agente de IA operando ferramentas existentes”.
YouTube teve poucos canais (sete itens), mas conteúdo denso: canais de cobertura rápida analisando GPT Image 2.5, Qwen-Image-2.1, MiniMax H3 e Seedance 2.5 logo após os lançamentos. Foi o único local a apontar claramente a ambiguidade entre aberto e fechado, incluindo os problemas de licença do MiniMax H3 e do Wan 3.0.
Bluesky teve a API de busca bloqueada com erro 403, impossibilitando pesquisar por palavras-chave 😢. Foi necessário acompanhar individualmente contas encontradas. As novidades fechadas, como anúncios de novos modelos pela Replicate, concentram-se na primeira metade de 2026; já criadores ligados ao código aberto, como ostris, doctordiffusion e a conta oficial da Hugging Face, praticamente pararam de publicar entre 2024 e 2025. Quase não foram encontradas discussões no Bluesky sobre Qwen-Image-2.1 e outros temas de 2026.
Lemmy tem as comunidades ligadas a !stable_diffusion como lar de fato do ecossistema aberto, com foco em integração com ComfyUI e links da HF. Notícias de modelos fechados — fim do Sora e mudança da Midjourney para equipamentos médicos — chegam apenas por crossposts de r/ArtificialInteligence, com pontuações de 0 a 1 e praticamente sem discussão local.
Pinterest teve 20 de 50 pins abertos e verificados. O material encontrado consiste sobretudo em comparativos de aplicativos fechados — Runway, Pika, Kling, Luma, Google/OpenAI — e imagens ligadas à desconfiança em IA; não apareceu sequer um nome de modelo open source ou captura de tela do ComfyUI 📌. A separação solicitada pelo briefing, com dez itens abertos e dez fechados, é impossível com o material do Pinterest isoladamente.
O que acompanhar
- Qwen-Image-2.1 (7B enfrentando os maiores modelos fechados) — YouTube: https://www.youtube.com/watch?v=3qGl0wiv2G0
- Problema de licença do MiniMax H3 (anunciado como “Open-Source”, mas exclui UE/Reino Unido/Coreia do Sul/EUA) — YouTube: https://www.youtube.com/watch?v=XJ4mHfQzZ7I
- Fim da API do Sora e captação de US$ 3 bilhões por uma concorrente chinesa — via Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Suspeita de “realce” por IA no Nikon Small World in Motion (questão de confiança em concurso científico) — Reddit: https://www.reddit.com/r/labrats/comments/1wo0j5e/
- Claude Opus 5.5 controlando diretamente Blender/Unreal/Godot (a “agentificação” da IA generativa) — X: https://x.com/kevin_t_ngo/status/2102761406315839798
- Cláusula de proibição de treinamento por IA no novo filme da DreamWorks, “Forgotten Island” — Reddit: https://www.reddit.com/r/antiai/comments/1wnrfi6/
Recomendações
- Continue acompanhando modelos abertos pequenos, como o Qwen-Image-2.1, e siga individualmente as atualizações de benchmarks.
- Sempre confira o texto da licença antes de classificar como open source um modelo que se apresenta assim; MiniMax H3 e Wan 3.0 são casos típicos.
- Inclua na próxima pesquisa as tendências de migração para serviços alternativos ao Sora, como Seedance, Wan e Kling.
- Nas próximas pesquisas em Bluesky e Pinterest, acrescente buscas por termos próprios como “ComfyUI”, “Hugging Face” e “Flux”, compensando a baixa visibilidade do ecossistema aberto.
- Acompanhe continuamente, sem separar das notícias técnicas, o tema da desconfiança em conteúdo gerado por IA, comum ao Reddit e Pinterest.
- Refaça a pesquisa no X com palavras-chave específicas do tema, sem depender do painel de tendências.
Qualidade dos dados
Em nenhuma plataforma foi atingido o critério de conclusão do briefing, de analisar cerca de 20 itens por rede: Reddit 12 itens; X, 8 itens relacionados ao tema entre 40; YouTube 7; Bluesky, aproximadamente 12 insights extraídos de cerca de 30 posts; Lemmy 12; Pinterest, 20 pins abertos entre 50. No X, 80% do material era irrelevante porque a busca partiu de tendências da Croácia. No Bluesky, a API retornou 403 continuamente, impossibilitando busca transversal por palavras-chave e forçando dependência de contas já encontradas. No Pinterest, a consulta não separava aberto de fechado e o material open source era simplesmente inexistente. Por essas limitações, as notícias mais recentes do lado aberto ficaram especialmente concentradas no YouTube e Lemmy, com pouca confirmação por X, Bluesky e Pinterest.
Resumo por plataforma
Reddit — Notícias de IA para geração de imagens e vídeos
Onde
Distribuição dos 12 tópicos coletados (a única busca usada foi "Image and Video Generation AI News"):
| Subreddit | Número de membros | Tópicos coletados |
|---|---|---|
| r/generativeAI | 156.863 | 5 |
| r/labrats | 726.659 | 1 |
| r/aivideomaking | 7.660 | 1 |
| r/mildlyinfuriating | 12.593.078 | 1 |
| r/Instagramreality | 1.155.761 | 1 |
| r/AIdaily_news | 3.108 | 1 |
| r/aiwars | 169.389 | 1 |
| r/antiai | 338.300 | 1 |
O r/generativeAI é, na prática, o centro das “notícias” (cinco itens), mas a maior parte do conteúdo são perguntas sobre serviços gratuitos de geração de vídeo. Por outro lado, os maiores picos não surgiram em comunidades especializadas ou favoráveis à IA, e sim no r/mildlyinfuriating, uma grande comunidade geral com 12,59 milhões de membros, e no r/labrats, comunidade de pesquisadores; em ambos, o tema foi a indignação com conteúdo criado por IA.
O que as pessoas dizem
- #1 r/generativeAI · 37 pontos · 36 comentários · 2026-09-22 (link) — Um desenvolvedor independente promoveu o serviço de geração de imagens, vídeos e textos “Locally Uncensored”, anunciado como “sem censura”. As reações foram céticas. u/No_Laugh_3115 fez a pergunta essencial: se os modelos upstream forem atualizados, a parte “uncensored” provavelmente será a primeira a piorar; como lidar com isso? O serviço faz fine-tuning próprio ou apenas envolve pesos abertos?
- #2 r/labrats · 1.089 pontos · 131 comentários · 2026-09-23 (link) — O vídeo vencedor do Nikon Small World in Motion deste ano teria sido “realçado e colorizado” por IA, com estruturas biologicamente impossíveis aparecendo e desaparecendo. u/Barkinsons (618 pontos) resumiu: “Ferramentas de IA não têm lugar em imagens científicas de microscopia. Temos a obrigação de reproduzir imagens o mais fielmente possível, não de deixá-las mais bonitas.” u/holydiver18 (53 pontos) criticou duramente a resposta da organização: “Isso é claramente fraude.”
- #3/#9/#11/#12 r/generativeAI · r/aivideomaking (16/2/0/4 pontos, respectivamente; 2026-09-19 a 22) — Quatro tópicos independentes perguntam como criar vídeos de IA de graça, demonstrando ser a necessidade mais frequente no Reddit. A resposta recorrente é que não existe combinação de realmente gratuito, alta qualidade e sem marca d’água; o bot Jenna_AI repetiu esse mesmo argumento em #9, #11 e #12. Ferramentas mencionadas: FramePack, ComfyUI, Grok (US$ 10/mês), Venice, Nanobanana/Veo via Google Flow, Muse (Meta) e dreamfort.ai.
- #4 r/mildlyinfuriating · 26.766 pontos · 719 comentários · 2026-09-21 (link) — De longe a maior pontuação da coleta. O tema foi a revolta com a inclusão não declarada de “imagens de inspiração” geradas por IA em fotos de anúncios imobiliários. u/slothboy (5.749 pontos) observou que transformar aquela sala de jantar em banheiro seria um projeto de cinco dígitos. u/BojackWorseman13 (1.138 pontos) propôs que a imagem deveria identificar em letras grandes que foi gerada por IA.
- #5 r/generativeAI · 7 pontos · 31 comentários · 2026-09-23 (link) — Uma explicação prática de u/kaboom-o (2 pontos) sobre vídeos longos foi útil: ninguém cria vídeos longos em uma única tomada; o roteiro é separado em lista de planos, cria-se uma pilha de clipes de 5 a 15 segundos e depois tudo é editado. Para manter expressões faciais por mais tempo, recomenda Seedance 2.5 — até cerca de 30 segundos, com áudio nativo; para esboços de movimento, Grok Imagine Video — 480p e 5 segundos; e, para qualidade fotográfica, Gemini Omni Flash.
- #6 r/Instagramreality · 2.206 pontos · 351 comentários · 2026-09-18 (link) — Um tópico apontando que uma imagem gerada por IA, muito elogiada no Reddit, era falsa. u/Smart-Membership-117 (427 pontos) notou diferenças no rodapé ao lado do joelho entre as fotos 2 e 3, além de a vegetação fora da janela ter mudado completamente. u/Habibti-Mimi81 (154 pontos) reagiu: “Sinceramente, eu não teria percebido. É uma época triste e perigosa.”
- #7 r/AIdaily_news · 0 pontos · 12 comentários · 2026-09-24 (link) — Um tópico relembrando vídeos de IA que chamaram atenção em 2024. O comentário curto de u/Erosion139 (1 ponto) é simbólico: “Era a época em que a IA ‘sonhava’”, com nostalgia dos artefatos estranhos daquele período.
- #8 r/aiwars · 0 pontos · 144 comentários · 2026-09-24 (link) — Debate intenso sobre um clipe de animação criado por uma pessoa por US$ 13 com Seedance 2.5. O autor celebra uma época em que se pode produzir trabalho de nível profissional sem se tornar animador, mas u/GameMask (4 pontos) rebate que o próprio fato de custar US$ 13 é constrangedor e não representa progresso para a indústria de animação. u/Onionadin (7 pontos) foi além, criticando o entusiasmo com uma maior capacidade de enganar pessoas.
- #10 r/antiai · 18.115 pontos · 623 comentários · 2026-09-23 (link) — A comunidade anti-IA comemorou a notícia de que a DreamWorks acrescentou ao novo filme “Forgotten Island” um aviso proibindo treinamento de IA. u/SlowlyDyingInAPit (2.561 pontos), no comentário principal, ponderou que é ótimo, mas os entusiastas de IA provavelmente ainda usarão a obra para criar conteúdo ruim e tenderão a querer fazê-lo ainda mais se for proibido. u/Arckanoid (143 pontos) analisou o objetivo jurídico: não é apenas impedir o uso, mas criar base para processos.
Sinais
- Presença do ecossistema open source/local: ComfyUI, FramePack, Seedance 2.5 e Minimax H3 aparecem repetidamente em vários tópicos como modelos locais ou de baixo custo. Em especial, a resposta de kaboom-o no item #5 é valorizada como conhecimento prático de “alternar entre modelos”.
- Modelos fechados são descritos como uma experiência fragmentada: diante da proliferação de serviços como Grok, Veo, Nanobanana, Runway, Luma, Kling, Hailuo e Pixverse, a ideia de que não é possível ter simultaneamente gratuidade, alta qualidade e ausência de marca d’água já se consolidou. O comentário padronizado do bot Jenna_AI aparece em três tópicos (#9, #11, #12).
- O conflito se intensifica em torno da possibilidade de detectar: em #6, do Instagramreality, e #2, sobre Nikon, a indignação é voltada a conteúdo de IA ser consumido como real. Já #8, em aiwars, expõe o choque direto entre quem vê a democratização como algo positivo e quem vê uma ferramenta de engano.
- Ponto surpreendente: um vídeo com “realce” por IA — na prática, fabricação — ganhou o grande prêmio do prestigioso concurso científico Nikon Small World in Motion, e a organização reagiu de forma defensiva. A comunidade científica respondeu com extrema severidade; não é uma simples disputa sobre “arte de IA”, mas uma questão de ética em pesquisa.
- O que é minimizado ou já provoca cansaço: pedidos por vídeos de IA gratuitos e de qualidade (#3, #9, #11, #12) chegam repetidamente à mesma conclusão: alguém precisa pagar pela eletricidade e pelas GPUs. Dentro da comunidade, o assunto parece já estar gasto.
Limites
- A busca usou apenas
"Image and Video Generation AI News"; não foram feitas consultas alternativas, como nomes individuais de modelos abertos ou serviços fechados. Foram coletados só 12 tópicos, abaixo da meta de aproximadamente 20 postagens por rede social. - Nos tópicos #6, do r/Instagramreality, e #7, do r/AIdaily_news, o texto inicial das postagens não estava incluído nos dados coletados; o conteúdo foi inferido apenas pelos comentários principais.
- A coleta ficou inteiramente concentrada em subreddits de língua inglesa; nenhum tópico em japonês ou outra língua foi coletado, apesar de o briefing estar em japonês.
- Poucos tópicos discutem claramente “código fechado” e “código aberto”; a maioria apenas lista ferramentas de ambos os tipos. Os dados do Reddit isoladamente não são suficientes para separar rigorosamente as dez tendências abertas e as dez fechadas solicitadas pelo briefing.
X
X — A tomada agentiva de ferramentas criativas pelo Claude Opus 5.5 é o único sinal de IA de imagem/vídeo nesta janela
Origem desta lista
O painel Explore do X que forneceu os termos de busca estava geolocalizado na Croácia (output/x.posts.md, “What X says is happening”): seis das dez tendências diziam explicitamente “Trending in Croatia”, e as demais eram tendências genéricas de Esportes, Música, Negócios e Tecnologia. Trata-se de uma visão local croata do X, não global. Só dois dos dez termos — “Opus 5.5” e “Claude” — tocavam em IA para geração de imagens e vídeos; os outros oito ($song, Serbia, Taylor, Cardano, Croats, Croatia, NFTs, England) eram conversas sem relação sobre criptomoedas, futebol, fofoca de celebridades e geopolítica. Consulte ## Limites para entender o impacto disso na cobertura.
Contas
Todos os que postaram sobre o tema aparecem uma única vez, com uma exceção:
- @KanaWorks_AI (KANA|東京AI映像) — a única conta recorrente, com dois posts (150 + 335 curtidas). É uma conta de “vídeo com IA” baseada em Tóquio; ambas as postagens tratam de usar Claude Opus 5.5 para controlar engines de jogos, primeiro Unreal e depois Godot.
- @kevin_t_ngo (Kevin Ngo) — um post, mas o maior alcance do conjunto: 3.480 curtidas e cerca de 236.000 visualizações, sobre uma animação Python/Blender renderizada por Claude Opus 5.5.
- @developedbyed (Dev Ed) — um post, 1.071 curtidas e cerca de 70.000 visualizações. Uma conta conhecida de educação em desenvolvimento realizando uma comparação de animação “OPUS 5.5 vs GPT 6 Astra”.
- @ring_hyacinth — um post, 712 curtidas e cerca de 44.000 visualizações. Um criador individual relatando um experimento pessoal: transformar um curta antigo em jogo de pixel art.
- @aicreataro — um post, 444 curtidas e cerca de 45.000 visualizações. Uma conta de criador de IA que publicou um registro estruturado de teste, com clipe-base e operações no After Effects.
- @seiiiiiiiiiiru (SEIIIRUAIを使う映像クリエイター) — um post, 163 curtidas e cerca de 7.900 visualizações. Conta japonesa de criador de vídeos com IA, identificada pela própria ferramenta que usa.
- @ponzponz15 (ぽんず) — um post, 212 curtidas e cerca de 32.000 visualizações. Criador japonês documentando uma técnica específica de edição.
Assim, há uma conta dedicada a vídeos de IA que postou duas vezes e seis criadores individuais que publicaram uma demonstração ou teste de alto engajamento cada. Nenhuma conta é veículo de notícias ou publicação do setor; tudo é conteúdo em primeira pessoa, do tipo “eu experimentei isso”.
Postagens
-
@developedbyed (1.071 curtidas · 26 reposts · 35 respostas · ~70.000 visualizações · 2026-09-23) — https://x.com/developedbyed/status/2102789774461280370
OPUS 5.5 vs GPT 6 Astra Loss Screen Animation
Uma comparação direta de animações, modelo contra modelo, publicada por uma grande conta voltada a desenvolvedores — o mais próximo de conteúdo de benchmark “fechado versus fechado” deste conjunto. -
@kevin_t_ngo (3.480 curtidas · 167 reposts · 81 respostas · ~236.000 visualizações · 2026-09-23) — https://x.com/kevin_t_ngo/status/2102761406315839798
Thank you @claudeai ! GIF animated in Python and rendered in Blender by Claude Opus 5.5
A postagem de maior engajamento de toda a coleta de 40 posts ligados ao tema. O sinal é de surpresa genuína com um LLM capaz de controlar um renderizador 3D de ponta a ponta, e não somente gerar uma imagem estática. -
@ring_hyacinth (712 curtidas · 81 reposts · 51 respostas · ~44.000 visualizações · 2026-09-23) — https://x.com/ring_hyacinth/status/2102865595675050010
Opus 5.5 is really amazing! I sent the short film Pixel Shanghai that I made a year ago to Opus 5.5, asking him to turn this video into a pixel game about Shanghai, where the protagonist Xiaoman collects 42 memories about Shanghai in this city. The scenes use the pixel [text cut off by X]
Conversão de vídeo em ativo de jogo: uso do Opus como camada de direção criativa sobre filmagem existente, e não como gerador do zero. -
@aicreataro (444 curtidas · 66 reposts · 7 respostas · ~45.000 visualizações · 2026-09-23) — https://x.com/aicreataro/status/2102656273112326609
Opus 5.5にAfter Effectsを操作させて、AI動画を加工するテスト。■ベース MiniMax H3で15秒を1本 ■AEでやらせたこと ・カットの切れ目を拍に合わせて速さを調整 ・区間ごとにエフェクトを1つずつ(粒子/光線/万華鏡/データモッシュなど)■わかったこと [cut off]
Nomeia um modelo real de geração de vídeo como camada de base — MiniMax H3, em um clipe de 15 segundos — enquanto Opus 5.5 faz a pós-produção no After Effects. É um detalhe concreto de pipeline entre aberto e fechado. -
@KanaWorks_AI (335 curtidas · 39 reposts · 16 respostas · ~18.000 visualizações · 2026-09-24) — https://x.com/KanaWorks_AI/status/2102955708321062975
Claude Opus 5.5 × Godotで3Dゲーム開発。Godotでゲームを作るのは、Unityより少し手軽に感じる。動作も軽くて、仕上がりもかなりいい感じ
O segundo post da mesma conta mostra que não é algo isolado: ela conduz uma pequena série testando Opus 5.5 com diferentes engines. -
@KanaWorks_AI (150 curtidas · 16 reposts · 11 respostas · ~8.300 visualizações · 2026-09-24) — https://x.com/KanaWorks_AI/status/2103138051165933661
Claude Opus 5.5 × Unreal まさか、自分でこんなARPGを作れる日が来るなんて思ってもいませんでした。コントローラーを握って、キャラクターを走らせて、ローリングして、剣を振る。実際に動かしてみた瞬間、心臓がドキドキして、手のひらは汗びっしょり。
Reação emocional e em primeira pessoa à criação, pelo Opus 5.5, de um ARPG jogável no Unreal Engine. É enquadrado como conquista pessoal, não como anúncio de produto. -
@ponzponz15 (212 curtidas · 17 reposts · 7 respostas · ~32.000 visualizações · 2026-09-24) — https://x.com/ponzponz15/status/2102931824918106499
3Dカメラ×立体テキスト演出② After Effectsで作るような編集がClaude OpusやCodexでも可能に。上 Seedance 2.5 prev 下 Codex + Hyperframes skill #dreaminacpp
Cita mais elementos de geração e ferramentas — Seedance 2.5 e uma habilidade Codex + “Hyperframes” — encadeados com Claude para criar motion graphics no estilo After Effects. -
@seiiiiiiiiiiru (163 curtidas · 23 reposts · 9 respostas · ~7.900 visualizações · 2026-09-24) — https://x.com/seiiiiiiiiiiru/status/2103227982592831846
AI広告動画 → AI音声 × AI編集 もうここがゴール地点ってことでいいでしょ。笑 Cluad Opus 5.5にGemini 3.8 Flash TTSでナレーション生成させて、その音声に合わせた動画をそのままClaudeでAEやその他ツールを操作して作りました。
Um pipeline completo para anúncio em vídeo: Gemini 3.8 Flash TTS gera a narração, e Claude Opus 5.5 orquestra o After Effects para sincronizar a edição com a faixa de voz.
Sinais
- Em ascensão: a conversa no X não é “digite um prompt e receba imagem/vídeo”; é Claude Opus 5.5 atuando como agente que opera software criativo existente — After Effects, Blender, Unreal e Godot — sobre clipes ou ativos produzidos em outros lugares. Todos os posts relevantes tratam isso como a parte nova e empolgante, não a etapa de geração.
- Em ascensão: um padrão de encadeamento, em que um modelo especializado produz a saída bruta — MiniMax H3, Seedance 2.5 ou Gemini 3.8 Flash TTS — e Opus 5.5 faz montagem, pós-produção e direção. Dois posts, de @aicreataro e @ponzponz15, citam explicitamente o gerador upstream.
- Surpresa: o post de maior engajamento, de @kevin_t_ngo, com cerca de 236.000 visualizações, não trata de qualidade visual, mas de um LLM controlar o Blender de ponta a ponta. A reação é sobre capacidade e agência, não fidelidade visual.
- Ausente ou descartado: não houve menções a Midjourney, Stable Diffusion, Flux, Sora, Runway, Kling, nem enquadramento explícito de “open source versus closed source” em qualquer item retornado pelo X nesta janela. Qualquer enquadramento posterior nesse sentido será inferência, não citação direta do X.
Limites
- Os termos de busca vieram da lista de tendências do X, não do tema. Os dez termos do coletor saíram diretamente do painel Explore do X, geolocalizado na Croácia. Apenas “Opus 5.5” e “Claude” se relacionavam a IA para imagem/vídeo; os outros oito produziram postagens de cripto, futebol, celebridades e disputas políticas balcânicas: 32 dos 40 posts coletados, nenhum aproveitável para este briefing.
- Abaixo da meta de cerca de 20 posts. Apenas oito dos 40 posts eram relevantes, abaixo do critério de conclusão. Não há mais material no arquivo coletado; a lacuna é de cobertura, não de leitura.
- Sem posts diretos sobre aberto versus fechado. Nada coletado usa esse enquadramento explicitamente; a separação é inferida pelas ferramentas citadas — Claude Opus 5.5 e Gemini 3.8 Flash TTS são fechados, enquanto o licenciamento de MiniMax H3 e Seedance 2.5 não foi declarado nos posts.
- Vários textos estão truncados no ponto em que a coleta do X os cortou, incluindo @aicreataro e @ring_hyacinth; o texto completo não estava disponível em
output/x.posts.mdououtput/x.posts.json. - Só apareceram posts em inglês e japonês; não houve cobertura de comunidades de criadores em chinês, coreano ou outras línguas ativas no X.
YouTube
YouTube — Notícias de IA para geração de imagens e vídeos (código fechado / código aberto)
Canais
Os números de inscritos não puderam ser obtidos diretamente, pois a página de resultados do YouTube é renderizada por JavaScript; são informados somente os dados recuperados por oEmbed e busca na web.
- AI WITH Rithesh (RitheshSreenivasan, pouco mais de 10 mil inscritos e mais de 1 milhão de visualizações acumuladas) — Canal indiano de educação em IA. Analisou tanto ChatGPT Images 2.5, da OpenAI, quanto Qwen-Image-2.1, da Alibaba, logo após os lançamentos; é um dos poucos que acompanha os dois lados.
- Astrovah (@astrovah) — Canal de ferramentas de IA voltado a criadores, com vídeo de “análise honesta” do GPT Image 2.5.
- REBEL AI (@realrebelai) — Publicou demonstração de acesso antecipado ao Qwen-Image 2.1; formato de vitrine de modelo aberto de imagem.
- Adrian Viral AI Marketing (@AdrianViralAIMarketing) — Canal comparativo para profissionais de marketing com IA, ranqueando modelos novos fechados e abertos.
- Miko (@MikoxAI) — Canal de tutoriais para produção em massa de anúncios UGC com modelos fechados de vídeo, como Seedance 2.5.
- jingchen573 — Especializado em execução local com ComfyUI e responsável por uma cobertura rápida dos pesos abertos do MiniMax H3.
Vídeos
-
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — AI WITH Rithesh — por volta de 2026-09-20, logo após o lançamento do Qwen-Image-2.1 — https://www.youtube.com/watch?v=3qGl0wiv2G0
Analisa o Qwen-Image-2.1, modelo de imagem com pesos abertos lançado pela Alibaba em 2026-09-20, com gerador de apenas 7B de parâmetros, e afirma que ele alcança benchmarks comparáveis ao Nano Banana 2.0 fechado, do Google. -
Qwen-Image 2.1 | Early Access Showcase — REBEL AI — fim de 2026-09 — https://www.youtube.com/watch?v=tP_gGGJzEqg
Demonstra exemplos criados com acesso antecipado ao modelo e destaca a capacidade de gerar e editar imagens transparentes em um único modelo. -
[ComfyUI] Breakthrough Release: MiniMax H3, the New Leading Open-Source Video Model — jingchen573 — por volta de 2026-08-03, data de disponibilização dos pesos abertos do MiniMax H3 — https://www.youtube.com/watch?v=XJ4mHfQzZ7I
Cobertura rápida da publicação do MiniMax H3 no Hugging Face, incluindo instalação no ComfyUI. O modelo tem 33 bilhões de parâmetros, é omnimodal, suporta até 2K/24 fps e áudio estéreo nativo. O título diz “Open-Source”, porém a licença real é personalizada e exclui UE, Reino Unido, Coreia do Sul e Estados Unidos. -
ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! — AI WITH Rithesh — por volta de 2026-09-10, dois dias após o lançamento — https://www.youtube.com/watch?v=LYUr4BY33h4
Teste do ChatGPT Images 2.5, lançado pela OpenAI em 2026-09-08, com redução de até 50% na latência e o recurso “Sketch”. -
GPT Image 2.5 - Creative Use Cases You've Probably Missed And A Honest Review — Astrovah — por volta de 2026-09-21 — https://www.youtube.com/watch?v=_S71zN5tgQY
Uma “análise honesta” que explora usos menos óbvios, mas práticos, do modelo. -
I Ranked Every New AI Video Model (Omni 1.1, Seedance 2.5, H3 Max, Wan 3.0, Flux 3, Grok) — Adrian Viral AI Marketing — fim de 2026-08, cerca de um mês antes — https://www.youtube.com/watch?v=4BoTXsJrxQ4
Ranqueia lado a lado Gemini Omni 1.1, Seedance 2.5 e Grok — fechados — com Wan 3.0 e Flux 3, incluindo modelos frequentemente confundidos com abertos. É um vídeo sobre qual ferramenta usar agora, misturando os dois grupos. -
Seedance 2.5 + Grok Bot = 50 Viral AI UGC Ads a Day (Full Tutorial) — Miko — 2026-08-22 — https://www.youtube.com/watch?v=mcY7ReDNrd0
Tutorial prático que combina Seedance 2.5 e Grok, ambos fechados, para produzir anúncios UGC em escala. É um caso típico de criador individual explorando APIs fechadas em um pipeline comercial.
Sinais
- A fronteira entre aberto e fechado está ficando ambígua: há muitos títulos de vídeo chamando MiniMax H3 de “Open-Source”, embora sua licença exclua EUA, UE, Reino Unido e Coreia do Sul. Vários vídeos não diferenciam pesos abertos de software realmente aberto e livremente utilizável.
- Wan 3.0 também “não é aberto”: a versão mais recente da série Wan da Alibaba, Wan 3.0, disponibilizada por API por volta de 2026-08-06, não teve pesos publicados no Hugging Face nem no GitHub. Vídeos comparativos a confundem com Wan 2.2, sob Apache 2.0, facilitando a falsa impressão de que toda a família Wan é open source.
- Modelos abertos enfrentando gigantes com 7B: Qwen-Image-2.1, com gerador de apenas 7B de parâmetros, é considerado comparável ao Nano Banana 2.0 fechado. A eficiência de parâmetros fortalece a narrativa do campo aberto.
- O lado fechado se diferencia pela UX de edição, como “Sketch”: no GPT Image 2.5, as análises se concentram menos na qualidade bruta da geração e mais na conversão de rascunho em imagem com
@Sketche na consistência de edição em múltiplas interações. A disputa está migrando de geração simples para fluxos de edição. - A geração de vídeo acelera a formação de cadeias de ferramentas: tutoriais como Seedance 2.5 + Grok, de Miko, mostram como combinar APIs fechadas para produzir anúncios UGC em massa. O interesse está passando da comparação de modelos isolados para a combinação de vários modelos com fins de monetização, em consonância com o que apareceu no X.
- OpenAI Sora é uma zona vazia de cobertura: a API do Sora foi encerrada em 2026-09-24, um dia antes desta pesquisa, mas não foram encontrados no YouTube vídeos especializados sobre o encerramento. A atenção dos criadores parece já estar em ferramentas substitutas como Seedance, Wan e Kling.
Limites
- A página de resultados do YouTube (
youtube.com/results?...) é renderizada por JavaScript, então WebFetch não conseguiu obter diretamente a lista de vídeos, títulos, visualizações e datas. Como alternativa, foram combinados WebSearch comsite:youtube.come a API oEmbed do YouTube; títulos e canais foram confirmados por oEmbed, enquanto datas foram estimadas a partir de referências relativas nos snippets. - As visualizações e números de inscritos não puderam ser obtidos para a maior parte dos vídeos. O oEmbed não retorna visualizações e os snippets frequentemente não exibem números; por isso, a seção “Vídeos” não inclui esses dados.
- Muitas datas de publicação são estimativas, não datas exatas, calculadas a partir de expressões como “n dias atrás” ou “n semanas atrás”, tendo 2026-09-25 como referência.
- A meta de analisar cerca de 20 publicações não foi atingida rigorosamente. Foram reunidos sete vídeos — dentro da faixa de 5 a 12 do playbook, mas abaixo do critério usado para outras plataformas — porque a página de resultados não pôde ser coletada diretamente.
- Não foi encontrado vídeo especializado sobre o fim da API do Sora em 2026-09-24. A notícia foi coberta rapidamente por blogs e sites, mas pode estar oculta sob vídeos sobre ferramentas substitutas.
- Os comentários não foram analisados. A verificação ficou limitada a títulos e descrições, pois as páginas de vídeo não puderam ser obtidas.
Bluesky
Bluesky — Notícias recentes de IA para geração de imagens e vídeos
Contas
- replicate.com (Replicate) — Anuncia novidades de modelos via API, sejam fechados ou abertos. É a única conta que publicou novidades de IA para geração de imagens e vídeos de forma realmente ativa em 2026.
- ostris.com (Ostris / desenvolvedor do AI-Toolkit) — Divulga fine-tuning LoRA para modelos com pesos abertos, como FLUX, Flex e Wan2.1. Não publica desde abril de 2025.
- doctordiffusion.bsky.social — Criador de “Absynth”, derivado de Stable Diffusion 3.5, e também publica sobre treinamento LoRA para HunyuanVideo. Sem atualizações desde março de 2025.
- reach-vb.hf.co / hf.co (Hugging Face e equipe oficial) — Apresentam Spaces de modelos abertos. A última postagem relacionada a geração de imagens/vídeos é de dezembro de 2024.
- simonwillison.net — Pesquisador independente de IA. Não é especializado em geração de imagens, mas publica sobre recursos multimodais de LLMs de fronteira e continua ativo em setembro de 2026.
- midjourneynews.bsky.social — Conta de fã/comunidade que publica experiências de prompts para Midjourney. Tem baixo engajamento, mas postou esporadicamente até junho de 2026.
Postagens
Modelos fechados
-
GPT Image 2 (OpenAI) adicionado à Replicate — “Fotorrealismo excepcional e renderização de texto nítida, com forte aderência a layouts, interfaces e casos de uso de design.”
2026-04-21|5 curtidas · 0 reposts|https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Seedance 2.0 (ByteDance) liberado para todos os usuários — Integra texto, imagem, vídeo e áudio; gera vídeo de qualidade de estúdio com áudio estéreo sincronizado e simulação física.
2026-04-09|2 curtidas · 1 repost|https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Artigo de testes do Seedance 2.0 — “Passamos bastante tempo com Seedance 2.0. Veja o que descobrimos.”, com link para o blog da Replicate.
2026-04-15|1 curtida · 0 reposts|https://bsky.app/profile/replicate.com/post/3mjkkogr7nd2f -
Vidu Q3 chega à Replicate — Geração de vídeo a partir de texto, imagem e frames inicial/final; até 16 segundos em 1080p, com sincronização de áudio.
2026-03-11|1 curtida · 0 reposts|https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w -
Lançamento do Runway Gen-4.5 — Promete “precisão física e realismo sem precedentes” em uma nova geração de vídeo.
2026-02-18|2 curtidas · 0 reposts|https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Kling 3.0 / o3 adicionados à Replicate — Geração em 4K com múltiplos planos, sincronização de áudio, até 15 segundos, edição de vídeo e transferência de estilo.
2026-02-17|2 curtidas · 0 reposts|https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
GPT-6 Astra + Blender cria um pelicano 3D — Simon Willison documenta experimento no qual GPT-6 Astra construiu passo a passo um modelo no Blender, apresentando um fluxo de geração de imagem para 3D.
2026-09-05|406 curtidas · 30 reposts|https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s
Código aberto (2024–2025; sem atualizações recentes verificadas)
-
Lançamento de Flex.2-preview — “Texto para imagem, controle universal de linha, pose e profundidade, e inpainting em um só modelo. Ajustável com AI-Toolkit, licença Apache 2.0, 8B de parâmetros.”
2025-04-22|4 curtidas · 0 reposts|https://bsky.app/profile/ostris.com/post/3lngo5cf66k2a -
Suporte a fine-tuning LoRA para HiDream — Disponível na CLI/GUI AI-Toolkit, com mínimo de 36 GB de VRAM.
2025-04-16|3 curtidas · 0 reposts|https://bsky.app/profile/ostris.com/post/3lmxfwzrjlc2v -
Vídeo de férias de um “eu de IA” treinado com LoRA no HunyuanVideo — Também compartilha o método de treinamento com diffusion-pipe.
2024-12-25|1 curtida · 0 reposts|https://bsky.app/profile/doctordiffusion.bsky.social/post/3le5ovtycmk23 -
Lançamento de Absynth 2.0, derivado de Stable Diffusion 3.5 — “SD3.5 Lives! 🎨🤖”, distribuído por Civitai/Hugging Face.
2025-01-19|3 curtidas · 0 reposts|https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x -
Resumo semanal de Spaces da Hugging Face — Apresenta Spaces de geração de imagens abertas, como “Flux Kolors Character” e “JanusFlow 1.3B”.
2024-11-18|7 curtidas · 0 reposts|https://bsky.app/profile/reach-vb.hf.co/post/3lb7slz2ycc2j
Sinais
- Modelos fechados tiveram atualizações em sequência na primeira metade de 2026: OpenAI GPT Image 2, ByteDance Seedance 2.0, Kling 3.0, Runway Gen-4.5 e Vidu Q3 surgiram entre fevereiro e abril. Múltiplos planos, áudio sincronizado e 4K/1080p tornaram-se especificações padrão em geração de vídeo. No Bluesky, a Replicate é praticamente a única fonte primária.
- A divulgação do ecossistema open source no Bluesky praticamente parou: criadores que publicavam sobre fine-tuning de FLUX, Flex, Wan2.1 e HunyuanVideo, além da Hugging Face, deixaram de postar sobre imagem e vídeo entre o fim de 2024 e a primavera de 2025. Buscas na web confirmaram lançamentos reais de modelos com pesos abertos em 2026, como Qwen-Image-2.1, HunyuanImage 3.0 e Z-Image Turbo, mas quase não há visibilidade deles no Bluesky.
- O engajamento é pequeno em geral: excetuando contas que alcançam o público amplo de tecnologia, como Simon Willison, as postagens têm de uma a poucas dezenas de curtidas. Bluesky não parece ser um hub de informações primárias neste campo; X, Discord e Hugging Face aparentam ser os espaços principais.
Limitações
app.bsky.feed.searchPosts, a API oficial de busca, retornou HTTP 403 para todas as palavras-chave testadas, incluindo “image generation AI” e “nano banana”. A versão web,bsky.app/search, também é movida por JavaScript e não pôde ser lida por WebFetch. A solução foi consultar individualmente o feed de contas encontradas na web.- Por isso, a pesquisa não é transversal por palavras-chave, mas limitada às postagens de contas que puderam ser descobertas. É provável que contas e posts relevantes não encontrados tenham ficado de fora.
- Não foi possível resolver no Bluesky contas esperadas, como Black Forest Labs, fal.ai, Stability AI e Civitai; algumas não existem, enquanto outras, como
civitai.bsky.social, são contas vazias. - Não foram encontradas postagens primárias no Bluesky sobre os lançamentos abertos mais importantes de 2026, incluindo Qwen-Image-2.1, HunyuanImage 3.0 e Z-Image Turbo.
- Contra a meta de cerca de 20 postagens analisadas por rede, foram coletadas aproximadamente 30 candidatas de seis contas e reportados 12 insights concretos. Sem a API de busca, não foi possível ampliar a amostra com segurança.
Lemmy
Lemmy — Tendências recentes em IA para geração de imagens e vídeos
Comunidades
- !«メールアドレス» (também exibida federadamente em lemmy.world) — 5,71 mil inscritos, sendo 894 locais. Espaço para falar sobre a tecnologia favorita de geração de arte por IA, com foco em temas técnicos de pesos abertos, como integração com ComfyUI e links de HF/GitHub. É o lar de fato do tema no Lemmy.
- !«メールアドレス» — 2,36 mil inscritos, 362 locais, 3,55 mil posts, 31 usuários ativos por dia e 97 por semana. Espaço de compartilhamento de obras criadas com Stable Diffusion e modelos de pesos abertos, com publicações quase diárias.
- !share_anime_art (da família stable_diffusion_art) — Arte de IA focada em personagens de anime, como Fate, Idolmaster e Disgaea.
- !stable_diffusion_abstract / !stable_diffusion_mycology (pequenas comunidades ligadas a stable_diffusion_art) — O usuário PapaSkwat gera arte abstrata e motivos de cogumelos em SDXL local, com LoRA próprio treinado em suas pinturas a óleo e acrílico, e continua postando.
- !ai_reddit (instância desconhecida; aparentemente um crosspost automático de r/ArtificialIntelligence) — Recebe grande volume de notícias fechadas sobre fim da API do Sora, Nano Banana, Seedance, Veo, Kling e outros, mas as pontuações ficam em geral entre 0 e 1, e quase não há conversa real.
- !hackernews (comunidade espelho do Hacker News) — Traz ocasionalmente links de anúncios oficiais, como Qwen-Image-2.1 e Seedance 2.5.
- Referência: !«メールアドレス», !«メールアドレス» e !«メールアドレス» também tratam de IA, mas não são especializados em geração de imagens e vídeos.
Postagens
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — !stable_diffusion, pontuação 13, 2026-09-22. Nova versão do modelo de imagem com pesos abertos: 7B de parâmetros, saída 2K nativa, suporte a transparência RGBA e edição com até dez imagens. https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews, pontuação 2, 2026-09-20. Anúncio oficial da Qwen. https://qwen.ai/blog?id=qwen-image-2.1
- ComfyUI-Fantastic-MiniMaxH3-PromptBuilder / ComfyUI_MinimaxH3_AutoContext / comfyui-obvpm-timeline — !stable_diffusion, pontuação 1 a 6, 2026-09-16 a 09-22. Ferramentas para geração de vídeo longo e gestão de prompts do MiniMax H3 foram adicionadas rapidamente ao ecossistema ComfyUI.
- tencent/HunyuanVideo-I2V — !stable_diffusion, pontuação 5. Modelo open source de imagem para vídeo, com modelo FP8 e workflow de integração ao ComfyUI. https://huggingface.co/tencent/HunyuanVideo-I2V
- I ran the same prompt through 6 AI video models and had ~40 people blindrank the results — !ai_reddit, pontuação 1, 2026-09-17. Avaliação empírica em que Veo ficou em primeiro, Seedance 2.5 em segundo por pequena margem, e Hailuo muito atrás, em último. https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit, pontuação 1, 2026-09-20. A conclusão apresentada é que produtos de consumo chamativos falharam, enquanto soluções empresariais discretas — Synthesia, Heygen, Kling e Argil — estão gerando receita. https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Seedance 2.5, anúncio oficial — !hackernews, pontuação 3, 2026-08-01. Expansão de recursos, incluindo vídeos de 30 segundos e até 50 imagens de referência. https://seed.bytedance.com/en/blog/
- Google quietly discontinues its Earth AI feature a day after its rollout — !ai_reddit, pontuação 1, 2026-08-07. Após integrar Nano Banana 2 ao Google Earth, usuários geraram imagens falsas de desastres e conflitos em locais reais; o recurso foi retirado em 24 horas. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Nano Banana 2 Lite, página oficial — !hackernews, pontuação 1, 2026-06-30. Disponibilizado como modelo de imagem de baixo custo, por cerca de 3 ienes por imagem. https://deepmind.google.com/models/gemini-image/flash-lite/
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit, pontuação 1, 2026-05-28. Subiu à terceira posição no ranking Arena. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/
- Midjourney pivots from AI image generation to body scanning medical spa / Midjourney Medical — !technology, pontuação 58; !hackernews e !techtakes, pontuação 40, 2026-06-18 a 19. Notícia surpreendente de que Midjourney, sinônimo de geração de imagens, estaria mudando para scanners médicos “Ultrasonic CT”. No mesmo período, surgiu a notícia “Midjourney wants Hollywood studios to reveal AI usage”, relacionada à exigência de divulgação do uso de IA em estúdios de Hollywood. https://www.theregister.com/ (Midjourney medical spa), https://techcrunch.com/ (Hollywood AI usage)
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — !ai_reddit, pontuação 1, 2026-09-14. Comparação de colorização automática de mangá entre ChatGPT Images 2.5, Wan 2.7 Pro, Nano Banana Pro e Seedream 5.0 Pro; ChatGPT foi considerado melhor na preservação dos traços. https://www.reddit.com/gallery/1wfyqdy
Sinais
- O Lemmy é frio em relação à IA: em uma postagem perguntando “Where are the AI user communities on Lemmy?”, o comentário mais votado, com 36 votos, responde que é melhor procurar fora do Fediverse, porque o Lemmy tende a ser anti-IA. O principal espaço de acolhimento para usuários de modelos abertos concentra-se nas comunidades !stable_diffusion da instância db0.
- O lado open source é centrado em “fazer e usar”: !stable_diffusion prioriza nós de ComfyUI, links de modelos Hugging Face e informações técnicas; !stable_diffusion_art prioriza a exibição diária de obras geradas com Krea2 turbo, Qwen e LoRAs próprios. As pontuações são baixas, de um dígito ou pouca dezena, mas a atividade é contínua.
- As notícias fechadas são quase todas conteúdo “importado”: fim do Sora, Nano Banana, Seedance e a mudança da Midjourney para equipamentos médicos chegam por crossposts de r/ArtificialInteligence. As pontuações são geralmente 0 ou 1, sem discussão local. Lemmy por si só não acompanha bem esse tipo de notícia.
- No total, foram confirmados 12 itens de interesse, aproximadamente seis abertos e seis fechados. Como foi atingido o limite de 12 posts do playbook, a coleta foi encerrada.
Limites
- Consultas diretas à API oficial do Lemmy, como
/api/v3/communitye/api/v3/post/list, responderam HTTP 400/500. A obtenção de textos completos, bem como parte dos números de inscritos, dependeu de fragmentos recuperados por busca na web e páginas. - Certos termos produziram grande quantidade de ruído político e social ou nenhum resultado. Buscas isoladas por “Flux AI”, “Runway AI” e “Kling AI” não trouxeram resultados úteis; notícias individuais sobre Flux, da Black Forest Labs, e Runway não foram encontradas no Lemmy.
- Não foi possível identificar a instância exata das comunidades !ai_reddit, pois ela não aparecia nos resultados de busca.
- A meta de analisar cerca de 20 postagens não foi atingida estritamente, devido à própria baixa densidade de posts do Lemmy. Seguindo o playbook, a seção foi limitada a 5–12 posts, após consultar mais de 30 candidatos e remover duplicatas e ruído.
Pinterest — Notícias de IA para geração de imagens e vídeos
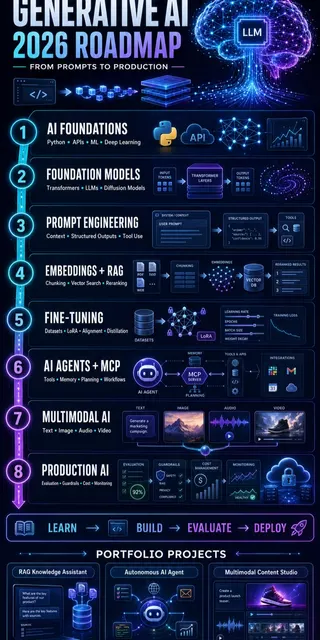
Foram coletados 50 pins sob uma única busca, “Image and Video Generation AI News”, sem divisão por gênero. Abri diretamente 20 imagens — índices 1–13, 16, 22, 25–26, 28, 31–33, 36, 38–39, 41–43, 45 e 47–49 — para verificar o que realmente mostram, pois a maior parte dos títulos é vaga ou genérica.
Temas visuais
- Miniaturas de YouTubers com “AI NEWS”: homem barbudo com expressão surpresa, ao lado de uma grade de logotipos 3D em neon de empresas como OpenAI, Google, Microsoft, Meta e Notion. É o enquadramento clássico de clickbait no estilo MrBeast aplicado a resumos de notícias de IA [1, 28].
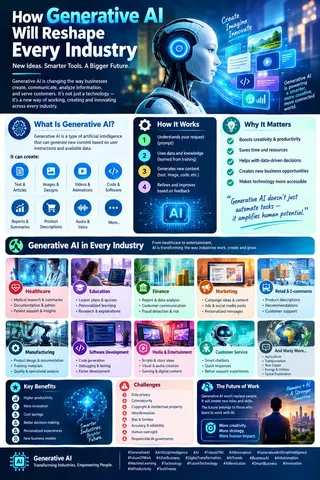
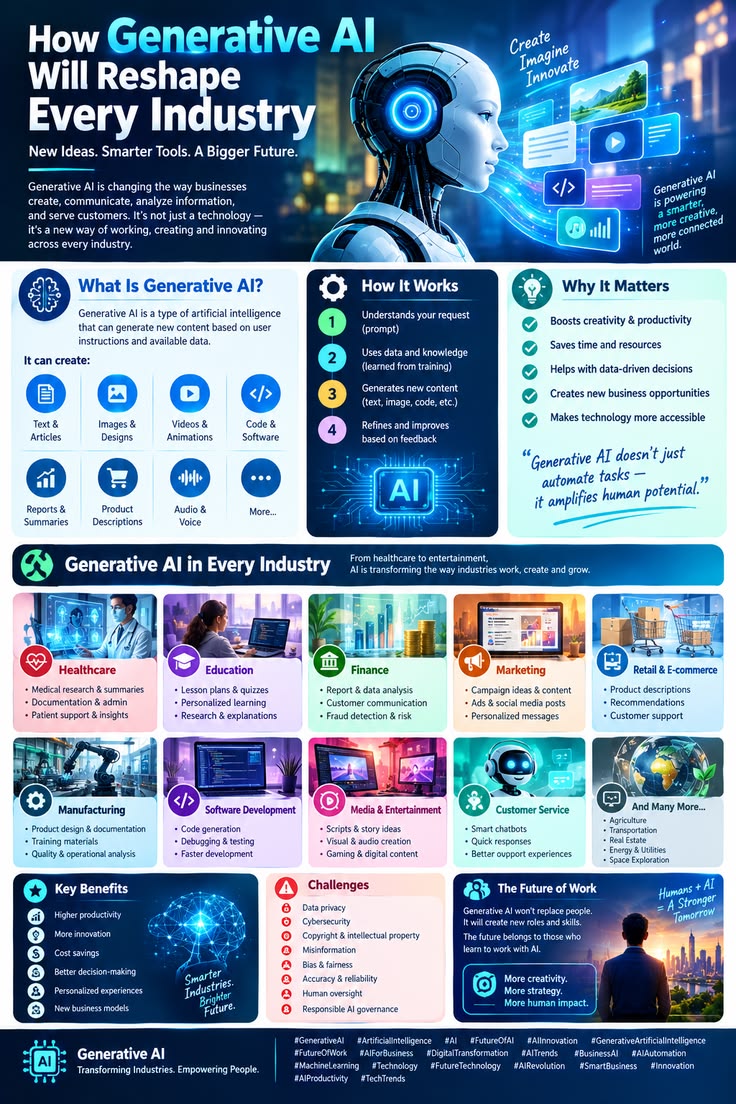
- Close-ups de robôs humanoides ou androides brancos, de olhos azuis brilhantes, usados como símbolo genérico de “IA” em histórias totalmente diferentes: detecção de notícias falsas, explicações sobre ética, infográficos de IA generativa para a indústria e até ilustrações de âncoras de notícia [3, 22, 41, 43, 48, 49].
- Infográficos publicitários SaaS em neon sobre azul-marinho: fundos azul-escuro ou pretos, caixas de ícones em contorno rosa, roxo e ciano, e tipografia condensada em títulos como “6+ BEST AI VIDEO GENERATION WEBSITES” e “AI IMAGE VIDEO — BEST QUALITY VS BEST FREE”. É o formato dominante dos pins sobre “qual aplicativo devo usar?” [4, 9, 39].
- Grades de logotipos e comparativos de ferramentas com o mesmo conjunto de produtos: Runway, Pika, Kling AI, Luma (Dream Machine), Canva AI e Hailuo AI no lado de vídeo; ChatGPT/DALL·E, Midjourney, Gemini, Adobe Firefly, Recraft, Ideogram e Krea no lado de imagem [4, 9, 39].
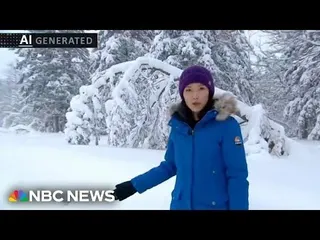
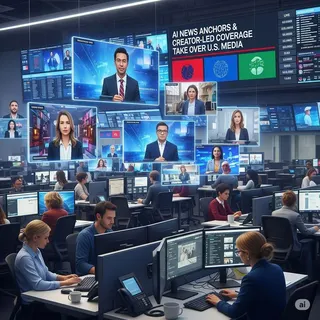
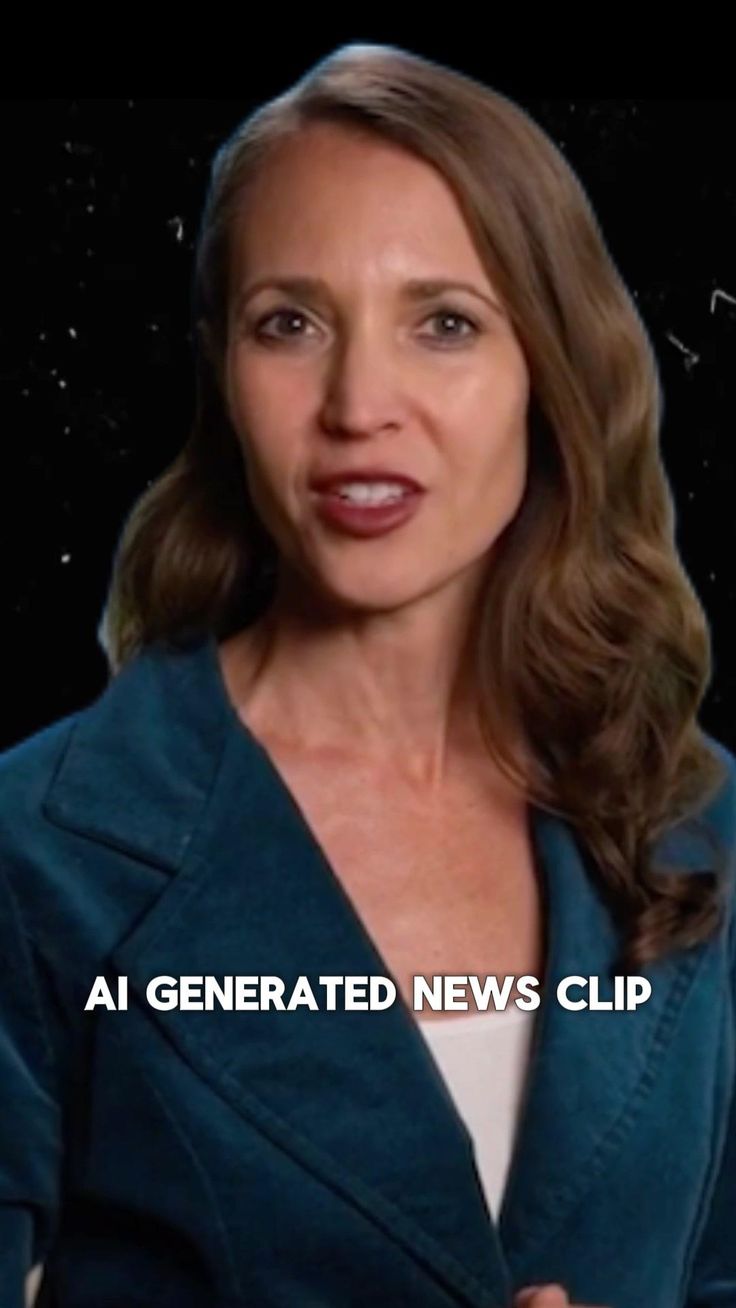
- Imagens de ansiedade em relação a notícias geradas por IA: tarjas de transmissão realistas, como “AI GENERATED” e lower-third da NBC News, aplicadas sobre âncoras e repórteres obviamente sintéticos, além de visuais de robô com celular carimbados como “FAKE”. Confiança e desinformação são um gênero visual recorrente, não apenas um tópico textual [3, 32, 45, 48].
- Macros de placas de circuito e chips com a palavra “AI” brilhando no silício, usados como imagem genérica de hardware e computação para pins sobre a presença da IA [5].
- Grades de demonstração de transferência de estilo e preservação de identidade: uma mesma foto ou vídeo-fonte recriado lado a lado como blocos de madeira, origami, Lego ou flores. É um formato concreto de demonstração de produto, parecido com uma vitrine de capacidades de Luma [2].
- Motivo de colagem ou “mural de miniaturas”: dezenas de frames pequenos gerados por IA ou cartões verticais de vídeos curtos agrupados em uma imagem alta, simbolizando a escala e o volume de conteúdo de IA inundando feeds [31, 49].
Pins notáveis
- #1 — “AI News: Anthropic Leak Shows Us The Future of AI...”: formato de miniatura reativa que cita Anthropic, ao lado de logos da OpenAI, Google e Microsoft. Mostra como notícias de laboratórios fechados são empacotadas como drama ou vazamento para gerar cliques.
- #2 — “Google announces ultra-high quality video...”: grade 3x5 que transforma o mesmo vídeo-fonte em estilos de blocos de madeira, origami, Lego e flores. É uma demonstração concreta de restilização de vídeo preservando identidade, no estilo Nano Banana/Gemini, e não apenas um slide de logotipos.
- #4 — “6+ Best AI Video Generation Websites”: infográfico que lista Runway, Pika, Kling AI, Luma, Canva e Hailuo como conjunto padrão atual para geração de vídeo, com a afirmação de que, em 2026, 80% do conteúdo online incluirá vídeo.
- #9 — “AI Image Video: Best Quality vs Best Free”: infográfico em árvore de decisão que separa pagos — ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber e Synthesia — de gratuitos — Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, Inkscape, CapCut, Pika Free e Runway Free. É um retrato útil das ferramentas que o Pinterest atualmente trata como de primeira linha.
- #11 — “Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API”: gráfico de funil em que entradas de imagem e texto convergem para um fluxo de saída, com a marca “Gemini API”. A geração fechada de vídeo com áudio é promovida como produto de API para desenvolvedores, não apenas como aplicativo de consumo.
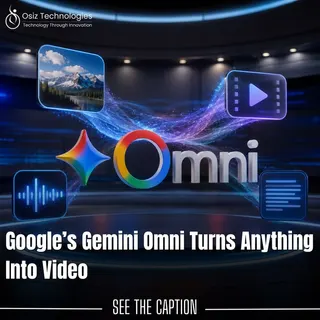
- #26 — “Google’s Gemini Omni Turns Anything Into Video”: pin de uma agência de marketing terceirizada, Osiz Technologies, reaproveitando um anúncio de capacidade do Gemini Omni. Mostra notícias de modelos fechados sendo imediatamente recicladas como conteúdo de SEO e geração de leads por empresas não relacionadas.
- #28 — “AI News: OpenAI Finally Released What We Asked For”: o mesmo criador e formato de miniatura reativa do #1, agora centrado na OpenAI; confirma ser uma série recorrente, não um caso isolado.
- #38 — “Amuse 3.0”: retrato fotorrealista de um pescador idoso, creditado como imagem gerada por IA em AMD. É um dos raros pins a ligar a geração de imagens a um fornecedor específico de hardware e à perspectiva de NPU/local, em vez de API na nuvem.
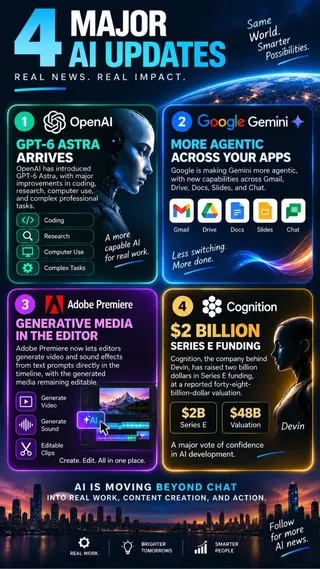
- #39 — “4 Major AI Updates”: menciona GPT-6 Astra, Gemini agentic entre aplicativos, vídeo/som generativos integrados à linha do tempo do Adobe Premiere e rodada Série E de US$ 2 bilhões da Cognition, com avaliação de US$ 48 bilhões. É o resumo de notícias fechadas mais concreto e aparentemente datado da coleta.
- #45 — “AI Generated News Clip”: uma âncora sintética identificada diretamente na imagem; a ilustração mais clara da entrada de vídeos de IA na produção de notícias e mídia, ecoando os pins #32 e #48 no estilo de tarja NBC News.
Sinais
- O que está em alta: a paisagem de ferramentas no Pinterest é dominada pelos mesmos nomes fechados — Runway, Pika, Kling, Luma/Dream Machine, Google Gemini/Veo, OpenAI e Adobe Firefly/Premiere. Modelos abertos, como Stable Diffusion, Flux, HunyuanVideo, Wan, LTX e ComfyUI, praticamente não aparecem pelo nome. O público do Pinterest tende a buscar conteúdo sobre qual app pago ou gratuito usar, além de resumos de notícias em formato reativo, e não discussões técnicas sobre modelos.
- Uma forte corrente secundária: conteúdo sobre ansiedade e confiança — carimbos “FAKE”, âncoras de IA, clipes com aparência de NBC News gerados por IA e gráficos sobre confiar ou não em uma voz. A questão da desinformação é um gênero visual de primeira ordem, tão comum quanto os comparativos de ferramentas.
- Ausências: não há nomes de modelos ou repositórios open source, marca Hugging Face, capturas de fluxos LoRA, fine-tuning ou ComfyUI, gráficos de benchmark, nem muito conteúdo sobre artigos de pesquisa e avanços técnicos em vídeo. A versão do tema no Pinterest é quase inteiramente voltada a consumidores e marketing, e não a desenvolvedores ou entusiastas.
- Vários pins são conteúdo de SEO antigo ou perene, que continua circulando — como imagens genéricas de “AI Image Generation” e listas de “Top AI Video Generators of 2025” — e não notícias desta semana. Resultados do Pinterest misturam material atemporal a conteúdo recente; por isso, a atualidade deve ser avaliada pin a pin por datas, números de versão e pistas visíveis, como “GPT-6 Astra” ou “Amuse 3.0”.
Limites
- O playbook da etapa informa que as imagens já haviam sido coletadas por um worker de navegador headless; o Pinterest não foi navegado diretamente e não foi possível buscar nada além do que consta em
pinterest.pins.mdeimages/pinterest/. - Os 50 pins vieram de uma única consulta plana, “Image and Video Generation AI News”, sem separação por gênero. Portanto, não foi possível dividir pins fechados e abertos como a estrutura de dois relatórios solicitada pelo briefing; o próprio conjunto não expõe ferramentas ou projetos abertos para relatar essa metade.
- Vinte das 50 imagens foram abertas diretamente. As 30 restantes, majoritariamente entradas genéricas “(untitled)” na tabela, não foram inspecionadas individualmente, embora seus títulos indiquem repetição dos padrões visuais já cobertos.
- Métricas de engajamento dos pins, como salvamentos e comentários, não estão expostas nos dados coletados. Assim, o que parece estar em alta é inferido da repetição visual e temática, não de um sinal direto de popularidade.
Ações recomendadas
- Acompanhar continuamente atualizações de benchmarks de modelos abertos pequenos, como Qwen-Image-2.1.
- Confirmar os termos da licença antes de classificar um modelo anunciado como “open source”.
- Incluir na próxima pesquisa a migração para serviços alternativos após o encerramento da API do Sora.
- Acrescentar buscas por nomes próprios como ComfyUI e Hugging Face para Bluesky e Pinterest, compensando a baixa visibilidade de conteúdo aberto.
- Refazer a pesquisa no X com palavras-chave específicas do tema, sem depender do painel de tendências.
Imagens coletadas

























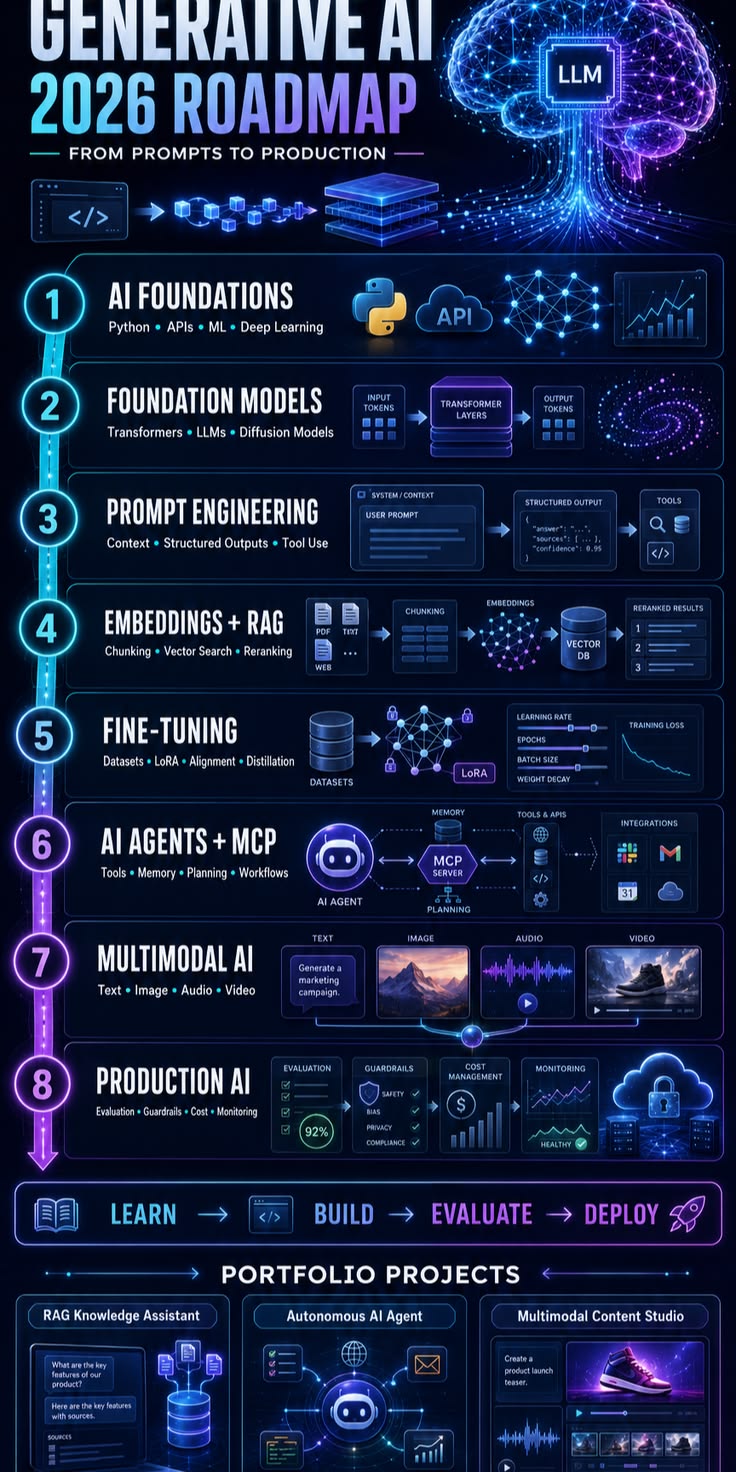







Nota sobre a qualidade dos dados
Em todas as seis plataformas, a meta do briefing — cerca de 20 itens por rede social — não foi atingida. No X, apenas oito dos 40 itens coletados se encaixavam no tema, pois a busca partiu de tendências da Croácia. No Bluesky, a API de palavras-chave retornou 403 e a coleta dependeu de contas já encontradas. No Pinterest, uma consulta única significou que material open source nem chegou a ser coletado.